Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
AWS Kamar Bersih ML
AWS Clean Rooms ML memungkinkan dua pihak atau lebih untuk menjalankan model pembelajaran mesin pada data mereka tanpa perlu berbagi data satu sama lain. Layanan ini menyediakan kontrol peningkatan privasi yang memungkinkan pemilik data untuk mengamankan data mereka dan IP model mereka. Anda dapat menggunakan model AWS yang ditulis atau membawa model khusus Anda sendiri.
Untuk penjelasan lebih rinci tentang cara kerjanya, lihatCross-account lowongan kerja.
Untuk informasi selengkapnya tentang kemampuan model ML Kamar Bersih, lihat topik berikut.
Topik
Terminologi AWS Clean Rooms ML
Penting untuk memahami terminologi berikut saat menggunakan Clean Rooms ML:
-
Penyedia data pelatihan — Pihak yang menyumbangkan data pelatihan, membuat dan mengonfigurasi model yang mirip, dan kemudian mengaitkan model yang mirip dengan kolaborasi.
-
Penyedia data benih — Pihak yang menyumbangkan data benih, menghasilkan segmen yang mirip, dan mengekspor segmen yang mirip mereka.
-
Data pelatihan — Data penyedia data pelatihan, yang digunakan untuk menghasilkan model yang mirip. Data pelatihan digunakan untuk mengukur kesamaan dalam perilaku pengguna.
Data pelatihan harus berisi ID pengguna, ID item, dan kolom stempel waktu. Secara opsional, data pelatihan dapat berisi interaksi lain sebagai fitur numerik atau kategoris. Contoh interaksi adalah daftar video yang ditonton, item yang dibeli, atau artikel yang dibaca.
-
Data benih — Data penyedia data benih, yang digunakan untuk membuat segmen yang mirip. Data benih dapat diberikan secara langsung atau dapat berasal dari hasil AWS Clean Rooms kueri. Output segmen yang mirip adalah sekumpulan pengguna dari data pelatihan yang paling mirip dengan pengguna benih.
-
Model Lookal ike — Model pembelajaran mesin dari data pelatihan yang digunakan untuk menemukan pengguna serupa di kumpulan data lain.
Saat menggunakan API, istilah model audiens digunakan secara setara dengan model yang mirip. Misalnya, Anda menggunakan CreateAudienceModel API untuk membuat model yang mirip.
-
Segmen yang mirip — Bagian dari data pelatihan yang paling mirip dengan data benih.
Saat menggunakan API, Anda membuat segmen yang mirip dengan StartAudienceGenerationJob API.
Data penyedia data pelatihan tidak pernah dibagikan dengan penyedia data benih dan data penyedia data benih tidak pernah dibagikan dengan penyedia data pelatihan. Output segmen yang mirip dibagikan dengan penyedia data pelatihan, tetapi tidak pernah dengan penyedia data benih.
Cara kerja AWS Clean Rooms ML AWS model
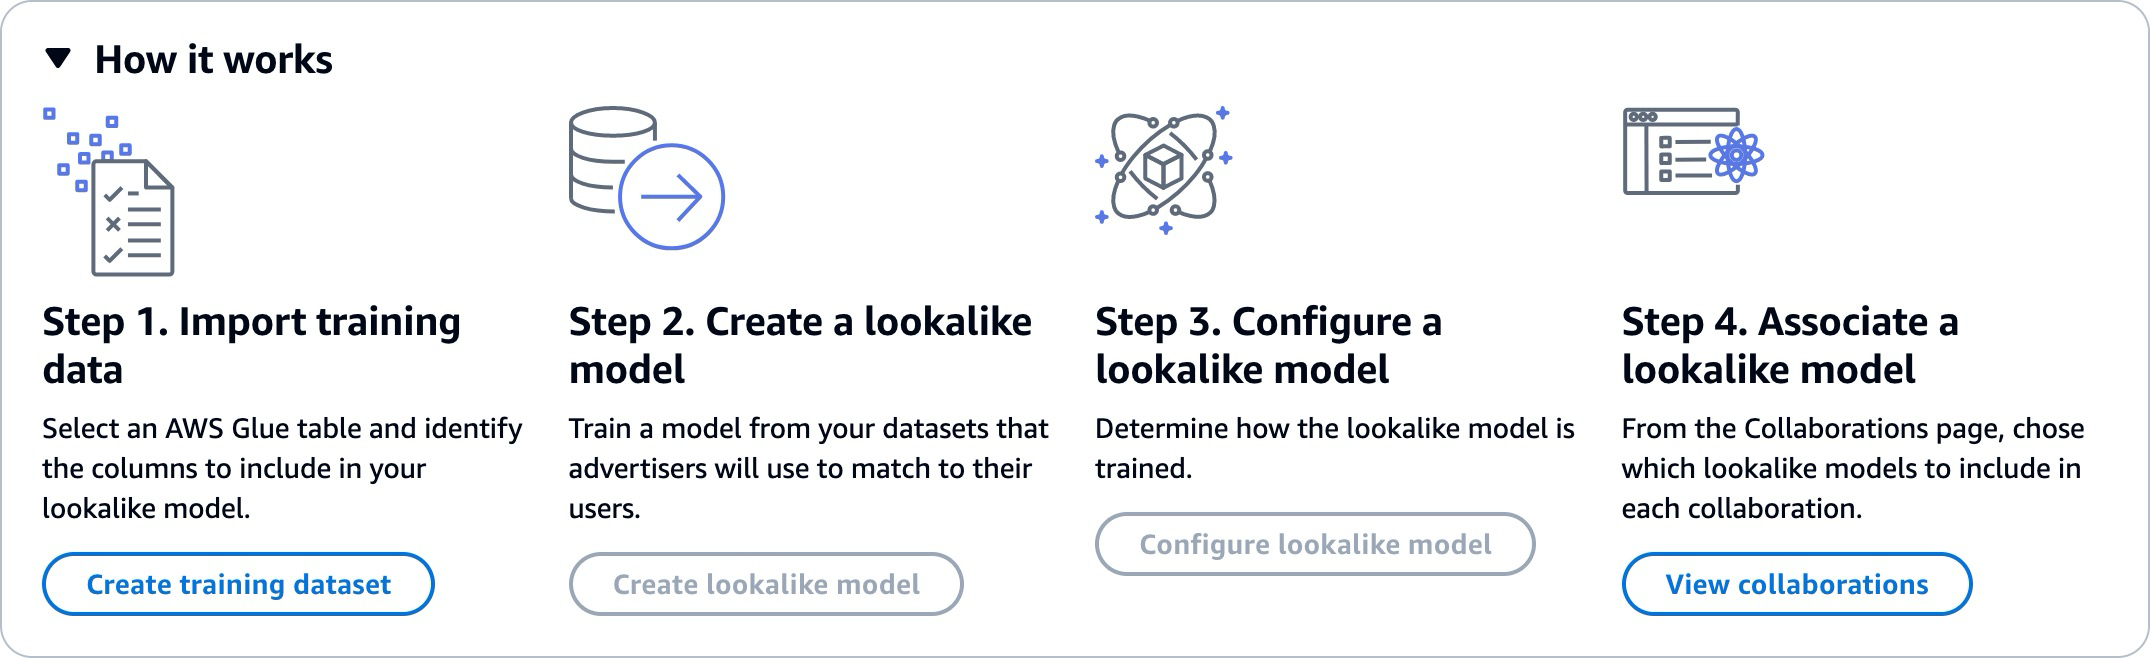
Bekerja dengan model yang mirip mengharuskan dua pihak, penyedia data pelatihan dan penyedia data benih, bekerja secara berurutan AWS Clean Rooms untuk membawa data mereka ke dalam kolaborasi. Ini adalah alur kerja yang harus diselesaikan oleh penyedia data pelatihan terlebih dahulu:
-
Data penyedia data pelatihan harus disimpan dalam tabel katalog AWS Glue data interaksi item-pengguna. Minimal, data pelatihan harus berisi kolom ID pengguna, kolom ID interaksi, dan kolom stempel waktu.
-
Penyedia data pelatihan mendaftarkan data pelatihan dengan AWS Clean Rooms.
-
Penyedia data pelatihan membuat model serupa yang dapat dibagikan dengan beberapa penyedia data benih. Model lookalike adalah jaringan saraf dalam yang dapat memakan waktu hingga 24 jam untuk dilatih. Ini tidak secara otomatis dilatih ulang dan kami sarankan Anda melatih ulang model setiap minggu.
-
Penyedia data pelatihan mengonfigurasi model yang mirip, termasuk apakah akan berbagi metrik relevansi dan lokasi Amazon S3 dari segmen keluaran. Penyedia data pelatihan dapat membuat beberapa model lookalike yang dikonfigurasi dari satu model lookalike.
-
Penyedia data pelatihan mengaitkan model audiens yang dikonfigurasi dengan kolaborasi yang dibagikan dengan penyedia data benih.
Ini adalah alur kerja yang harus diselesaikan oleh penyedia data benih selanjutnya:
-
Data penyedia data benih dapat disimpan dalam bucket Amazon S3 atau dapat berasal dari hasil kueri.
-
Penyedia data benih membuka kolaborasi yang mereka bagikan dengan penyedia data pelatihan.
-
Penyedia data benih membuat segmen serupa dari tab Clean Rooms ML pada halaman kolaborasi.
-
Penyedia data benih dapat mengevaluasi metrik relevansi, jika dibagikan, dan mengekspor segmen yang mirip untuk digunakan di luar AWS Clean Rooms.
Cara kerja AWS Clean Rooms ML dengan model khusus
Dengan Clean Rooms ML, anggota kolaborasi dapat menggunakan algoritma model kustom dockerized yang disimpan di Amazon ECR untuk bersama-sama menganalisis data mereka. Untuk melakukan ini, penyedia model harus membuat gambar dan menyimpannya di Amazon ECR. Ikuti langkah-langkah di Panduan Pengguna Amazon Elastic Container Registry untuk membuat repositori pribadi yang akan berisi model ML kustom.
Setiap anggota kolaborasi dapat menjadi penyedia model, asalkan mereka memiliki izin yang benar. Semua anggota kolaborasi dapat menyumbangkan data pelatihan, data inferensi, atau keduanya ke model. Untuk tujuan panduan ini, anggota yang menyumbangkan data disebut sebagai penyedia data. Anggota yang membuat kolaborasi adalah pembuat kolaborasi, dan anggota ini dapat berupa penyedia model, salah satu penyedia data, atau keduanya.
Di level tertinggi, berikut adalah langkah-langkah yang harus diselesaikan untuk melakukan pemodelan ML khusus:
-
Pembuat kolaborasi membuat kolaborasi dan menetapkan setiap anggota kemampuan anggota dan konfigurasi pembayaran yang tepat. Pembuat kolaborasi harus menetapkan kemampuan anggota untuk menerima keluaran model atau menerima hasil inferensi ke anggota yang sesuai dalam langkah ini karena tidak dapat diperbarui setelah kolaborasi dibuat. Untuk informasi selengkapnya, lihat Membuat dan bergabung dengan kolaborasi di AWS Clean Rooms ML.
-
Penyedia model mengonfigurasi dan mengaitkan model ML kontainer mereka dengan kolaborasi dan memastikan batasan privasi ditetapkan untuk data yang diekspor. Untuk informasi selengkapnya, lihat Mengkonfigurasi algoritma model di AWS Clean Rooms ML.
-
Penyedia data menyumbangkan data mereka untuk kolaborasi dan memastikan kebutuhan privasi mereka ditentukan. Penyedia data harus mengizinkan model untuk mengakses data mereka. Untuk informasi selengkapnya, lihat Menyumbangkan data pelatihan di AWS Clean Rooms ML dan Mengaitkan algoritma model yang dikonfigurasi di AWS Clean Rooms ML.
-
Anggota kolaborasi membuat konfigurasi ML, yang mendefinisikan ke mana artefak model atau hasil inferensi diekspor.
-
Anggota kolaborasi membuat saluran input ML yang memberikan masukan ke wadah pelatihan atau wadah inferensi. Saluran input ML adalah query yang mendefinisikan data yang akan digunakan dalam konteks algoritma model.
-
Anggota kolaborasi memanggil pelatihan model menggunakan saluran input ML dan algoritma model yang dikonfigurasi. Untuk informasi selengkapnya, lihat Membuat model terlatih di AWS Clean Rooms ML.
-
(Opsional) Model trainer memanggil pekerjaan ekspor model dan artefak model dikirim ke penerima hasil model. Hanya anggota dengan konfigurasi ML yang valid dan kemampuan anggota untuk menerima keluaran model yang dapat menerima artefak model. Untuk informasi selengkapnya, lihat Mengekspor artefak model dari AWS Clean Rooms ML.
-
(Opsional) Anggota kolaborasi memanggil inferensi model menggunakan saluran input ML, model ARN terlatih, dan algoritma model yang dikonfigurasi inferensi. Hasil inferensi dikirim ke penerima output inferensi. Hanya anggota dengan konfigurasi ML yang valid dan kemampuan anggota untuk menerima output inferensi yang dapat menerima hasil inferensi.
Berikut langkah-langkah yang harus diselesaikan oleh penyedia model:
-
Buat gambar docker Amazon ECR yang kompatibel dengan SageMaker AI. Clean Rooms ML hanya mendukung gambar docker yang kompatibel dengan SageMaker AI.
-
Setelah Anda membuat gambar docker yang kompatibel dengan SageMaker AI, dorong gambar ke Amazon ECR. Ikuti petunjuk di Panduan Pengguna Amazon Elastic Container Registry untuk membuat gambar pelatihan kontainer.
-
Konfigurasikan algoritma model untuk digunakan di Clean Room ML.
-
Berikan tautan repositori Amazon ECR dan argumen apa pun yang diperlukan untuk mengkonfigurasi algoritma model.
-
Berikan peran akses layanan yang memungkinkan Clean Rooms ML mengakses repositori Amazon ECR.
-
Kaitkan algoritma model yang dikonfigurasi dengan kolaborasi. Ini termasuk menyediakan kebijakan privasi yang mendefinisikan kontrol untuk log kontainer, log kegagalan, CloudWatch metrik, dan batasan tentang berapa banyak data yang dapat diekspor dari hasil kontainer.
-
Berikut adalah langkah-langkah yang harus diselesaikan oleh penyedia data untuk berkolaborasi dengan model ML khusus:
-
Konfigurasikan AWS Glue tabel yang ada dengan aturan analisis khusus. Hal ini memungkinkan serangkaian kueri yang telah disetujui sebelumnya atau akun yang telah disetujui sebelumnya untuk menggunakan data Anda.
-
Kaitkan tabel yang dikonfigurasi dengan kolaborasi dan berikan peran akses layanan yang dapat mengakses AWS Glue tabel Anda.
-
Tambahkan aturan analisis kolaborasi ke tabel yang memungkinkan asosiasi algoritma model yang dikonfigurasi untuk mengakses tabel yang dikonfigurasi.
-
Setelah model dan data dikaitkan dan dikonfigurasi di Clean Rooms ML, anggota dengan kemampuan untuk menjalankan kueri menyediakan kueri SQL dan memilih algoritma model yang akan digunakan.
Setelah pelatihan model selesai, anggota tersebut memulai ekspor artefak pelatihan model atau hasil inferensi. Artefak atau hasil ini dikirim ke anggota dengan kemampuan untuk menerima output model terlatih. Penerima hasil harus mengonfigurasinya MachineLearningConfiguration sebelum mereka dapat menerima output model.
