Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
AWS Clean Rooms ML
AWS Clean Rooms ML permet à deux parties ou plus d'exécuter des modèles d'apprentissage automatique sur leurs données sans avoir à partager leurs données entre elles. Le service fournit des contrôles renforçant la confidentialité qui permettent aux propriétaires de données de protéger leurs données et leur modèle IP. Vous pouvez utiliser AWS des modèles créés ou apporter votre propre modèle personnalisé.
Pour une explication plus détaillée de la façon dont cela fonctionne, voirCross-account emplois.
Pour plus d'informations sur les fonctionnalités des modèles Clean Rooms ML, consultez les rubriques suivantes.
Rubriques
Terminologie AWS Clean Rooms ML
Il est important de comprendre la terminologie suivante lors de l'utilisation de Clean Rooms ML :
-
Fournisseur de données de formation : partie qui fournit les données de formation, crée et configure un modèle similaire, puis associe ce modèle similaire à une collaboration.
-
Fournisseur de données de départ : partie qui fournit les données de départ, génère un segment similaire et exporte son segment similaire.
-
Données de formation : données du fournisseur de données de formation, qui sont utilisées pour générer un modèle similaire. Les données de formation sont utilisées pour mesurer la similitude des comportements des utilisateurs.
Les données d'entraînement doivent contenir un ID utilisateur, un ID d'élément et une colonne d'horodatage. En option, les données d'entraînement peuvent contenir d'autres interactions sous forme de caractéristiques numériques ou catégorielles. Des exemples d'interactions sont une liste de vidéos regardées, d'articles achetés ou d'articles lus.
-
Données de départ : données du fournisseur de données de départ, qui sont utilisées pour créer un segment similaire. Les données de départ peuvent être fournies directement ou provenir des résultats d'une AWS Clean Rooms requête. Le résultat du segment similaire est un ensemble d'utilisateurs issus des données de formation qui ressemble le plus aux utilisateurs initiaux.
-
Modèle similaire : modèle d'apprentissage automatique des données d'entraînement utilisé pour rechercher des utilisateurs similaires dans d'autres ensembles de données.
Lors de l'utilisation de l'API, le terme modèle d'audience est utilisé de manière équivalente à modèle similaire. Par exemple, vous utilisez l'CreateAudienceModelAPI pour créer un modèle similaire.
-
Segment similaire : sous-ensemble des données d'entraînement qui ressemble le plus aux données de départ.
Lorsque vous utilisez l'API, vous créez un segment similaire avec l'StartAudienceGenerationJobAPI.
Les données du fournisseur de données de formation ne sont jamais partagées avec le fournisseur de données de départ et les données du fournisseur de données de départ ne sont jamais partagées avec le fournisseur de données de formation. La sortie du segment similaire est partagée avec le fournisseur de données de formation, mais jamais avec le fournisseur de données de départ.
Comment fonctionne AWS Clean Rooms ML avec AWS modèles
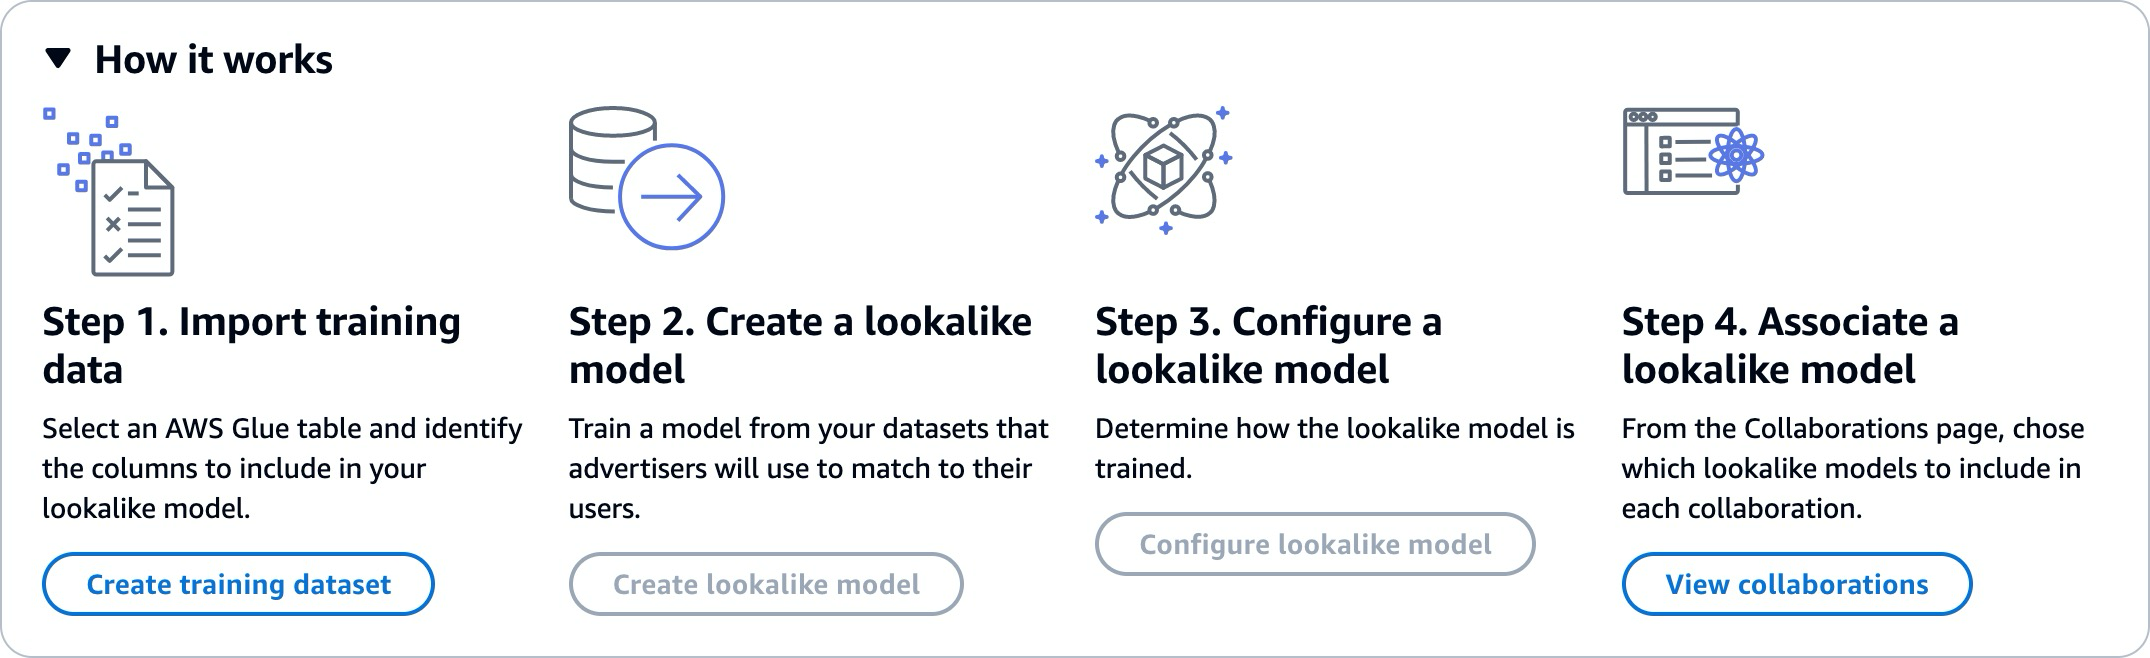
L'utilisation de modèles similaires nécessite que deux parties, un fournisseur de données de formation et un fournisseur de données de départ, travaillent de manière séquentielle AWS Clean Rooms pour intégrer leurs données dans le cadre d'une collaboration. Voici le flux de travail que le fournisseur de données de formation doit d'abord effectuer :
-
Les données du fournisseur de données de formation doivent être stockées dans un tableau de catalogue de AWS Glue données répertoriant les interactions entre les utilisateurs et les éléments. Les données de formation doivent au minimum contenir une colonne d'ID utilisateur, une colonne d'ID d'interaction et une colonne d'horodatage.
-
Le fournisseur de données de formation enregistre les données de formation auprès de AWS Clean Rooms.
-
Le fournisseur de données de formation crée un modèle similaire qui peut être partagé avec plusieurs fournisseurs de données sur les semences. Le modèle similaire est un réseau neuronal profond dont l'entraînement peut prendre jusqu'à 24 heures. Il n'est pas automatiquement recyclé et nous vous recommandons de réentraîner le modèle chaque semaine.
-
Le fournisseur de données de formation configure le modèle similaire, notamment s'il faut partager les mesures de pertinence et l'emplacement Amazon S3 des segments de sortie. Le fournisseur de données de formation peut créer plusieurs modèles similaires configurés à partir d'un seul modèle similaire.
-
Le fournisseur de données de formation associe le modèle d'audience configuré à une collaboration partagée avec un fournisseur de données de départ.
Voici le flux de travail que le fournisseur de données sur les semences doit ensuite effectuer :
-
Les données du fournisseur de données de départ peuvent être stockées dans un compartiment Amazon S3 ou peuvent provenir des résultats d'une requête.
-
Le fournisseur de données de départ ouvre la collaboration qu'il partage avec le fournisseur de données de formation.
-
Le fournisseur de données de départ crée un segment similaire à partir de l'onglet Clean Rooms ML de la page de collaboration.
-
Le fournisseur de données de départ peut évaluer les indicateurs de pertinence, s'ils ont été partagés, et exporter le segment similaire pour une utilisation externe AWS Clean Rooms.
Comment AWS Clean Rooms ML fonctionne avec les modèles personnalisés
Avec Clean Rooms ML, les membres d'une collaboration peuvent utiliser un algorithme de modèle personnalisé dockerisé qui est stocké dans Amazon ECR pour analyser conjointement leurs données. Pour ce faire, le fournisseur de modèles doit créer une image et la stocker dans Amazon ECR. Suivez les étapes du guide de l'utilisateur d'Amazon Elastic Container Registry pour créer un référentiel privé qui contiendra le modèle de machine learning personnalisé.
N'importe quel membre d'une collaboration peut être le fournisseur du modèle, à condition de disposer des autorisations appropriées. Tous les membres d'une collaboration peuvent apporter des données d'entraînement, des données d'inférence ou les deux au modèle. Aux fins de ce guide, les membres fournissant des données sont appelés fournisseurs de données. Le membre qui crée la collaboration est le créateur de la collaboration, et ce membre peut être le fournisseur du modèle, l'un des fournisseurs de données ou les deux.
Au niveau le plus élevé, voici les étapes à suivre pour effectuer une modélisation ML personnalisée :
-
Le créateur de la collaboration crée une collaboration et attribue à chaque membre les capacités de membre et la configuration de paiement appropriées. Le créateur de la collaboration doit attribuer au membre la capacité de recevoir les sorties du modèle ou de recevoir les résultats d'inférence au membre approprié au cours de cette étape, car elle ne peut pas être mise à jour une fois la collaboration créée. Pour de plus amples informations, veuillez consulter Création et participation à la collaboration dans AWS Clean Rooms ML.
-
Le fournisseur de modèles configure et associe son modèle de machine learning conteneurisé à la collaboration et s'assure que des contraintes de confidentialité sont définies pour les données exportées. Pour de plus amples informations, veuillez consulter Configuration d'un algorithme de modèle dans AWS Clean Rooms ML.
-
Les fournisseurs de données fournissent leurs données à la collaboration et veillent à ce que leurs besoins en matière de confidentialité soient spécifiés. Les fournisseurs de données doivent autoriser le modèle à accéder à leurs données. Pour plus d’informations, consultez Contribution de données de formation dans AWS Clean Rooms ML et Association de l'algorithme de modèle configuré dans AWS Clean Rooms ML.
-
Un membre de la collaboration crée la configuration ML, qui définit l'endroit vers lequel les artefacts du modèle ou les résultats d'inférence sont exportés.
-
Un membre de la collaboration crée un canal d'entrée ML qui fournit des informations au conteneur de formation ou au conteneur d'inférence. Le canal d'entrée ML est une requête qui définit les données à utiliser dans le contexte de l'algorithme du modèle.
-
Un membre de la collaboration invoque l'entraînement du modèle à l'aide du canal d'entrée ML et de l'algorithme de modèle configuré. Pour de plus amples informations, veuillez consulter Création d'un modèle entraîné dans AWS Clean Rooms ML.
-
(Facultatif) Le formateur de modèles invoque la tâche d'exportation du modèle et les artefacts du modèle sont envoyés au récepteur des résultats du modèle. Seuls les membres disposant d'une configuration ML valide et capables de recevoir la sortie du modèle peuvent recevoir des artefacts de modèle. Pour de plus amples informations, veuillez consulter Exportation d'artefacts de modèles depuis AWS Clean Rooms ML.
-
(Facultatif) Un membre de la collaboration invoque l'inférence de modèle à l'aide du canal d'entrée ML, de l'ARN du modèle entraîné et de l'algorithme de modèle configuré par inférence. Les résultats d'inférence sont envoyés au récepteur de sortie d'inférence. Seuls les membres disposant d'une configuration ML valide et capables de recevoir des résultats d'inférence peuvent recevoir des résultats d'inférence.
Voici les étapes qui doivent être effectuées par le fournisseur du modèle :
-
Créez une image Docker Amazon ECR compatible avec l' SageMaker IA. Clean Rooms ML ne prend en charge que les images Docker compatibles avec l' SageMaker IA.
-
Après avoir créé une image Docker compatible avec l' SageMaker IA, transférez-la vers Amazon ECR. Suivez les instructions du guide de l'utilisateur d'Amazon Elastic Container Registry pour créer une image de formation sur les conteneurs.
-
Configurez l'algorithme du modèle à utiliser dans Clean Rooms ML.
-
Fournissez le lien vers le référentiel Amazon ECR et tous les arguments nécessaires pour configurer l'algorithme du modèle.
-
Fournissez un rôle d'accès au service qui permet à Clean Rooms ML d'accéder au référentiel Amazon ECR.
-
Associez l'algorithme de modèle configuré à la collaboration. Cela inclut la fourniture d'une politique de confidentialité qui définit les contrôles pour les journaux des conteneurs, les journaux des défaillances, CloudWatch les mesures et les limites concernant la quantité de données pouvant être exportée à partir des résultats des conteneurs.
-
Voici les étapes que le fournisseur de données doit suivre pour collaborer avec un modèle de machine learning personnalisé :
-
Configurez une AWS Glue table existante avec une règle d'analyse personnalisée. Cela permet à un ensemble spécifique de requêtes pré-approuvées ou de comptes pré-approuvés d'utiliser vos données.
-
Associez votre table configurée à une collaboration et attribuez un rôle d'accès au service qui peut accéder à vos AWS Glue tables.
-
Ajoutez une règle d'analyse de collaboration au tableau qui permet à l'association de l'algorithme du modèle configuré d'accéder au tableau configuré.
-
Une fois le modèle et les données associés et configurés dans Clean Rooms ML, le membre capable d'exécuter des requêtes fournit une requête SQL et sélectionne l'algorithme de modèle à utiliser.
Une fois l'apprentissage du modèle terminé, ce membre lance l'exportation des artefacts d'apprentissage du modèle ou des résultats d'inférence. Ces artefacts ou résultats sont envoyés au membre avec la capacité de recevoir les résultats du modèle entraîné. Le récepteur de résultats doit le configurer MachineLearningConfiguration avant de pouvoir recevoir la sortie du modèle.
