Las traducciones son generadas a través de traducción automática. En caso de conflicto entre la traducción y la version original de inglés, prevalecerá la version en inglés.
Coincidencia de los datos de entrada mediante un flujo de trabajo de coincidencias
UN flujo de trabajo coincidente es un trabajo de procesamiento de datos que combina y compara datos de diferentes fuentes de entrada y determina qué registros coinciden basándose en diferentes técnicas de comparación. AWS Entity Resolution lee los datos de las ubicaciones especificadas, busca coincidencias entre los registros y asigna un ID de coincidencia a cada conjunto de datos coincidente.
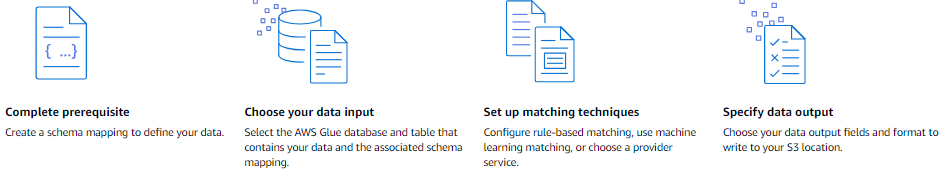
El siguiente diagrama resume cómo crear un flujo de trabajo coincidente.
Temas
Crear un flujo de trabajo coincidente basado en el aprendizaje automático
Crear un flujo de trabajo coincidente basado en el servicio del proveedor
Modificar o generar un ID de coincidencia para un flujo de trabajo de coincidencia basado en reglas
Buscando un ID de coincidencia para un flujo de trabajo de coincidencia basado en reglas
Eliminar registros de un archivo basado en reglas o ML-based flujo de trabajo coincidente
Tipos de flujo de trabajo coincidentes
AWS Entity Resolution admite tres tipos de flujos de trabajo coincidentes:
- Rule-based a juego
-
Utiliza reglas configurables para identificar los registros coincidentes basándose en la coincidencia exacta o difusa de los campos especificados. Usted define los criterios de coincidencia, como los nombres coincidentes que se escriben de manera similar o las direcciones que tienen un formato diferente.
- Coincidencias basadas en machine learning
-
Utiliza modelos de aprendizaje automático para identificar registros similares, incluso cuando los datos tienen variaciones, errores o faltan campos. Este enfoque puede detectar coincidencias más complejas que las coincidencias basadas en reglas.
- Comparación basada en el servicio del proveedor
-
Utiliza proveedores de datos de terceros para enriquecer y validar sus datos antes de compararlos. Este tipo de coincidencia no es compatible con la salida de los perfiles de clientes de Connect Customer.
Opciones de salida de datos
AWS Entity Resolution puede escribir archivos de salida de datos en:
-
Una ubicación de Amazon S3 que usted especifique
-
Conecte los perfiles de los clientes (para la deduplicación de datos de los clientes)
importante
La exportación a los perfiles de clientes de Connect no es compatible con la comparación basada en el proveedor. Para exportar a los perfiles de clientes de Connect, debe utilizar la comparación basada en reglas o el aprendizaje automático.
Puedes usar AWS Entity Resolution para procesar los datos de salida en formato hash si lo desea, lo que le ayuda a mantener el control sobre sus datos.
La siguiente tabla muestra los tres tipos de flujos de trabajo coincidentes y sus destinos de salida compatibles.
| Tipo coincidente | salidas S3 | Salida de perfiles de clientes |
|---|---|---|
| basado en reglas | ||
| basado en aprendizaje automático | ||
| basado en servicios de proveedores |
Resultados de flujo de trabajo coincidentes
Tras crear y ejecutar un flujo de trabajo coincidente, puede ver los resultados en la ubicación de S3 que haya especificado o en los perfiles de clientes de Connect Customer. Los flujos de trabajo coincidentes generan ID después de indexar los datos.
Un flujo de trabajo coincidente puede tener varias ejecuciones y los resultados (éxitos o errores) se escriben en una carpeta con el jobId como nombre.
Para cada ejecución para los destinos de salida de S3:
-
La salida de datos contiene tanto un archivo para las coincidencias satisfactorias como un archivo para los errores
-
Los resultados correctos se escriben en
successcarpeta que contiene varios archivos -
Los errores se escriben en un
errorcarpeta con varios campos
Para cada destino de salida de los perfiles de clientes de Connect Customer:
-
Los registros de clientes deduplicados se envían directamente a su instancia de Connect Customer
-
Puedes ver tu historial laboral reciente en AWS Entity Resolution consola
-
Los perfiles existentes en Connect Customer no se incluyen en el proceso de deduplicación
Después de crear y ejecutar un flujo de trabajo coincidente, puede usar la salida de coincidencia basada en reglas o coincidencia de aprendizaje automático (ML) como entrada para coincidencia basada en el servicio del proveedor o al revés para satisfacer las necesidades de su empresa.
Por ejemplo, para ahorrar los costos de suscripción de los proveedores, primero puede ejecutar coincidencia basada en reglas para encontrar coincidencias en sus datos. A continuación, puede enviar un subconjunto de registros no coincidentes a coincidencia basada en el servicio del proveedor. Ten en cuenta que si planeas exportar a perfiles de clientes, solo debes usar la comparación basada en reglas o en aprendizaje automático.
Para obtener más información sobre la solución de errores, consulte Solución de problemas de flujos de trabajo.
