Las traducciones son generadas a través de traducción automática. En caso de conflicto entre la traducción y la version original de inglés, prevalecerá la version en inglés.
Cómo empezar con la evaluación bajo demanda
Siga estos pasos para configurar y ejecutar su primera evaluación bajo demanda.
Temas
Requisitos previos
Para utilizar AgentCore las funciones OnDemand de evaluación de las evaluaciones, necesita:
-
AWS Cuenta con los permisos de IAM adecuados
-
Acceso a Amazon Bedrock con permisos de invocación de modelos
-
La búsqueda de transacciones está habilitada en CloudWatch : consulte Habilitar la búsqueda de transacciones
-
Python 3.10 o posterior instalado
-
La OpenTelemetry biblioteca: incluya
aws-opentelemetry-distro(ADOT) en su archivorequirements.txt
Marcos admitidos
Cree su agente con una biblioteca de infraestructura e instrumentación compatible con AgentCore Evaluations. Para obtener más información sobre los marcos y bibliotecas de instrumentación compatibles, consulte los marcos de agentes compatibles.
Paso 1: Cree e implemente su agente
nota
Si ya tiene un agente en funcionamiento en AgentCore Runtime, puede pasar directamente al paso 2
Crea e implementa tu agente siguiendo la guía de introducción a AgentCore Runtime. Puede encontrar más ejemplos en los ejemplos de AgentCore evaluaciones
Paso 2: Invoca a tu agente
Invoca a tu agente con el siguiente comando y visualiza los seguimientos, las sesiones y las métricas en el panel de control de GenAI Observability en. CloudWatch
Ejemplo: invoke_agent.py
import boto3
import json
import uuid

region = "region-code"
ace_demo_agent_arn = "agent-arn from step-2"

agent_core_client = boto3.client('bedrock-agentcore', region_name=region)

text_to_analyze = "Sample text to test agent for agentcore evaluations demo"

payload = json.dumps({
    "prompt": f"Can you analyze this text and tell me about its statistics: {text_to_analyze}"
})

# random session-id, you can set your own here
session_id = "test-ace-demo-session-18a1dba0-62a0-462g"

response = agent_core_client.invoke_agent_runtime(
    agentRuntimeArn=ace_demo_agent_arn,
    runtimeSessionId=session_id,
    payload=payload,
    qualifier="DEFAULT"
)

response_body = response['response'].read()
response_data = json.loads(response_body)
print("Agent Response:", response_data)
print("SessionId:", session_id)
Paso 3: Evaluar al agente
Una vez que haya hecho algunas invocaciones a su agente, estará listo para evaluarlo. Para las evaluaciones necesitamos:
-
EvaluatorId: puede ser la identificación de un evaluador incorporado o de uno creado a medida -
SessionSpans: los intervalos son los bloques de telemetría que se emiten al interactuar con una aplicación. La aplicación de nuestro ejemplo es un agente hospedado en Runtime. AgentCore-
Para la evaluación bajo demanda, necesitamos descargar los intervalos de los grupos de CloudWatch registro y usarlos para la evaluación.
-
AgentCore La CLI lo hace automáticamente y es la forma más fácil de empezar.
-
Si no utiliza la AgentCore CLI, le mostraremos cómo descargar los registros con el identificador de sesión y utilizarlos para evaluarlos mediante el AWS SDK.
-
Ejemplos de código para AgentCore la CLI y el SDK AgentCore
Los siguientes ejemplos de código muestran cómo ejecutar evaluaciones bajo demanda utilizando diferentes enfoques de desarrollo. Elija el método que mejor se adapte a sus preferencias y entorno de desarrollo.
ejemplo
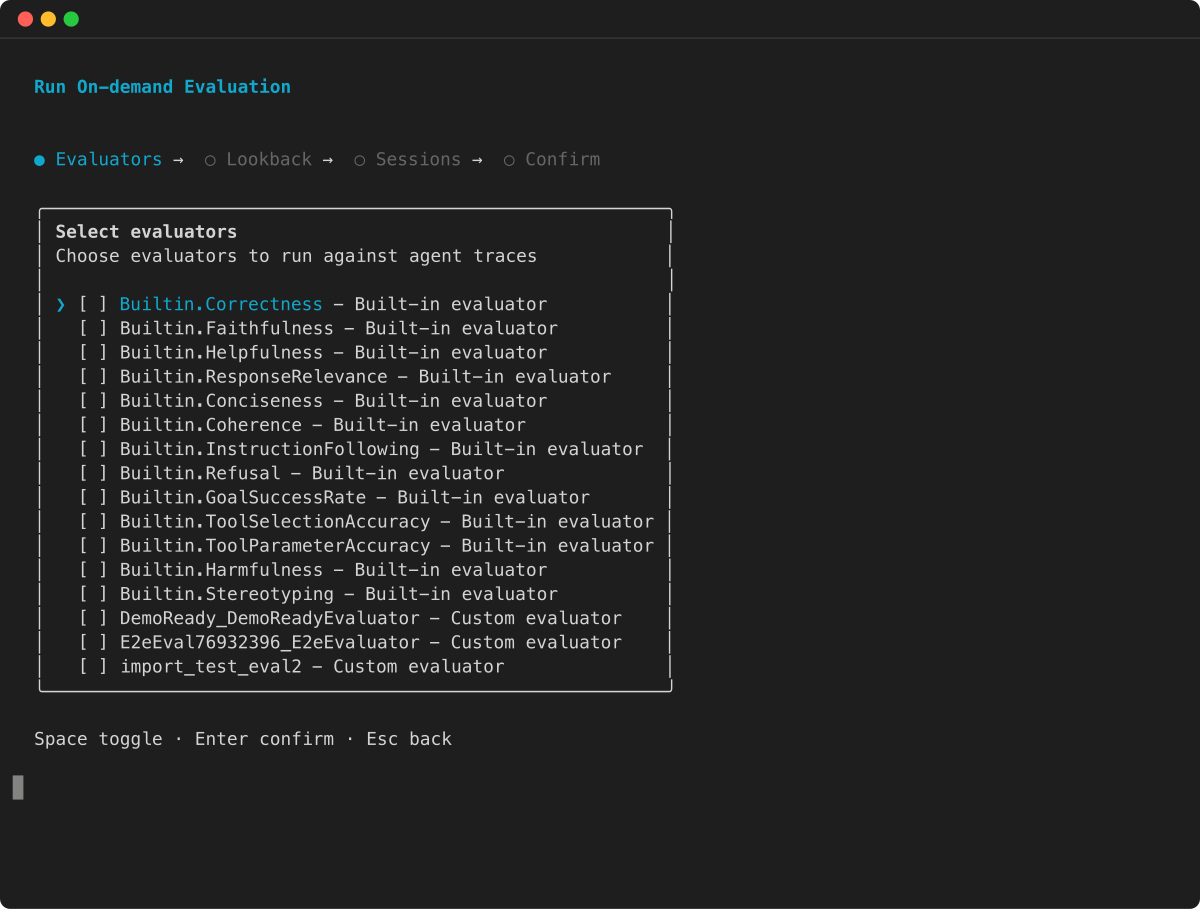
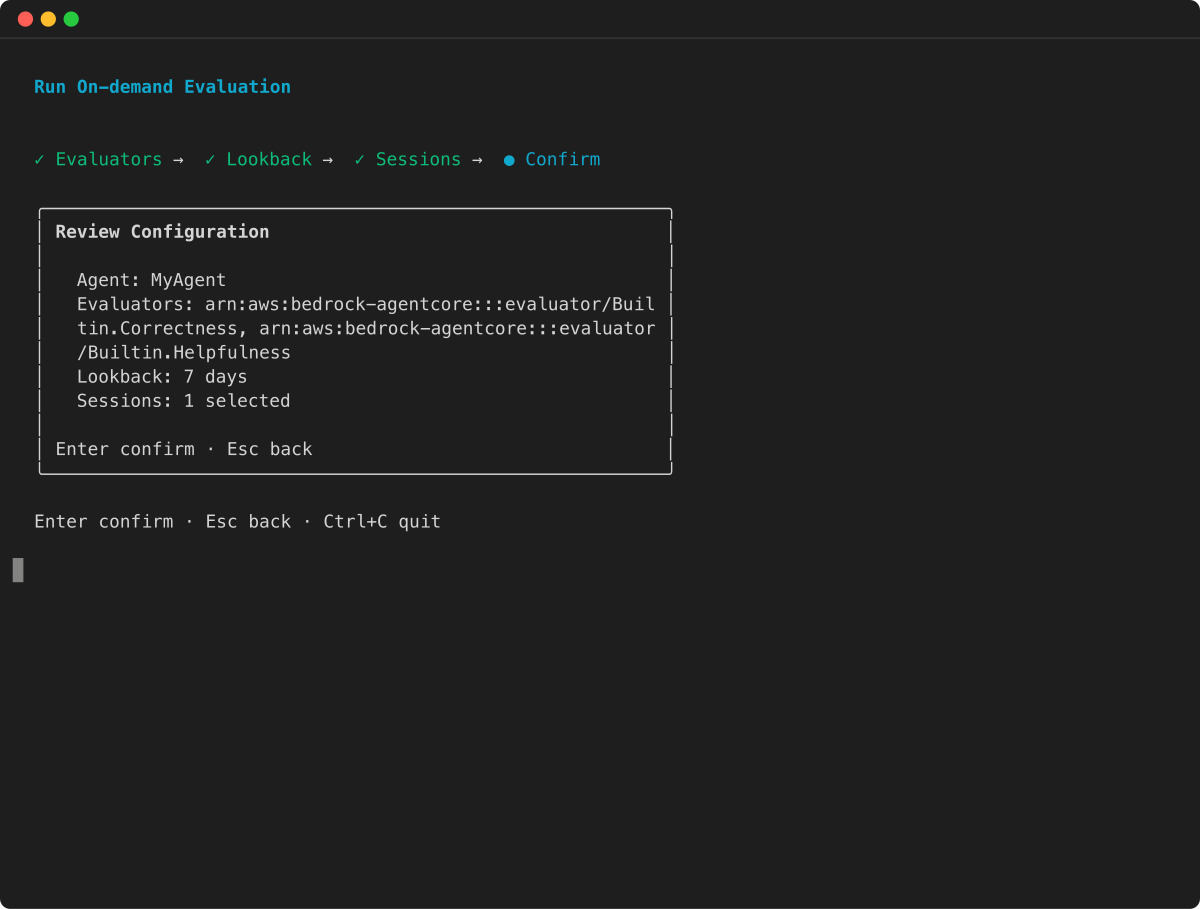
AWS SDK
Temas
Descargue los registros de intervalos desde CloudWatch
Antes de llamar a la Evaluate API, debes descargar los registros de span desde. CloudWatch Puedes usar el siguiente código de Python para hacerlo y, si lo deseas, guardarlos en un archivo JSON. Esto facilita la solicitud de la misma sesión con diferentes evaluadores.
nota
Los registros tardan un par de minutos en completarse, por lo que es posible que CloudWatch, si intenta ejecutar el siguiente script «inmediatamente» después de la invocación del agente, los registros estén vacíos o incompletos
import boto3
import time
import json
from datetime import datetime, timedelta

region = "region-code"
agent_id = "agent-id-from-step-2"
session_id = "session-id-from-step-3"

def query_logs(log_group_name, query_string):
    client = boto3.client('logs', region_name=region)
    start_time = datetime.now() - timedelta(minutes=60) # past 1 hour
    end_time = datetime.now()

    query_id = client.start_query(
        logGroupName=log_group_name,
        startTime=int(start_time.timestamp()),
        endTime=int(end_time.timestamp()),
        queryString=query_string
    )['queryId']

    while (result := client.get_query_results(queryId=query_id))['status'] not in ['Complete', 'Failed']:
        time.sleep(1)

    if result['status'] == 'Failed':
        raise Exception("Query failed")
    return result['results']

def query_session_logs(log_group_name, session_id, **kwargs):
    query = f"""fields @timestamp, @message
    | filter ispresent(scope.name) and ispresent(attributes.session.id)
    | filter attributes.session.id = "{session_id}"
    | sort @timestamp asc"""
    return query_logs(log_group_name, query, **kwargs)

def query_agent_runtime_logs(agent_id, endpoint, session_id, **kwargs):
    return query_session_logs(
        f"/aws/bedrock-agentcore/runtimes/{agent_id}-{endpoint}",
        session_id, **kwargs)

def query_aws_spans_logs(session_id, **kwargs):
    return query_session_logs("aws/spans", session_id, **kwargs)

def extract_messages_as_json(query_results):
    return [json.loads(f['value']) for row in query_results
            for f in row if f['field'] == '@message'
            and f['value'].strip().startswith('{')]

def get_session_span_logs():
    agent_runtime_logs = query_agent_runtime_logs(
        agent_id=agent_id, endpoint="DEFAULT", session_id=session_id
    )
    print(f"Downloaded {len(agent_runtime_logs)} runtime-log entries")

    aws_span_logs = query_aws_spans_logs(session_id=session_id)
    print(f"Downloaded {len(aws_span_logs)} aws/span entries")

    session_span_logs = extract_messages_as_json(aws_span_logs) + extract_messages_as_json(agent_runtime_logs)
    print(f"Returning {len(aws_span_logs) + len(agent_runtime_logs)} total records")
    return session_span_logs

# get the spans from cloudwatch
session_span_logs = get_session_span_logs()

# optional (dump in a json file for reuse)
session_span_logs_file_name = "ace-demo-session.json"
with open(session_span_logs_file_name, "w") as f:
    json.dump(session_span_logs, f, indent=2)
Llame a Evaluate
Una vez que tengas los intervalos de entrada, puedes invocar la Evaluate API. Ten en cuenta que las respuestas pueden tardar unos instantes, ya que un modelo lingüístico extenso puntúa tus trazos.
# initialise client
ace_dp_client = boto3.client('bedrock-agentcore', region_name = region)

# call evaluate
response = ace_dp_client.evaluate(
    evaluatorId = "Builtin.Helpfulness", # can be a custom evaluator id as well
    evaluationInput = {"sessionSpans": session_span_logs})

print(response["evaluationResults"])
Si utilizas la opción anterior y vuelcas los intervalos de sesión en un archivo json, también puedes ejecutar posteriormente la evaluación como se muestra a continuación
with open(session_span_logs_file_name, "r") as f:
    session_span_logs = json.load(f)

# initialise client
ace_dp_client = boto3.client('bedrock-agentcore', region_name = region)

# call evaluate
response = ace_dp_client.evaluate(
    evaluatorId = "Builtin.ToolSelectionAccuracy", # can be a custom evaluator id as well
    evaluationInput = {"sessionSpans": session_span_logs})

print(response["evaluationResults"])
Uso de objetivos de evaluación
Para evaluar un rastreo o una herramienta específicos dentro de una sesión, puedes especificar el objetivo mediante el evaluationTarget parámetro de tu solicitud.
Session-level evaluador
Dado que el servicio solo admite una sesión por evaluación, no es necesario establecer explícitamente el objetivo de la evaluación.
Trace-level evaluador
En el caso de los evaluadores a nivel de seguimiento (como Builtin.Helpfulness oBuiltin.Correctness), defina los ID de seguimiento en el parámetro: evaluationTarget
response = ace_dp_client.evaluate(
    evaluatorId = "Builtin.Helpfulness",
    evaluationInput = {"sessionSpans": session_span_logs},
    evaluationTarget = {"traceIds": ["trace-id-1", "trace-id-2"]}
)
Herramienta: evaluador de nivel de llamada
En el caso de los evaluadores a nivel de intervalo (por ejemploBuiltin.ToolSelectionAccuracy), defina los ID de intervalo en el parámetro: evaluationTarget
response = ace_dp_client.evaluate(
    evaluatorId = "Builtin.ToolSelectionAccuracy",
    evaluationInput = {"sessionSpans": session_span_logs},
    evaluationTarget = {"spanIds": ["span-id-1", "span-id-2"]}
)
Paso 4: Resultados de la evaluación
Cada llamada a la Evaluate API devuelve una respuesta que contiene una lista de los resultados del evaluador. Como una sola sesión puede incluir varios rastreos y llamadas a herramientas, estos elementos se evalúan como entidades independientes. En consecuencia, una sola llamada a la API puede devolver varios resultados de evaluación.
{
    "evaluationResults": [ {evaluation-result-1}, {evaluation-result_2},.... ]
}
Temas
Límite de resultados
El número de evaluaciones devueltas por llamada a la API está limitado a 10 resultados. Por ejemplo, si evalúa una sesión que contiene 15 seguimientos con un evaluador a nivel de seguimiento, la respuesta incluye un máximo de 10 resultados. De forma predeterminada, la API devuelve las últimas 10 evaluaciones, ya que suelen contener las que contienen el contexto más relevante para la calidad de la evaluación.
Fallos parciales
Es posible que una llamada a la API procese n evaluaciones y que una de ellas falle. Los errores pueden producirse por varios motivos, entre los que se incluyen:
-
Limitación por parte de los proveedores de modelos
-
Errores de procesamiento
-
Modelos de tiempos de espera
-
Otros problemas de procesamiento
En los casos de fallo parcial, la respuesta incluye tanto las evaluaciones exitosas como las fallidas. Los resultados fallidos incluyen un código de error y un mensaje de error para ayudarle a diagnosticar el problema.
Contexto del intervalo
Cada resultado del evaluador tiene un spanContext campo que identifica la entidad evaluada:
-
Para los evaluadores a nivel de sesión, solo está presente.
sessionId -
Para evaluadores a nivel de carrera, y están presentes.
sessionIdtraceId -
Para los evaluadores a nivel de herramienta,
sessionIdy están presentes.traceIdspanId
Ejemplo de entrada de resultados exitosa
Esta es solo una entrada. Si una sesión tiene varios seguimientos, verá varias entradas de este tipo, una para cada seguimiento. Del mismo modo, en el caso de los evaluadores a nivel de herramienta, si se utilizan varias herramientas y se proporciona un evaluador de herramientas (por ejemploBuiltin.ToolSelectionAccuracy), habrá un resultado por conjunto de herramientas.
{
  "evaluatorArn": "arn:aws:bedrock-agentcore:::evaluator/Builtin.Helpfulness",
  "evaluatorId": "Builtin.Helpfulness",
  "evaluatorName": "Builtin.Helpfulness",
  "explanation": ".... evaluation explanation will be added here ...",
  "context": {
    "spanContext": {
      "sessionId": "test-ace-demo-session-18a1dba0-62a0-462e",
      "traceId": "....trace_id......."
    }
  },
  "value": 0.83,
  "label": "Very Helpful",
  "tokenUsage": {
    "inputTokens": 958,
    "outputTokens": 211,
    "totalTokens": 1169
  }
}
Ejemplo: error al introducir un resultado
{
    "evaluatorArn": "arn:aws:bedrock-agentcore:::evaluator/Builtin.Helpfulness",
    "evaluatorId": "Builtin.Helpfulness",
    "evaluatorName": "Builtin.Helpfulness",
    "context": {
        "spanContext": {
            "sessionId": "test-ace-demo-session-18a1dba0-62a0-462e",
            "traceId": "....trace_id......."
        }
    },
    "errorMessage": ".... details of the error....",
    "errorCode": ".... name/code of the error...."
}
