本文為英文版的機器翻譯版本,如內容有任何歧義或不一致之處,概以英文版為準。
# Amazon Kinesis Data Streams 的串流資料表和 S3 交付
使用 Amazon Kinesis Data Streams,您可以將串流資料從 Kinesis 資料串流交付至兩種目的地類型:Apache Iceberg (Amazon S3 Tables) 上的串流資料表,或一般用途的 Amazon S3 儲存貯體。您不需要管理任何基礎設施,而且您可以在幾分鐘內開始交付。Amazon Kinesis Data Streams 會從串流讀取、緩衝和彙總記錄,並將其交付至您設定的目的地。交付是完全受管的 – 無需佈建連接器、消費者應用程式或運算資源。
在隨需優勢或隨需標準容量模式下執行的串流支援這些功能。您可以從串流設定交付並指定目的地。然後,Amazon Kinesis Data Streams 會自動處理擴展、重試和交付可靠性。交付不會消耗串流的讀取輸送量,也不會影響現有的消費者。
**Topics**
+ [資料交付的運作方式](#data-delivery-how-it-works)
+ [交付目的地](#data-delivery-destinations-overview)
+ [資料流程](#data-delivery-data-flow)
+ [關鍵功能](#data-delivery-capabilities)
+ [要求](#data-delivery-requirements-overview)
+ [資料交付概念](data-delivery-concepts.md)
+ [串流資料表](data-delivery-st.md)
+ [Amazon S3 一般用途交付](data-delivery-s3.md)
+ [資料交付的 IAM 許可](data-delivery-iam.md)
+ [資料交付的安全性](data-delivery-security.md)
+ [監控資料交付](data-delivery-monitoring.md)
+ [資料交付的最佳實務](data-delivery-best-practices.md)
+ [對資料交付進行故障診斷](data-delivery-troubleshooting.md)
+ [交付配額和限制](data-delivery-quotas.md)
## 資料交付的運作方式
資料交付會透過受管管道將您的 Kinesis 資料串流連線至交付目的地:
1. 您以隨需模式將資料發佈至 Kinesis 資料串流。
1. 您可以在串流`CreateChannel`上呼叫 並指定目的地 (在 Apache Iceberg 上串流資料表,或一般用途的 Amazon S3 儲存貯體)。
1. 交付會從串流讀取、緩衝記錄,並將其彙總為大小最佳的檔案。
1. 交付會在您指定的資料新鮮度視窗中,將檔案寫入您設定的目的地。
## 交付目的地
資料交付支援兩種目的地類型:
Apache Iceberg 上的串流資料表
串流資料表會持續將 Kinesis 資料串流交付至存放在 Amazon S3 資料表中的 Apache Iceberg 資料表。當資料送達時,它會自動轉換為最佳化的 Apache Parquet 格式,並具有智慧型內嵌壓縮功能,可消除小型檔案問題並降低下游查詢成本。在發佈至串流的幾分鐘內,資料會透過 Amazon Athena、Amazon EMR、Amazon Managed Service for Apache Flink 或任何支援 Apache Iceberg 的引擎進行查詢。
一般用途 Amazon S3 儲存貯體
Amazon S3 交付會將串流資料從 Kinesis 資料串流直接寫入 S3 儲存貯體。記錄會以原始來源格式交付,不會套用轉換。多個記錄會緩衝並批次處理為大小最佳的物件,具有可設定的壓縮和您透過輸出金鑰範本定義的 S3 金鑰結構。這非常適合原始日誌封存、事件重播和下游批次處理等使用案例,其中您需要耐用、低成本的串流資料儲存體,而不需要管理交付管道的額外負荷。
## 資料流程
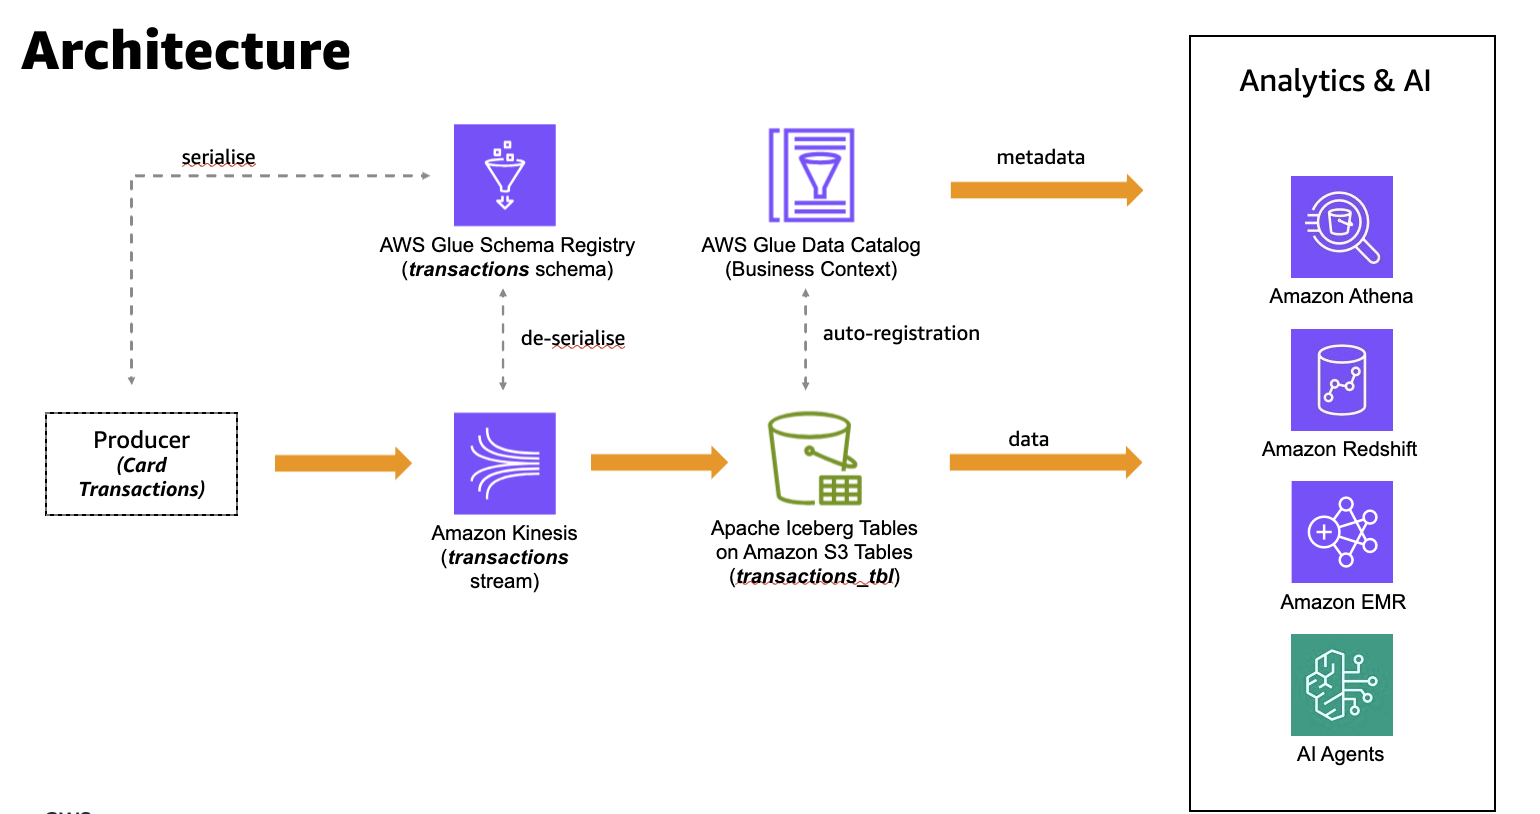
下圖顯示end-to-end資料流程,用於交付至 Apache Iceberg 上的串流資料表。圖表使用卡片交易使用案例做為範例。生產者會根據結構描述登錄檔中的 AWS Glue 結構描述序列化記錄,並將其寫入 Kinesis 資料串流。Amazon Kinesis Data Streams 會將記錄交付至 Amazon S3 Tables 上的 Apache Iceberg 資料表。如果您在 S3 Tables 中啟用分析整合,資料表中繼資料也會在 AWS Glue Data Catalog 中註冊;預設不會發生這種情況。然後,交付的資料及其中繼資料可用於分析和 AI 引擎,例如 Amazon Athena、Amazon Redshift 和 Amazon EMR。
一般用途 Amazon S3 儲存貯體的交付遵循類似的流程,有兩個差異。生產者將記錄寫入 Kinesis 資料串流,Amazon Kinesis Data Streams 會將記錄交付到您的 S3 儲存貯體。記錄會以原始來源格式交付,無需轉換,因此不需要 AWS Glue 結構描述登錄檔,也不會在 AWS Glue Data Catalog 中註冊資料表中繼資料。Amazon Kinesis Data Streams 會將記錄緩衝並批次處理為大小最佳的物件,並使用您透過輸出金鑰範本定義的 S3 金鑰結構來寫入它們。然後,交付的物件可用於下游批次處理和分析。
## 關鍵功能
+ **無伺服器自動擴展** – 使用串流輸送量自動擴展,最高可達串流的輸送量容量。沒有要佈建的運算資源。
+ **每個碎片的精確交付一次** – 碎片的記錄只會交付到目的地一次,碎片內沒有重複或遺漏。
+ **近乎即時的交付** – 可設定 5 到 15 分鐘 (300 到 900 秒) 的資料新鮮度。
+ **自動 Parquet 轉換** – 對於 Apache Iceberg 上的串流資料表, 會將串流記錄轉換為最佳化的 Apache Parquet 格式,以實現有效的分析查詢。
+ **內嵌壓縮** – 將記錄彙總為大小最佳的檔案,以分析查詢效能。
+ **加密** – 支援在目的地進行伺服器端加密的客戶受管 AWS KMS 金鑰。目的地加密不支援 `aws/kinesis` AWS 受管金鑰 (別名)。
+ **無效字母佇列** – 無法交付之記錄的失敗中繼資料 – 包括串流 ARN、碎片 ID、序號和錯誤內容 – 會寫入 S3-based無效字母佇列。
+ **CloudWatch 指標和日誌** – 透過 Amazon CloudWatch 指標監控交付的位元組、記錄計數和資料新鮮度。啟用 Amazon CloudWatch Logs 的交付記錄,以擷取交付批次詳細資訊、失敗和錯誤內容進行故障診斷。
+ **不會影響其他消費者** – 不會消耗增強的廣發插槽或共用輸送量。
## 要求
+ 您的 Kinesis 資料串流必須使用隨需標準或隨需優勢容量模式。
+ 您必須建立 IAM 服務執行角色,授予 交付許可以寫入目的地。
+ 您的目的地儲存貯體或資料表儲存貯體必須與 Kinesis 資料串流位於相同的區域。資料交付不支援任一目的地類型的跨區域交付。
+ 對於 Apache Iceberg 上的串流資料表,不支援跨帳戶交付。來源串流、目的地 S3 資料表儲存貯體和 AWS Glue 結構描述登錄檔都必須位於相同 AWS 帳戶 和相同的區域。
+ 對於一般用途的 Amazon S3 儲存貯體,僅目的地儲存貯體支援跨帳戶交付。頻道及其來源串流必須位於相同的 中 AWS 帳戶;只有目的地儲存貯體可以位於不同的 帳戶中。
+ 對於 Apache Iceberg 上的串流資料表,您必須在 Amazon S3 中設定無效字母佇列。