本文為英文版的機器翻譯版本,如內容有任何歧義或不一致之處,概以英文版為準。
設定零 ETL 整合的目標
設定零 ETL 整合的目標 AWS Glue 時, 提供多種選項。目標是 Amazon SageMaker 的加密 Amazon Redshift 資料倉儲或 Lakehouse 架構。
在選取零 ETL 整合的目標之前,需要設定下列其中一個目標資源。零 ETL 整合中目標的組態選項包括:
使用 Amazon SageMaker 湖房架構的一般用途 Amazon S3 儲存貯體。 Amazon SageMaker 請參閱 設定一般用途 S3 儲存貯體目標。
使用 Amazon SageMaker 湖房架構的 Amazon S3 Tables 儲存貯體。 Amazon SageMaker 請參閱 設定 Amazon S3 Tables 儲存貯體目標。
使用 Amazon SageMaker 湖房架構的 Amazon Redshift 受管儲存。請參閱 設定 Amazon Redshift 受管儲存目標。
Redshift 命名空間識別 Amazon Redshift 的資料倉儲。請參閱 設定 Amazon Redshift 資料倉儲目標。
注意
無法在建立後修改零 ETL 整合的目標。
設定一般用途 S3 儲存貯體目標
本節說明使用 Amazon SageMaker 的 Lakehouse 架構,在零 ETL 整合中將一般用途 S3 儲存貯體設定為目標儲存體的先決條件和設定步驟。
使用一般用途 S3 儲存與 Amazon SageMaker 的 Lakehouse 架構建立零 ETL 整合之前,您需要完成下列設定任務:
設定 AWS Glue 資料庫
提供目錄 RBAC 政策
建立目標 IAM 角色
將目標角色 KMS (選用) 和連線 (選用) 與目標資源建立關聯
(選用) 設定目標資料表屬性
設定 AWS Glue 資料庫
若要使用 Amazon S3 一般用途儲存貯體位置在 Data Catalog 中設定目標資料庫:
在 AWS Glue 主控台首頁中,選取 Data Catalog 下的資料庫。
選擇右上角的新增資料。如果已建立資料庫,請確保已針對資料庫設定具有 Amazon S3 URI 的位置。
輸入名稱和位置 (Amazon S3 URI)。請注意,零 ETL 整合需要位置。完成後,按一下建立資料庫。
注意
一般用途 Amazon S3 儲存貯體必須與 AWS Glue 資料庫位於相同的區域。
如需在 中建立新資料庫的資訊 AWS Glue,請參閱 Data Catalog 入門。
也可以使用 create-database CLI 在 AWS Glue中建立資料庫。請注意,需要 --database-input 中的 LocationUri。
最佳化處理 Iceberg 資料表
在 AWS Glue 目標資料庫中由 建立資料表後,您可以啟用壓縮以加速 Amazon Athena 中的查詢。如需有關設定壓縮資源 (IAM 角色) 的資訊,請參閱資料表最佳化先決條件。
如需在整合建立的 AWS Glue 資料表上設定壓縮的詳細資訊,請參閱最佳化 Iceberg 資料表。
提供目錄資源型存取 (RBAC) 政策
對於使用 AWS Glue 資料庫的整合,請將下列許可新增至目錄 RBAC 政策,以允許來源和目標之間的整合。
注意
對於跨帳戶整合,建立整合角色政策和目錄資源政策的使用者都需要在資源glue:CreateInboundIntegration上允許 。對於相同帳戶,在資源上允許 glue:CreateInboundIntegration 的資源政策或角色政策就足夠。這兩種情況仍然需要允許 glue.amazonaws.com 進行 glue:AuthorizeInboundIntegration。
可以在 Data Catalog 下存取目錄設定。然後提供下列許可,並填寫缺少的資訊。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Principal": {
        "AWS": [
            "arn:aws:iam::123456789012:user/Alice"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:CreateInboundIntegration"
      ],
      "Resource": [
          "arn:aws:glue:us-east-1:111122223333:catalog",
          "arn:aws:glue:us-east-1:111122223333:database/database-name"
      ],
      "Condition": {
        "StringLike": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    },
    {
      "Principal": {
        "Service": [
          "glue.amazonaws.com"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:AuthorizeInboundIntegration"
      ],
      "Resource": [
          "arn:aws:glue:us-east-1:111122223333:catalog",
          "arn:aws:glue:us-east-1:111122223333:database/database-name"
      ],
      "Condition": {
        "StringEquals": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    }
  ]
}
建立目標 IAM 角色
建立具有下列許可和信任關係的目標 IAM 角色:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Action": "s3:ListBucket",
            "Resource": "arn:aws:s3:::amzn-s3-bucket",
            "Effect": "Allow"
        },
        {
            "Action": [
                "s3:GetObject",
                "s3:PutObject",
                "s3:DeleteObject"
            ],
            "Resource": "arn:aws:s3:::amzn-s3-demo-bucket/prefix/*",
            "Effect": "Allow"
        },
        {
            "Action": [
                "glue:GetDatabase"
            ],
            "Resource": [
                "arn:aws:glue:us-east-1:111122223333:catalog",
                "arn:aws:glue:us-east-1:111122223333:database/database-name"
            ],
            "Effect": "Allow"
        },
        {
            "Action": [
                "glue:CreateTable",
                "glue:GetTable",
                "glue:GetTables",
                "glue:DeleteTable",
                "glue:UpdateTable",
                "glue:GetTableVersion",
                "glue:GetTableVersions",
                "glue:GetResourcePolicy"
            ],
            "Resource": [
                "arn:aws:glue:us-east-1:111122223333:catalog",
                "arn:aws:glue:us-east-1:111122223333:database/database-name",
                "arn:aws:glue:us-east-1:111122223333:table/database-name/*"
            ],
            "Effect": "Allow"
        },
        {
            "Action": [
                "cloudwatch:PutMetricData"
            ],
            "Resource": "*",
            "Condition": {
                "StringEquals": {
                    "cloudwatch:namespace": "AWS/Glue/ZeroETL"
                }
            },
            "Effect": "Allow"
        },
        {
            "Action": [
                "logs:CreateLogGroup",
                "logs:CreateLogStream",
                "logs:PutLogEvents"
            ],
            "Resource": "*",
            "Effect": "Allow"
        }
    ]
}
新增下列信任政策,以允許 AWS Glue 服務擔任該角色:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "glue.amazonaws.com"
      },
      "Action": "sts:AssumeRole"
    }
  ]
}
將目標角色 KMS (選用) 和連線 (選用) 與目標資源建立關聯
將上述目標角色與目標資源建立關聯,即 AWS Glue 資料庫。或者,可以為目標 AWS Glue 資料庫設定用於在目標 iceberg 資料表中儲存之前加密資料的 KMS,以及用於存取 S3 儲存貯體的連線 ARN。這將允許 AWS Glue 使用提供的角色存取目標 S3 位置上的資料,並選擇性地使用提供的 KMS 金鑰加密。如果目標 S3 儲存貯體設定為可使用特定 VPC 存取,則連線 ARN 可以建立關聯, AWS Glue 以允許 在該 VPC 內執行處理。如需設定 VPC 的詳細資訊,請參閱建立 VPC。
或使用 AWS Glue CLI / API:
aws glue create-integration-resource-property \ --resource-arn arn:aws:glue:us-east-1:123456789012:database/database-name\ --target-processing-properties '{"RoleArn": "arn:aws:iam::123456789012:role/gmi_target_role"}' \ --region us-east-1
(選用) 設定目標資料表屬性
或者,可以為要同步到目標的目標資料表設定目標資料表屬性。
您可以在 AWS Glue 主控台整合建立工作流程的輸出設定區段中設定這些設定:

選取指定自訂分割區索引鍵時,您可以設定分割區索引鍵及其函數和轉換規格:

如果來源和目標位於相同 帳戶中,則此組態可以做為從 AWS Glue 主控台 UI 建立整合工作流程的一部分來完成。但是,如果目標位於不同的帳戶中,則必須先完成此組態,才能建立整合。使用 CLI 或 API 時,在叫用 Create-Integration API 之前應該執行此操作,即使來源和目標都位於相同的帳戶。 AWS Glue 主控台 UI 只會針對相同的帳戶案例封裝此 API 呼叫。
如果未設定,則同步資料表時將使用預設值。您也可以在整合建立之後隨時變更此組態。
注意
如果此屬性在整合建立後更新,則當更新的組態與現有的組態衝突時,可能會觸發完整的資料表重新同步。例如,將資料表 "un-nesting" 從 'No-Unnest' 更新為 'Full-Unnest',或變更分割區欄。
目標資料表屬性衝突
兩件事會識別一組目標資料表屬性:目標資源 ARN 和來源資料表名稱。目標資源是一般用途 Amazon S3 目標的 AWS Glue 資料庫。對於 Amazon S3 Tables 目標,它是 Amazon S3 Tables 目錄。目標資源和來源資料表的每個組合一次只能與一個整合相關聯。因此,兩個整合無法將相同的來源資料表寫入相同的目標資源。如果您為相同的組合建立第二個整合, 會 AWS Glue 識別衝突並防止衝突。這可防止一個整合覆寫另一個整合的資料。
AWS Glue 無論您使用 主控台、 CLI 或 API, 都會強制執行此規則。在 主控台中,輸出設定步驟會在繼續之前偵測衝突,因此您可以在建立整合之前解決它們。這適用於 Amazon DynamoDB 等單一資料表來源,以及 SaaS 應用程式等多資料表來源。來源資料表的目標屬性只能由一個整合擁有,因此在您解決衝突之前,另一個整合已宣告的來源資料表不會複寫。
主控台顯示衝突的方式取決於來源資料表的數量:
對於多資料表來源,主控台會以兩欄顯示每個來源資料表的狀態:必要動作和備註。這些資料欄顯示哪些資料表需要注意。
對於單一資料表來源,主控台會在內嵌提醒中顯示相同的資訊。只有一個來源資料表。
下列螢幕擷取畫面顯示多資料表 (SaaS) 輸出設定表格,其中包含必要動作和備註欄。

主控台會在多資料表來源的備註欄中顯示訊息,或在單一資料表來源的內嵌提醒中顯示訊息。適用下列任何條件時,它會標記來源資料表:
另一個整合已將來源資料表寫入選取的目標資源。選擇不同的目標資源,或從其他整合中移除來源資料表。
輸出資料表名稱已在不同的來源資料表的所選目標資源上註冊。輸入不同的輸出資料表名稱。
兩個或多個來源資料表對應至相同的輸出資料表名稱。這適用於多資料表 SaaS 來源。為每個來源資料表提供自己的輸出資料表名稱。
輸出資料表名稱無效。輸入有效名稱,只包含小寫字母、數字和底線,且不超過 255 個字元。對於 Amazon S3 Tables 目錄目標,名稱開頭不能是底線。
AWS Glue 會偵測輸出設定的並行變更。
並行變更未封鎖
並行變更表示另一個使用者在您工作時更新了相同的輸出設定。與此清單中的其他條件不同,並行變更不會封鎖您。重新整理以取得最新的設定,或繼續目前的設定。
使用 CLI 或 API:
aws glue create-integration-table-properties \ --resource-arn arn:aws:glue:us-east-1:123456789012:database/database-name\ --table-nametable-name\ --target-table-config '{ "UnnestSpec":"TOPLEVEL"|"FULL"|"NOUNNEST", "PartitionSpec": [ { "FieldName":"string", "FunctionSpec":"string", "ConversionSpec":"string"} ... ], "TargetTableName":"string" }' \ --region us-east-1
使用一般用途 Amazon S3 儲存貯體儲存體設定 Amazon SageMaker 的 Lakehouse 架構之後,您可以繼續設定與您的目標的整合完成整合設定。 Amazon S3
設定 Amazon S3 Tables 儲存貯體目標
本節說明使用 Amazon SageMaker 的 Lakehouse 架構,將 Amazon S3 Tables 設定為零 ETL 整合目標的先決條件和設定步驟。 Amazon SageMaker
在建立以 Amazon S3 Tables 作為目標的零 ETL 整合之前,需要完成下列設定任務:
設定 Amazon S3 資料表儲存貯體 (和分析服務整合)
提供目錄 RBAC 政策
建立目標 IAM 角色
將目標角色 KMS (選用) 和連線 (選用) 與目標資源建立關聯
(選用) 設定目標資料表屬性
設定 Amazon S3 資料表儲存貯體 (與分析服務整合)
遵循 Amazon S3 Tables 入門中的指示,在您的帳戶中建立 S3 Tables 儲存貯體。
請依照下列指示啟用 Analytics 與 S3-Table 儲存貯體的整合:將 AWS 服務與 Amazon S3 Tables 整合。
這將在 中建立新的 S3-Table Catalog AWS Lake Formation。
提供目錄 RBAC 政策
必須將下列許可新增至目錄 RBAC 政策,以允許來源和 Amazon S3 Tables 目錄目標之間的整合。
Target AWS Glue Catalog 資源政策需要包含 AWS Glue 的服務許可AuthorizeInboundIntegration。此外,建立整合的來源主體或目標 AWS Glue 資源政策都需要CreateInboundIntegration許可。
注意
對於跨帳戶案例,來源主體和目標 AWS Glue 目錄資源政策都需要包含資源的glue:CreateInboundIntegration許可。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Principal": {
        "AWS": [
            "arn:aws:iam::123456789012:user/Alice"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:CreateInboundIntegration"
      ],
      "Resource": [
          "arn:aws:glue:us-east-1:111122223333:catalog/s3tablescatalog/*"
      ],
      "Condition": {
        "StringLike": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    },
    {
      "Principal": {
        "Service": [
          "glue.amazonaws.com"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:AuthorizeInboundIntegration"
      ],
      "Resource": [
      "arn:aws:glue:us-east-1:111122223333:catalog/s3tablescatalog/*"
      ],
      "Condition": {
        "StringEquals": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    }
  ]
}
注意
s3tablescatalogs3tablescatalog。
建立目標 IAM 角色
建立具有下列許可和信任關係的目標 IAM 角色:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Action": [
        "s3tables:ListTableBuckets",
        "s3tables:GetTableBucket",
        "s3tables:GetTableBucketEncryption",
        "s3tables:GetNamespace",
        "s3tables:CreateNamespace",
        "s3tables:ListNamespaces",
        "s3tables:CreateTable",
        "s3tables:DeleteTable",
        "s3tables:GetTable",
        "s3tables:GetTableEncryption",
        "s3tables:ListTables",
        "s3tables:GetTableMetadataLocation",
        "s3tables:UpdateTableMetadataLocation",
        "s3tables:GetTableData",
        "s3tables:PutTableData"
      ],
      "Resource": "arn:aws:s3tables:us-east-1:111122223333:bucket/s3-table-bucket",
      "Effect": "Allow"
    },
    {
      "Action": [
        "cloudwatch:PutMetricData"
      ],
      "Resource": "*",
      "Condition": {
        "StringEquals": {
          "cloudwatch:namespace": "AWS/Glue/ZeroETL"
        }
      },
      "Effect": "Allow"
    },
    {
      "Action": [
        "logs:CreateLogGroup",
        "logs:CreateLogStream",
        "logs:PutLogEvents"
      ],
      "Resource": "*",
      "Effect": "Allow"
    }
  ]
}
在目標 IAM 角色中新增下列信任政策,以允許 AWS Glue Service 擔任該角色:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "glue.amazonaws.com"
      },
      "Action": "sts:AssumeRole"
    }
  ]
}
注意
請確保 S3-Tables 儲存貯體資源政策中沒有此目標 IAM 角色的明確 DENY 陳述式。明確的 DENY 會覆寫所有 ALLOW 許可,並防止整合正常運作。
將目標角色 KMS (選用) 和連線 (選用) 與目標資源建立關聯
將上述目標角色與目標資源建立關聯。或者,可以設定用於在目標 iceberg 資料表中存放之前加密資料的 KMS,以及用於存取目標 S3 儲存貯體的連線 ARN。如果目標 S3 儲存貯體設定為可使用特定 VPC 存取,則連線 ARN 可以建立關聯, AWS Glue 以允許 在該 VPC 內執行處理。如需設定 VPC 的詳細資訊,請參閱建立 VPC。
使用 AWS Glue CLI/API:
aws glue create-integration-resource-property \ --resource-arn arn:aws:glue:us-east-1:123456789012:catalog/s3tablescatalog/S3 table bucket name\ --target-processing-properties '{ "RoleArn": "arn:aws:iam::123456789012:role/target_role" }' \ --region us-east-1
(選用) 設定目標資料表屬性
或者,可以為要同步到目標的目標資料表設定目標資料表屬性。適用相同規則,如一般用途 S3 目標一節所述。如需衝突條件的完整清單,請參閱 目標資料表屬性衝突。
使用 CLI 或 API:
aws glue create-integration-table-properties \ --resource-arn arn:aws:glue:us-east-1:123456789012:catalog/s3tablescatalog/S3 table bucket name\ --table-nametable-name\ --target-table-config '' \ --region us-east-1
使用 Amazon SageMaker 的 Lakehouse 架構設定 Amazon S3-Tables 儲存體後,您可以繼續設定與您的目標的整合完成整合設定。 Amazon SageMaker
設定 Amazon Redshift 受管儲存目標
本節說明使用 Amazon SageMaker 的 Lakehouse 架構,將 Amazon Redshift 受管儲存 (RMS) 設定為零 ETL 整合目標的先決條件和設定步驟。
使用 Redshift 受管儲存與 Amazon SageMaker 的 Lakehouse 架構建立零 ETL 整合之前,您需要完成下列設定任務:
設定 Amazon Redshift 叢集或 Serverless 工作群組
註冊與 Lake Formation 的 Amazon Redshift 整合
在 Lake Formation 中建立受管目錄
設定 IAM 許可
設定 Amazon Redshift 受管儲存
若要設定零 ETL 整合的 Amazon Redshift 受管儲存:
建立或使用現有的 Amazon Redshift 叢集或 Serverless 工作群組。確定目標 Amazon Redshift 工作群組或叢集已開啟
enable_case_sensitive_identifier參數,以使整合成功。如需啟用區分大小寫的詳細資訊,請參閱 Amazon Redshift 管理指南中的為您的資料倉儲開啟區分大小寫。將整合從 Redshift 註冊到 AWS Lake Formation中的目錄。請參閱將 Amazon Redshift 叢集和命名空間註冊至 Data Catalog。
在 中建立聯合或受管目錄 AWS Lake Formation。如需詳細資訊,請參閱:
設定目標角色的 IAM 許可。此角色需要用於存取 Redshift 和 Lake Formation 資源的許可。角色至少應擁有:
存取 Redshift 叢集或工作群組的許可
存取 Lake Formation 目錄的許可
在目錄中建立和管理資料表的許可
CloudWatch 和 CloudWatch Logs 監控許可
使用 Amazon Redshift 受管儲存體設定 Amazon SageMaker Lakehouse 目錄之後,您可以繼續設定與您的目標的整合完成整合設定。
設定 Amazon Redshift 資料倉儲目標
本節說明將 Amazon Redshift 資料倉儲設定為零 ETL 整合目標的先決條件和設定步驟。
在建立與 Amazon Redshift 資料倉儲目標的零 ETL 整合之前,您需要完成下列設定任務:
設定 Amazon Redshift 叢集或 Serverless 工作群組
設定區分大小寫功能
設定 IAM 許可
設定 Amazon Redshift 資料倉儲
若要設定零 ETL 整合 Amazon Redshift 的資料倉儲:
導覽至 Amazon Redshift 主控台
,然後按一下建立叢集或使用現有的叢集。若要建立 Amazon Redshift 叢集,請參閱建立叢集。對於 Amazon Redshift Serverless,按一下建立工作群組。若要建立 Amazon Redshift Serverless 工作群組,請參閱建立包含命名空間的工作群組。 如果建立新的叢集,請選擇適當的叢集大小,並確保叢集已加密。對於 Serverless,根據您的需求設定工作群組設定。
請確定目標 Amazon Redshift 工作群組或叢集已開啟
enable_case_sensitive_identifier參數,以使整合成功。如需啟用區分大小寫的詳細資訊,請參閱《Amazon Redshift 管理指南》中的為您的資料倉儲開啟區分大小寫。設定 IAM 許可以允許零 ETL 整合存取 Amazon Redshift 您的資料倉儲。您將需要建立具備下列許可的 IAM 角色:
存取 Amazon Redshift 叢集或工作群組的許可
在 中建立和管理資料庫和資料表的許可 Amazon Redshift
CloudWatch 和 CloudWatch Logs 監控許可
Amazon Redshift 工作群組或叢集設定完成後,您需要為零 ETL 整合設定資料倉儲。如需詳細資訊,請參閱《Amazon Redshift 管理指南》中的零 ETL 整合入門。
注意
使用 Amazon Redshift 資料倉儲做為目標時,整合會在指定的資料庫中建立結構描述,以存放複寫的資料。結構描述名稱衍生自整合名稱。
注意
目標 Amazon Redshift 工作群組或叢集必須開啟 enable_case_sensitive_identifier 參數,才能成功整合。
設定 Amazon Redshift 資料倉儲之後,您可以繼續設定與您的目標的整合完成整合設定。
設定與您的目標的整合
設定來源和目標資源之後,請依照下列步驟完成整合設定:
導覽至「零 ETL 整合」頁面並開始整合建立工作流程。
選取先前步驟中設定的來源資源。
選取或指定先前步驟中設定的目標資源 (相同帳戶或跨帳戶)。
選取先前設定的目標 IAM 角色。
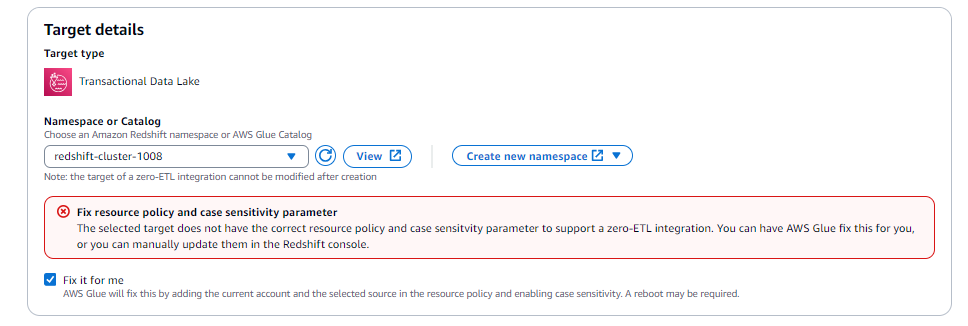
選取「為我修正」選項 (僅當目標位於相同帳戶中時可用)。
對於一般 Amazon S3 (AWS Glue 資料庫) 和 S3-Table (目錄) 目標,這會:
在目標目錄資源政策上套用授權的服務主體。
將授權 AWS Glue 來源主體 ARN 套用至目標目錄資源政策。
對於 Amazon Redshift 目標,這將:
在 Amazon Redshift 叢集或 Serverless 工作群組上套用授權的服務主體。
將授權的 AWS Glue 來源 ARN 套用至 Amazon Redshift 叢集或無伺服器工作群組。
將新的參數群組與
enable_case_sensitive_identifier = true建立關聯。
使用下列項目透過 API 或 CLI 建立整合:CreateIntegration API。
