本文為英文版的機器翻譯版本,如內容有任何歧義或不一致之處,概以英文版為準。
檢視資料品質分數和異常
在本節中,我們將探索資料品質儀表板及其提供的不同功能。
視覺化並了解高階資料品質指標和趨勢
任務成功後,選擇資料品質索引標籤以檢視資料品質分數和異常。
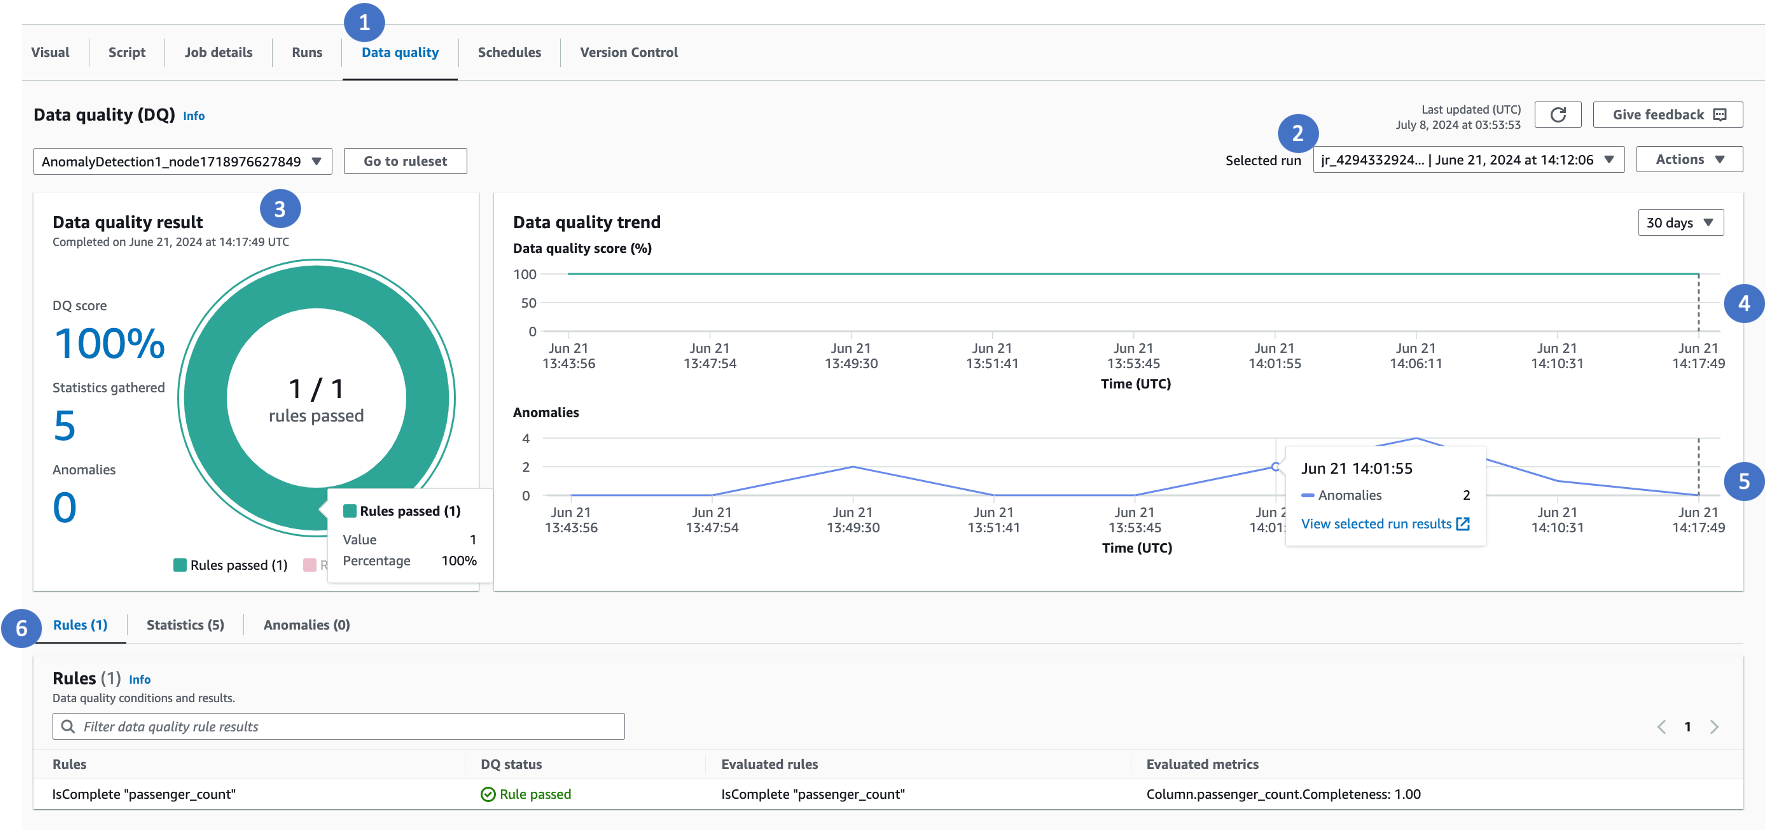
「資料品質」索引標籤中的下列元件提供有用的資訊。
-
選擇資料品質索引標籤,以檢視資料品質指標。
-
選取特定任務執行 ID 以檢視「資料品質」分數。
-
此窗格顯示三個重要資訊。您可以選擇每個資訊以導覽至特定的資料表,來檢視異常、資料統計資料或規則。
-
設定規則時的「資料品質」分數。
-
規則和分析器收集的統計資料數目。
-
偵測到的異常總數。
-
-
此趨勢圖表顯示了資料品質隨時間的變化趨勢。您可以將滑鼠的游標移至趨勢上,並前往資料品質分數下降的特定時間。
-
隨時間變化的異常趨勢會顯示隨時間變化偵測到的異常數目。
-
標籤:
-
規則索引標籤是顯示所有規則和狀態清單的預設索引標籤。評估規則在動態規則檢視評估規則的實際值時很有用。
-
「統計資料」索引標籤會列出所有統計資料,讓您檢視指標和隨時間變化的趨勢。
-
「異常」索引標籤會顯示偵測到的異常清單。
-
檢視異常和訓練異常偵測演算法
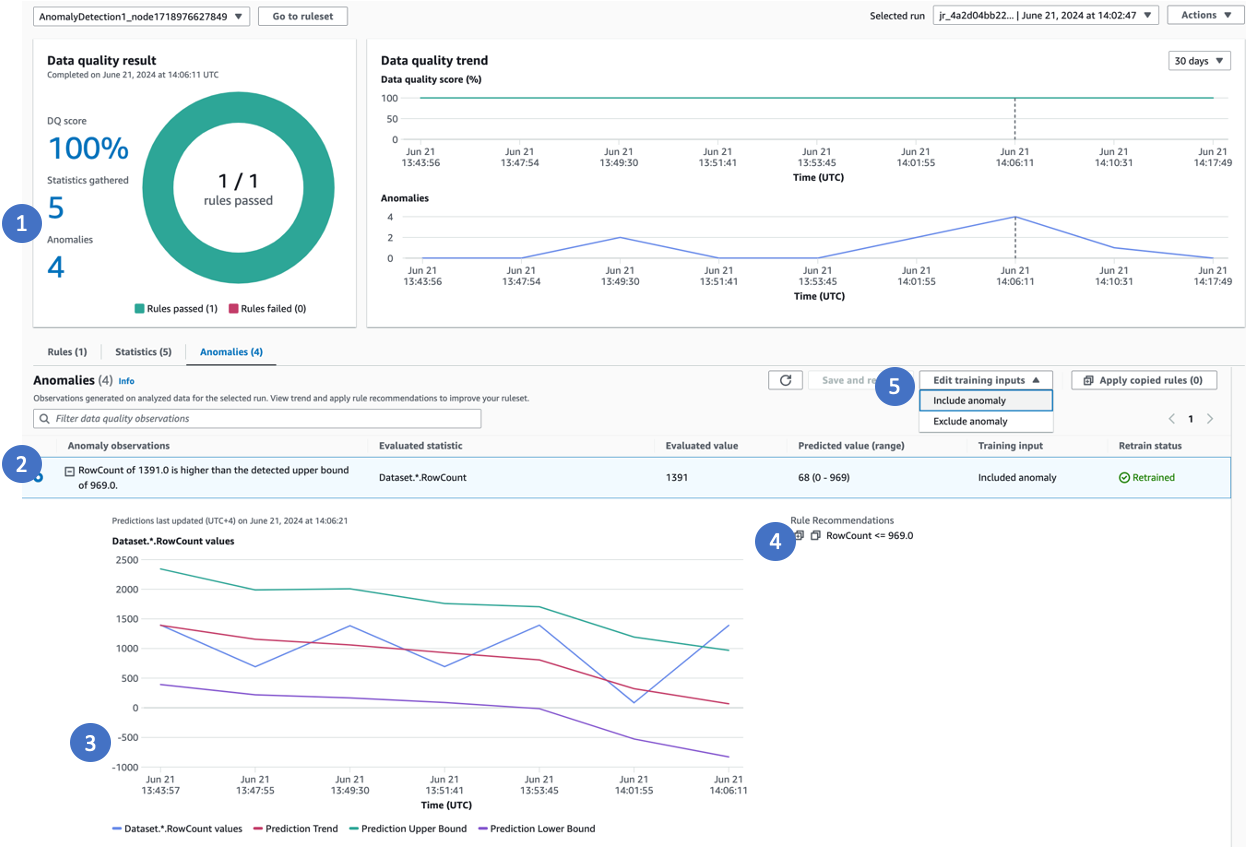
上面影像的標註:
-
偵測到異常時,按一下異常或選取「異常」索引標籤
-
AWS Glue Data Quality 提供異常、實際值、預測範圍的詳細說明
-
AWS Glue Data Quality 會顯示趨勢線。其具有實際值、根據實際值 (紅線) 的衍生趨勢、上限和下限
-
AWS Glue Data Quality 建議可用於擷取未來模式的資料品質規則。您可以複製建議的所有規則,並將其套用至資料品質節點,以有效地擷取這些模式。
-
您可以提供機器學習 (ML) 模型的輸入來排除異常值,確保未來的執行可準確偵測異常。如果您未明確排除異常, AWS Glue Data Quality 會自動將其視為未來預測模型的一部分。請務必注意,只有最新的執行才會反映您提供的模型輸入。例如,如果您從先前幾次執行中恢復並排除異常點,除非您在最新執行中檢視和更新模型輸入,否則模型不會反映這些變更。模型將繼續使用先前提供的輸入,直到您在最近的執行中進行必要的調整為止。透過主動管理異常值的排除,您可以改善 ML 模型對特定資料模式和要求的異常構成的理解,從而隨著時間的推移實現更準確的異常偵測。
檢視一段時間內的資料統計資料並提供訓練輸入
有時,您可能想要檢視資料統計資料或資料描述檔,並隨時間推移檢視其進展。若要這樣做,請選擇統計資料或開啟統計資料索引標籤。然後,您可以檢視 Glue Data Quality AWS 收集的最新資料統計資料。
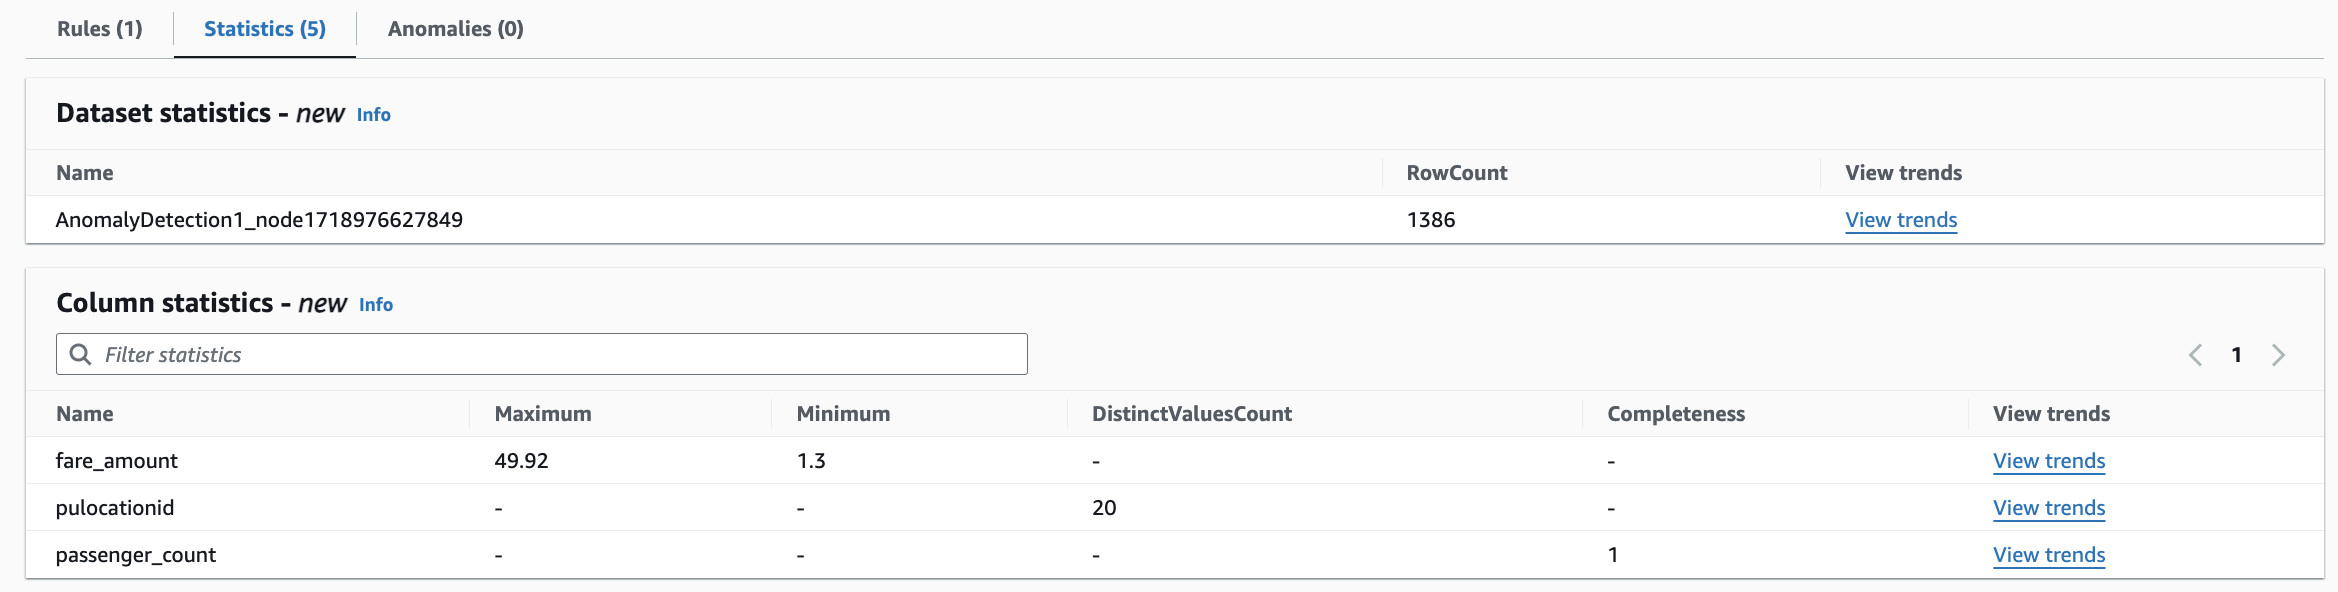
按一下檢視趨勢會顯示每個統計資料如何隨時間推移的進展。

-
您可以為指定的資料欄選取統計資料
-
您可以檢視趨勢的進度
-
您可以選取異常值,然後選擇排除或包含這些值。透過提供此意見回饋,演算法將排除或包含已識別的異常資料點,並重新訓練模型。此重新訓練程序可確保準確的異常偵測繼續進行,因為模型會從您提供的意見回饋中學習哪些值應視為異常。
透過此回饋迴圈,您可以改進演算法對特定資料模式和業務需求的異常構成的理解。透過排除不應被標記為異常的值,或包含遺漏的值,重新訓練的模型將更好地區分預期和真正異常的資料點。
