As traduções são geradas por tradução automática. Em caso de conflito entre o conteúdo da tradução e da versão original em inglês, a versão em inglês prevalecerá.
Tabelas de streaming e entrega de S3 para Amazon Kinesis Data Streams
Com o Amazon Kinesis Data Streams, você pode entregar dados de streaming dos seus streams de dados do Kinesis para dois tipos de destino: tabelas de streaming no Apache Iceberg (tabelas do Amazon S3) ou buckets Amazon S3 de uso geral. Você não precisa gerenciar nenhuma infraestrutura e pode começar a entregar em minutos. O Amazon Kinesis Data Streams lê seus registros de stream, armazena em buffer e agrega e os entrega ao seu destino configurado. A entrega é totalmente gerenciada — não há conectores, aplicativos de consumo ou recursos computacionais para provisionar.
Esses recursos são compatíveis com fluxos executados no modo de capacidade On-Demand Advantage ou On-Demand Standard. Você configura a entrega do seu stream e especifica um destino. Em seguida, o Amazon Kinesis Data Streams gerencia automaticamente a escalabilidade, as novas tentativas e a confiabilidade da entrega. A entrega não consome a taxa de leitura do seu stream e não tem impacto nos consumidores existentes.
Tópicos
Como funciona a entrega de dados
A entrega de dados conecta seu stream de dados do Kinesis a um destino de entrega por meio de um pipeline gerenciado:
Você publica dados em um stream de dados do Kinesis no On-Demand modo.
Você chama
CreateChannelo stream e especifica um destino (tabelas de streaming no Apache Iceberg ou um bucket Amazon S3 de uso geral).A entrega lê o stream, armazena registros em buffer e os agrega em arquivos de tamanho ideal.
A entrega grava os arquivos no seu destino configurado dentro da janela de atualização de dados especificada.
Destinos de entrega
A entrega de dados oferece suporte a dois tipos de destino:
- Tabelas de streaming no Apache Iceberg
-
As tabelas de streaming entregam continuamente seu stream de dados do Kinesis em tabelas do Apache Iceberg armazenadas nas tabelas do Amazon S3. Conforme os dados chegam, eles são automaticamente convertidos para o formato Apache Parquet otimizado com compactação inteligente em linha que elimina o problema de arquivos pequenos e reduz os custos de consultas posteriores. Poucos minutos depois de serem publicados em seu stream, os dados podem ser consultados por meio do Amazon Athena, do Amazon EMR, do Amazon Managed Service para Apache Flink ou de qualquer mecanismo compatível com o Apache Iceberg.
- Buckets Amazon S3 de uso geral
-
A entrega do Amazon S3 grava dados de streaming do seu stream de dados do Kinesis diretamente em um bucket do S3. Os registros são entregues no formato de origem original sem nenhuma transformação aplicada. Vários registros são armazenados em buffer e agrupados em objetos de tamanho ideal, com compactação configurável e uma estrutura de chave S3 que você define por meio do modelo de chave de saída. Isso é ideal para casos de uso como arquivamento de registros brutos, reprodução de eventos e processamento em lote downstream, em que você precisa de armazenamento durável e de baixo custo de seus dados de streaming sem a sobrecarga de gerenciar um pipeline de entrega.
Fluxo de dados
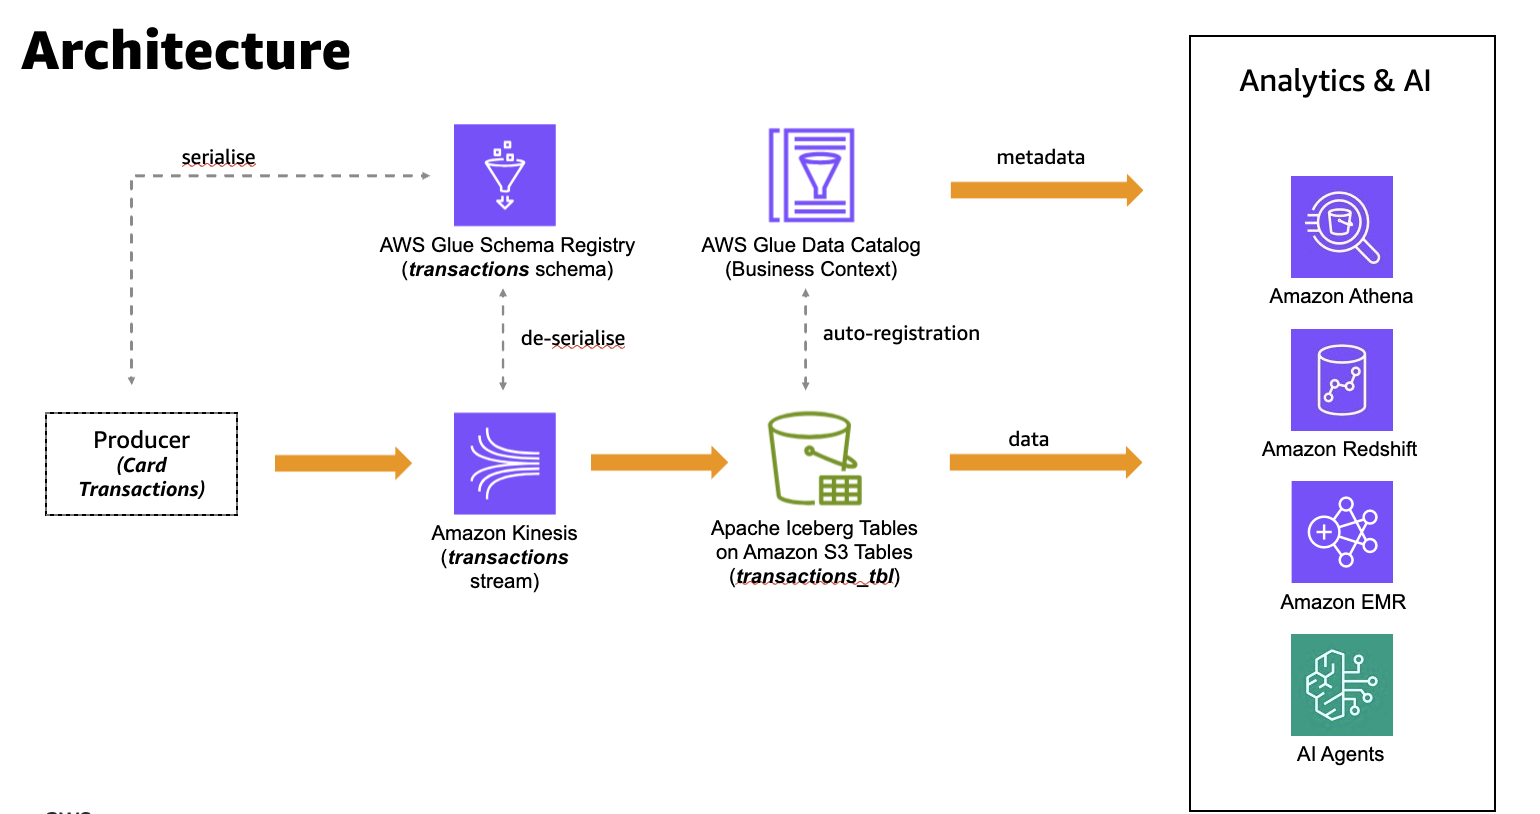
O diagrama a seguir mostra um fluxo de dados de ponta a ponta para entrega em tabelas de streaming no Apache Iceberg. O diagrama usa um caso de uso de transações com cartão como exemplo. Um produtor serializa registros em um esquema no AWS Glue Schema Registry e os grava em um stream de dados do Kinesis. O Amazon Kinesis Data Streams entrega os registros às tabelas do Apache Iceberg nas tabelas do Amazon S3. Se você habilitar a integração de análises nas tabelas do S3, os metadados da tabela também serão registrados no catálogo de AWS Glue dados; isso não acontece por padrão. Os dados fornecidos e seus metadados são então disponibilizados para mecanismos de análise e IA, como Amazon Athena, Amazon Redshift e Amazon EMR.
A entrega em buckets Amazon S3 de uso geral segue um fluxo semelhante, com duas diferenças. Um produtor grava registros em um stream de dados do Kinesis, e o Amazon Kinesis Data Streams os entrega ao seu bucket do S3. Os registros são entregues no formato de origem original sem conversão, portanto, o Registro do AWS Glue Esquema não é necessário e nenhum metadado da tabela é registrado no Catálogo de AWS Glue Dados. O Amazon Kinesis Data Streams armazena em buffer e agrupa registros em objetos de tamanho ideal e os grava usando a estrutura de chave do S3 que você define por meio do modelo de chave de saída. Os objetos entregues ficam então disponíveis para processamento e análise em lotes posteriores.
Capacidades gerais
A entrega de dados fornece os seguintes recursos principais:
Auto-scaling sem servidor — Dimensiona automaticamente com a taxa de transferência do stream, até a capacidade de throughput do stream. Não há recursos computacionais para provisionar.
Exactly-once entrega por fragmento — Os registros de um fragmento são entregues ao destino exatamente uma vez, sem duplicatas ou omissões no fragmento.
Entrega quase em tempo real — Atualização de dados configurável de 5 a 15 minutos (300 a 900 segundos).
Conversão automática do Parquet — Para tabelas de streaming no Apache Iceberg, converte registros de streaming em formato otimizado do Apache Parquet para consultas analíticas eficientes.
Compactação em linha — agrega registros em arquivos de tamanho ideal para desempenho de consultas analíticas.
Criptografia — Suporta AWS KMS chaves gerenciadas pelo cliente para criptografia do lado do servidor no destino. O Chave gerenciada pela AWS (o
aws/kinesisalias) não é compatível com a criptografia de destino.Dead-letter fila — metadados de falha para registros que não podem ser entregues, incluindo ARN do stream, ID do fragmento, número de sequência e contexto de erro, são gravados em uma fila de mensagens mortas. S3-based
CloudWatch métricas e registros — monitore os bytes entregues, contagens de registros e atualização de dados por meio das CloudWatch métricas da Amazon. Ative o registro de entrega no Amazon CloudWatch Logs para capturar detalhes do lote de entrega, falhas e contexto de erro para solução de problemas.
Sem impacto em outros consumidores — não consome slots de fan-out aprimorados nem taxa de transferência compartilhada.
Requisitos
A entrega de dados tem os seguintes requisitos:
Seu stream de dados do Kinesis deve usar o modo de capacidade On-Demand Standard ou On-Demand Advantage.
Você deve criar uma função de execução de serviço do IAM que conceda as permissões de entrega para gravar no seu destino.
Seu bucket de destino ou bucket de tabela deve estar na mesma região do seu stream de dados do Kinesis. A entrega de dados não oferece suporte à entrega entre regiões para nenhum dos tipos de destino.
Para tabelas de streaming no Apache Iceberg, a entrega entre contas não é suportada. O stream de origem, o bucket da tabela S3 de destino e o Registro do AWS Glue Esquema devem estar todos na mesma Conta da AWS e na mesma região.
Para buckets Amazon S3 de uso geral, a entrega entre contas é suportada somente para o bucket de destino. O canal e seu stream de origem devem estar no mesmo Conta da AWS; somente o bucket de destino pode estar em uma conta diferente.
Para tabelas de streaming no Apache Iceberg, você deve configurar uma fila de mensagens mortas no Amazon S3.
