View a markdown version of this page

Escolhendo um AWS serviço sem servidor - AWS Guias de decisão

As traduções são geradas por tradução automática. Em caso de conflito entre o conteúdo da tradução e da versão original em inglês, a versão em inglês prevalecerá.

Escolhendo um AWS serviço sem servidor

Finalidade

Ajude a determinar quais serviços AWS sem servidor são mais adequados para sua carga de trabalho.

Última atualização

4 de setembro de 2026

Público

Desenvolvedores e arquitetos avaliando serviços AWS sem servidor para cargas de trabalho novas ou existentes.

Serviços cobertos

Introdução

Com serviços AWS sem servidor, você pode criar e executar aplicativos sem provisionar ou gerenciar servidores. Você paga somente pelos recursos que consome e os serviços são escalados automaticamente em resposta à demanda.

AWS oferece opções sem servidor em computação, gerenciamento de APIs, integração de aplicativos, orquestração e armazenamento de dados, que você pode usar para montar aplicativos completos a partir de serviços gerenciados. Você pode criar aplicativos que vão desde microsserviços que lidam com lógica comercial discreta como parte do back-end de seu aplicativo até fluxos de trabalho orientados por eventos que realizam transformações ou processamento de dados.

Principais serviços sem servidor agrupados por categoria: computação, camada de API, integração de aplicativos, armazenamento de dados, implantação e observabilidade.

As estruturas de aplicativos tradicionais agrupam roteamento, acesso a dados e integrações em uma única base de código que você dimensiona e mantém como uma unidade. Essa abordagem funciona bem para começar rapidamente, e estruturas como Express, Django e Spring Boot fornecem ferramentas familiares que aumentam a produtividade inicial. No entanto, à medida que os aplicativos crescem e dependem de mais sistemas externos, a complexidade aumenta. O modelo monolítico dificulta o dimensionamento de recursos individuais e retarda o desenvolvimento e a solução de problemas. O desenvolvimento sem servidor aborda esses desafios criando serviços independentes, cada um com uma função específica. Em vez de criar padrões distribuídos comuns do zero, você usa AWS serviços específicos para filas, barramentos de eventos publish/subscribe, orquestração e APIs.

Existem padrões bem estabelecidos em arquiteturas distribuídas, incluindo filas, barramentos de eventos, orquestração publish/subscribe, APIs e fluxos de eventos, que você pode implementar usando serviços criados especificamente AWS em vez de criar do zero. Quando seu aplicativo precisar de um desses padrões, use o AWS serviço correspondente:

Padrão

AWS serviço

Fila

Amazon SQS

Barramento de eventos

Amazônia EventBridge

Publish/subscribe (fan-out)

Amazon SNS

Orquestração

Funções de etapa

solicitações de

Amazon API Gateway

Streams de eventos

Amazon Kinesis

Este guia ajuda você a selecionar os serviços e ferramentas AWS sem servidor que são mais adequados para seus padrões de carga de trabalho e requisitos organizacionais.

Compreendo

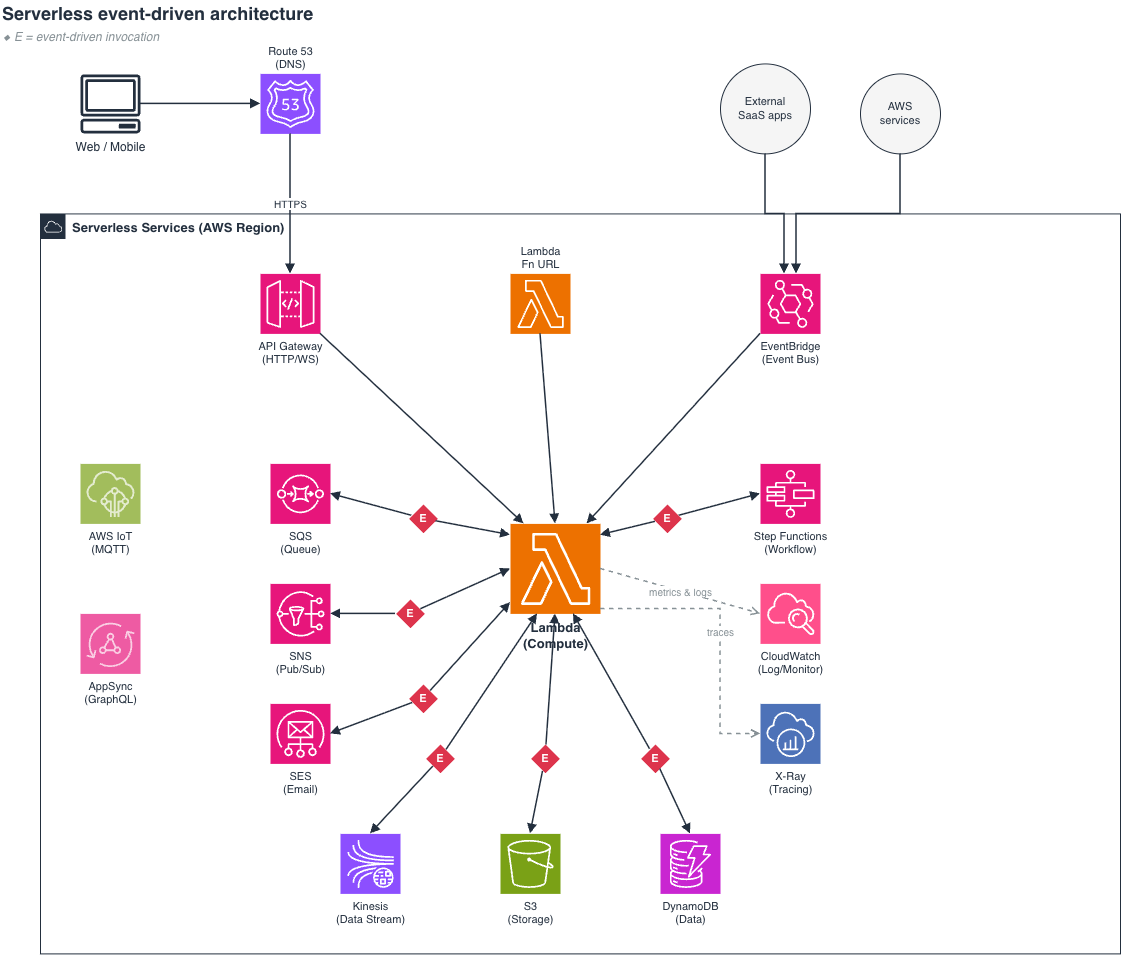
Esses serviços se comunicam por meio de eventos, que são mensagens que representam uma mudança de estado. Por exemplo, quando um cliente carrega uma foto no Amazon S3, o Amazon S3 publica um evento que aciona uma função do Lambda para gerar uma miniatura, sem que o serviço de upload precise conhecer o serviço de miniaturas. Você também pode lidar com tarefas de longa duração de forma assíncrona. Por exemplo, você pode implementar uma fila usando o Amazon SQS para gerenciar envios de pedidos. Em seguida, use o Step Functions para gerenciar um fluxo de trabalho que atualiza as informações do usuário e as contagens de estoque após o processamento de cada pedido. Ao longo do caminho, você usa CloudWatch a Amazon para registrar ações, monitorar a atividade do aplicativo e AWS X-Ray rastrear fluxos de dados para depuração. Os produtores de eventos não precisam saber quais serviços downstream responderão. Esse desacoplamento permite que cada componente seja escalado, implantado e evoluído de forma independente. Para obter informações sobre as vantagens de uma arquitetura desacoplada, consulte O que é EDA (Event-Driven arquitetura)? .

Arquitetura orientada por eventos sem servidor com o Lambda no centro, conectada por meio de eventos ao ecossistema completo de serviços sem servidor.

As seções a seguir descrevem os serviços disponíveis em cada categoria de uma arquitetura sem servidor e para que eles são otimizados.

Serverless compute
  • Funções de eventos do Lambda: execute código em resposta a eventos sem provisionar servidores. As funções de eventos escalam automaticamente de zero a milhares de execuções simultâneas e cobram por solicitação e duração da execução. Otimizado para cargas de trabalho de curta duração e orientadas por eventos com duração máxima de 15 minutos por invocação. O Lambda também oferece suporte ao streaming de respostas para entrega progressiva de resultados, o que é útil para IA generativa e respostas de grande carga útil. Para fluxos de trabalho que precisam ser executados por mais tempo, as funções duráveis do Lambda mantêm automaticamente o estado em várias invocações, permitindo execuções de longa duração e permanecendo dentro do limite de tempo por invocação.

  • MicroVMs Lambda: um formato de computação diferente no serviço Lambda, distinto das Funções de Eventos em tempo limite, modelo de programação, modelo de simultaneidade e cobrança. As microVMs executam ambientes de execução isolados e com estado para usuários ou códigos. AI-generated Cada microVM fornece VM-level isolamento alimentado pelo Firecracker com recursos completos do sistema operacional (instalação de pacotes, montagem de sistemas de arquivos), inicialização rápida baseada em instantâneos e vida útil de até 8 horas. As microVMs suportam a suspensão e a retomada para reduzir os custos ociosos e, ao mesmo tempo, preservar o estado da memória e do disco, os protocolos de escuta de portas (HTTP/2, gRPC WebSocket) e a alocação flexível de recursos com capacidade básica que pode aumentar para 4 vezes durante o pico de atividade. Diferentemente das Funções de Eventos, as microVMs usam um modelo de Dockerfile-based programação e alocam um ambiente por sessão em vez de escalar por solicitação. Adequado para sandboxes de codificação de IA, ambientes de desenvolvimento interativos, notebooks de análise de dados, executores de CI multilocatários, verificação de segurança, ambientes de aprendizado por reforço e servidores de jogos. Cada microVM recebe um endpoint HTTPS dedicado sem exigir balanceadores de carga ou infraestrutura de entrada e oferece suporte a redes de saída configuráveis para acesso VPC e conectividade pública à Internet.

  • AWS Fargate: execute contêineres sem gerenciar servidores ou clusters. O Fargate gerencia o provisionamento e o dimensionamento da computação para cargas de trabalho em contêineres. Adequado para serviços de longa duração, processamento em lote ou cargas de trabalho que precisam de tempos de execução personalizados e controle de recursos refinado.

dica

Para uma comparação mais detalhada das opções de computação sem servidor, consulte ou? AWS FargateAWS Lambda

API layer
  • API HTTP do Amazon API Gateway: roteamento de API leve e de baixo custo otimizado para back-ends Lambda e HTTP com implantações automáticas.

  • API REST do Amazon API Gateway: gerenciamento de Full-featured APIs com validação de solicitações, streaming de respostas, armazenamento em cache, integração com AWS WAF, planos de uso, chaves de API e endpoints privados.

  • AWS AppSync: serviço gerenciado do GraphQL com assinaturas em tempo real, sincronização offline e integração automática de fontes de dados (DynamoDB, Lambda, HTTP). Ideal para aplicativos móveis e da web com requisitos de dados complexos. AWS AppSync O Events fornece WebSocket APIs sem servidor para publish/subscribe mensagens em tempo real, permitindo que os aplicativos publiquem e assinem eventos em uma única WebSocket conexão com integrações de fontes de dados para processar eventos publicados.

  • URLs de funções do Lambda: endpoints HTTPS dedicados para funções individuais do Lambda sem API Gateway. Adequado para microsserviços ou webhooks de função única em que os recursos de gerenciamento de API não são necessários.

  • WebSocket APIs do Amazon API Gateway: conexões persistentes e bidirecionais entre clientes e serviços de back-end. Use para aplicativos de bate-papo, painéis em tempo real, jogos multijogador ou plataformas de negociação financeira nas quais o servidor precisa enviar dados aos clientes sem fazer pesquisas.

Application integration
  • Amazon Simple Queue Service: fila de mensagens totalmente gerenciada para serviços de dissociação. Suporta filas padrão (pelo menos uma vez, melhor esforço para fazer pedidos) e FIFO (exatamente uma vez, pedidos rigorosos). Use para armazenamento em buffer, nivelamento de carga e processamento assíncrono.

  • Amazon Simple Notification Service: Publish/subscribe envio de mensagens para distribuição para vários assinantes (Lambda, Amazon SQS, HTTP, e-mail, SMS). Use quando um evento precisar acionar várias ações posteriores. Oferece suporte à filtragem de mensagens com políticas de filtro de assinatura, incluindo correspondência de curingas e prefixos, permitindo que os assinantes recebam somente mensagens relevantes sem lógica de filtragem personalizada.

  • Amazon EventBridge: barramento de eventos sem servidor para rotear eventos de AWS serviços, aplicativos SaaS e fontes personalizadas usando regras de filtragem baseadas em conteúdo. Use para arquiteturas orientadas por eventos com roteamento complexo ou integrações de terceiros.

dica

Para uma comparação mais aprofundada, consulte Amazon SQS, Amazon SNS ou Amazon? EventBridge

Orchestration
  • AWS Step Functions Fluxos de trabalho padrão: coordene processos de várias etapas com execução única, histórico completo de execução e duração de até um ano. Use para processamento de pedidos, aprovações humanas e canais de ETL.

  • AWS Step Functions Fluxos de trabalho expressos: High-volume orquestração de curta duração (até 5 minutos) com execução pelo menos uma vez. Use para ingestão de dados de IoT, transformações de streaming e processamento de eventos de alta taxa.

O Step Functions suporta variáveis para atribuir dados em um estado e usá-los em estados subsequentes, e transformações JSOnata para manipulação avançada de dados, incluindo formatação de data e operações matemáticas. Esses recursos simplificam o compartilhamento de dados entre os estados e reduzem a necessidade de etapas intermediárias de processamento. Para processamento em lote em grande escala, o Distributed Map executa o mesmo processo em milhões de itens dos conjuntos de dados Amazon S3, Athena ou JSON em paralelo, sem provisionar a infraestrutura de computação.

Data storage
  • Amazon DynamoDB: banco de dados de documentos e valores-chave NoSQL sem servidor com tempos de resposta de um dígito em milissegundos em qualquer escala. Não é necessário agrupar conexões. Use para acesso a dados de alto rendimento e baixa latência com esquemas flexíveis.

  • Amazon Simple Storage Service: armazenamento de objetos com capacidade ilimitada. Use para armazenamento de arquivos, data lakes, ativos estáticos e processamento orientado por eventos (o Amazon S3 aciona o Lambda no upload).

  • Amazon Aurora Serverless: On-demand banco de dados relacional com escalabilidade automática compatível com MySQL e PostgreSQL. Use quando precisar de semântica SQL, uniões complexas ou transações ACID com escalabilidade sem servidor.

dica

Para uma comparação mais aprofundada, consulte Como escolher um serviço AWS de banco de dados.

Deployment and infrastructure as code
  • AWS Serverless Application Model: CloudFormation extensão com sintaxe abreviada para Lambda, API Gateway, DynamoDB e Step Functions. Inclui testes locais por meio da CLI do SAM. Ideal para aplicativos que priorizam o uso de servidores.

  • AWS Cloud Development Kit (AWS CDK): defina a infraestrutura usando linguagens de programação (TypeScriptPython, Java, C#, Go). Ideal para aplicações complexas que se beneficiam de loops, condicionais e construções reutilizáveis.

  • Terraform: Usando Multi-cloud HashiCorp Configuration Language (HCL) IaC. Ideal para equipes de plataforma que gerenciam a infraestrutura em todos os fornecedores.

Observability
  • Amazon CloudWatch: métricas, registros, alarmes e painéis para monitorar funções do Lambda, API Gateway e outros serviços.

  • AWS X-Ray: rastreamento distribuído para entender o fluxo de solicitações entre funções e serviços integrados do Lambda. Essencial para depurar arquiteturas orientadas por eventos.

dica

Para uma comparação mais aprofundada, consulte Como escolher um serviço de AWS monitoramento e observabilidade.

Considere

Aqui estão alguns fatores-chave a serem considerados ao escolher AWS serviços sem servidor. Escolher a combinação certa envolve equilibrar esses fatores para que correspondam aos padrões de carga de trabalho, aos requisitos técnicos e às metas organizacionais. Isso ajuda você a otimizar o desempenho, o custo e a simplicidade operacional.

Workload pattern

Entender o padrão operacional do seu aplicativo é o fator mais importante na seleção de serviços sem servidor. Diferentes padrões de carga de trabalho exigem diferentes combinações de serviços. O processamento de dados sem servidor se enquadra, em grande parte, nos seguintes padrões:

  • Processamento assíncrono: processamento de arquivos, manipulação de imagens, transformações em lote e webhooks. Essas cargas de trabalho processam eventos que não exigem uma resposta imediata e se beneficiam de filas para armazenamento em buffer e distribuição para processamento paralelo.

  • Síncrono request/response: APIs da Web, back-ends móveis e microsserviços. Essas cargas de trabalho precisam de computação de baixa latência que responda às solicitações HTTP individuais e se adapte ao tráfego simultâneo.

  • Streaming: telemetria de IoT, análise de fluxo de cliques, análise em tempo real e processamento de transações. Essas cargas de trabalho ingerem dados contínuos e de alta velocidade que devem ser processados quase em tempo real.

  • Orquestração: fluxos de Multi-step aprovação, canais de ETL e padrões de saga. Essas cargas de trabalho coordenam tarefas com lógica de ramificação, tratamento de erros e gerenciamento de estado.

Cada padrão usa uma combinação diferente de serviços sem servidor. Para obter exemplos detalhados e combinações de serviços recomendadas para cada padrão, consulte a seção Escolher.

Execution duration and concurrency

Os serviços de computação sem servidor diferem significativamente no tempo em que permitem a execução de uma única execução e na forma como lidam com a simultaneidade. Diferentemente dos servidores tradicionais, as funções de eventos do Lambda não são executadas constantemente. Quando uma função é acionada por um evento, isso é chamado de invocação. As funções de eventos do Lambda são limitadas a 15 minutos de duração, mas, em média, em todos os AWS clientes, a maioria das invocações dura menos de um segundo.

Short-lived, as invocações orientadas por eventos são melhor atendidas pelo Lambda, que oferece suporte a durações de execução de até 15 minutos e escala automaticamente por solicitação para milhares de invocações simultâneas. O serviço Lambda executa instâncias de sua função somente quando necessário e escala automaticamente de zero solicitações por dia para milhares por segundo. Você paga somente pelo tempo de computação realmente usado, portanto, não há cobrança quando seu código não está em execução. O faturamento por milissegundo do Lambda pode reduzir o custo de cargas de trabalho de curta duração.

Há muitos tipos de eventos de invocação que podem acionar funções de curta duração. Alguns exemplos incluem uma solicitação HTTP do API Gateway, uma programação gerenciada por uma EventBridge regra, uma mensagem de um dispositivo de IoT ou uma notificação de que um arquivo foi carregado em um bucket do Amazon S3.

Sessões interativas e dinâmicas, como sandboxes de codificação de IA, notebooks interativos e ambientes de CI multilocatários, precisam de ambientes isolados que mantenham o estado entre as interações do usuário. As microVMs Lambda têm um formato computacional diferente das Funções de Eventos: elas usam um modelo de Dockerfile-based programação, alocam um ambiente por sessão (não por solicitação) e faturam com base em um modelo básico mais um modelo de intermitência em vez de por milissegundo. As microVMs fornecem VM-level isolamento com recursos completos do sistema operacional, inicialização rápida baseada em instantâneos, vida útil de até 8 horas e para reduzir os custos ociosos. suspend/resume

Long-running ou processos em estado estacionário, como trabalhos em lote, WebSocket conexões persistentes ou serviços que exigem mais de 15 minutos de processamento contínuo, são melhor atendidos pelo Fargate, que pode ser executado indefinidamente. Para obter detalhes sobre como o Fargate e o Lambda escalam de forma diferente, consulte a guia Modelo de escalabilidade e latência. O Fargate fornece alocação consistente de recursos para cargas de trabalho que excedem o tempo limite ou os limites de computação do Lambda. Além disso, as funções duráveis do Lambda permitem execuções de longa duração em várias etapas que persistem no estado em várias invocações. Cada invocação individual ainda respeita o limite de 15 minutos. As funções duráveis verificam automaticamente o progresso e retomam de onde pararam, de modo que a duração total do fluxo de trabalho pode exceder em muito 15 minutos sem exigir Fargate ou orquestração externa.

Considere o tempo médio e máximo de execução de suas cargas de trabalho. Uma função do Lambda que ocasionalmente excede 15 minutos falha de forma imprevisível e exige um redesenho arquitetônico. A arquitetura e as necessidades do seu aplicativo determinam como invocar uma função. Por exemplo, os padrões de processamento em lote têm requisitos diferentes do processamento de dados sob demanda. O Fargate é adequado para um microsserviço que lida principalmente com o processamento de dados em lote. O Lambda é mais simples de implantar e manter para processamento sob demanda.

Cost model and predictability

Uma das principais vantagens do desenvolvimento sem servidor é que você paga somente pelos recursos que consome. As tecnologias sem servidor são pagas conforme o uso, o que significa que você pode aumentar e diminuir a escala conforme as necessidades do seu aplicativo mudarem, sem pagar pela capacidade ociosa. No entanto, diferentes serviços AWS sem servidor usam modelos de preços diferentes que favorecem diferentes padrões de uso.

Pay-per-use os preços (Lambda, Step Functions Express EventBridge) são cobrados com base nas invocações e na duração reais, sem custo quando inativo. Para o Lambda, você é cobrado com base no número de solicitações para suas funções e na duração da execução do código. Não haverá cobranças quando seu código não estiver em execução. Esse modelo é adequado para cargas de trabalho imprevisíveis ou pontiagudas, nas quais o tráfego pode cair para zero, e para aplicativos em estágio inicial, onde a demanda é incerta.

Capacity-based preços (Fargate, Amazon Aurora Serverless, modo provisionado do DynamoDB) cobranças pela capacidade reservada de computação ou taxa de transferência. Embora isso possa gerar custos durante períodos de baixo tráfego, torna-se mais econômico em uma escala sustentada e previsível, em que o preço por solicitação excederia a capacidade reservada equivalente. Por exemplo, o modo provisionado do DynamoDB permite ajustar a capacidade de transferência de suas tabelas conforme necessário, o que pode ser mais econômico para cargas de trabalho com padrões de tráfego consistentes.

Os preços híbridos (DynamoDB sob demanda, API Gateway) oferecem preços por solicitação que escalam linearmente sem compromisso inicial. Isso fornece previsibilidade de custos sem a necessidade de prever a capacidade, mas pode se tornar caro com uma taxa de transferência muito alta em comparação com as alternativas provisionadas.

O preço básico e o preço máximo (Lambda MicroVMS) cobram pelos recursos de linha de base configurados enquanto a microVM está em execução, com a capacidade de aumentar até 4 vezes a linha de base durante o pico de atividade. As microVMs suspensas reduzem os custos e preservam o estado. Esse modelo é adequado para cargas de trabalho interativas com atividades variáveis e períodos de inatividade.

Modele seus padrões de tráfego esperados em ciclos diários, semanais e sazonais. Cargas de trabalho com altas taxas de pico em relação à média favorecem os preços por uso. Steady-state as cargas de trabalho podem se beneficiar dos preços baseados na capacidade. Você também pode usar uma combinação: por exemplo, Lambda com pagamento por uso para computação variável junto com o modo provisionado do DynamoDB para padrões previsíveis de acesso aos dados.

Operational complexity

As estruturas tradicionais de aplicativos da Web agrupam roteamento, acesso a dados, pools de conexão e integrações em uma única base de código que você implanta e mantém como uma unidade. Instalar, configurar e manter as estruturas, os ambientes de tempo de execução e a infraestrutura retarda a entrega de recursos e correções de erros. À medida que os aplicativos crescem e dependem de mais sistemas externos, essa complexidade aumenta o tempo de inicialização para novos desenvolvedores, torna mais difícil rastrear a origem dos bugs e atrasa a entrega de novos recursos.

Os serviços sem servidor existem em um espectro de responsabilidade operacional que reduz ou elimina essa sobrecarga. Em vez de gerenciar tudo em um único pacote, você compõe serviços vagamente conectados, em que cada um faz uma coisa bem com o mínimo de dependências possível.

Gerenciamento mínimo: o Lambda, o API Gateway, o DynamoDB, o Amazon SQS, o Amazon SNS e o Step Functions não exigem provisionamento EventBridge, aplicação de patches ou planejamento de capacidade do servidor. Você não precisa configurar grupos de conexões, configurar ambientes de execução ou gerenciar a infraestrutura de escalabilidade. Você pode se concentrar inteiramente em escrever ou gerar código que resolva problemas de negócios.

Gerenciamento de contêineres: o Fargate exige a criação e manutenção de imagens de contêineres, a configuração de definições de tarefas e o gerenciamento de pipelines de implantação. Você não gerencia a infraestrutura subjacente, mas é dono do ciclo de vida do contêiner. Esse modelo é adequado para equipes que precisam de tempos de execução personalizados ou têm cargas de trabalho em contêineres existentes que desejam executar sem gerenciar clusters.

Infraestrutura como complexidade de código: AWS Serverless Application Model minimiza a complexidade do IaC para arquiteturas somente sem servidor com sintaxe abreviada e testes locais. AWS Cloud Development Kit (AWS CDK) e Terraform fornecem mais potência para aplicativos complexos ao custo de curvas de aprendizado mais acentuadas e de mais código para manter.

Considere as habilidades existentes da sua equipe, o número de serviços a serem gerenciados e os padrões operacionais da sua organização. Se suas equipes estão gastando mais tempo mantendo a infraestrutura do que criando recursos, migrar para a extremidade mínima de gerenciamento do espectro pode liberar recursos para trabalhos de maior valor.

Scaling model and latency

A forma como um serviço se expande afeta diretamente a capacidade de resposta do seu aplicativo sob carga. Em arquiteturas sem servidor, o escalonamento acontece automaticamente, mas serviços diferentes usam mecanismos diferentes que afetam a latência e a taxa de transferência.

Per-request o scaling (Lambda) cria um novo ambiente de execução para cada solicitação simultânea. O Lambda invoca sua função em um ambiente de execução, que fornece um ambiente de execução seguro e isolado que gerencia os processos e recursos necessários para executar a função. Isso fornece uma resposta quase instantânea aos picos de tráfego, escalando de zero a milhares de execuções simultâneas em segundos.

No entanto, a escalabilidade por solicitação introduz inícios a frio, que são atrasos na inicialização que ocorrem quando o Lambda cria um novo ambiente de execução. O maior contribuinte para o tempo de inicialização a frio é o tempo que o Lambda gasta inicializando a função, o que inclui carregar o código da função, iniciar o tempo de execução e inicializar o código da função. Para cargas de trabalho Java, Python e .NET, o Lambda SnapStart pode melhorar o desempenho da inicialização em até 10 vezes sem custo adicional, tirando um instantâneo do ambiente de execução inicializado e armazenando-o em cache para acesso de baixa latência. Para outros tempos de execução, você pode reduzir os inícios a frio com a simultaneidade provisionada por um custo adicional.

Task-level o scaling (Fargate) adiciona ou remove instâncias de contêiner com base em métricas como utilização de CPU, uso de memória ou contagem de solicitações. O escalonamento adiciona novas tarefas em segundos ou minutos e evita inícios a frio de solicitações tratadas por tarefas existentes. Quando uma tarefa é executada, ela permanece aquecida por toda a vida útil, fornecendo latência consistente para todas as solicitações processadas.

Throughput-based a escalabilidade (DynamoDB, Kinesis) ajusta a read/write capacidade ou a contagem de fragmentos com base na demanda. O modo sob demanda do DynamoDB é escalado instantaneamente para acomodar os padrões de tráfego da sua carga de trabalho. O modo provisionado exige configuração de escalabilidade automática, mas fornece uma taxa de transferência previsível com custos mais baixos por solicitação. Com a arquitetura sem servidor e o DynamoDB, os pools de conexão não são necessários para conectar e escalar rapidamente o banco de dados. Em vez disso, você ajusta a capacidade de produção de suas tabelas conforme necessário.

Para requisitos estritos de latência (abaixo de 100 ms P99), avalie cuidadosamente o comportamento de partida a frio. O Lambda com simultaneidade provisionada ou SnapStart o Fargate com tarefas pré-aquecidas fornecem latência previsível para cargas de trabalho de API. Para cargas de trabalho de processamento de dados em que a latência é menos crítica, o escalonamento padrão do Lambda geralmente é suficiente.

Integration and composability

As arquiteturas sem servidor são compostas por vários serviços que se comunicam por meio de eventos. Um evento representa uma mudança no estado ou uma atualização. Por exemplo, um item colocado em um carrinho de compras, um arquivo carregado em um sistema de armazenamento ou um pedido pronto para envio. A profundidade da integração nativa entre os serviços afeta a rapidez com que você pode criar e a quantidade de código personalizado que você precisa escrever.

Integração nativa profunda: o Lambda se integra a mais de 200 AWS serviços como fontes de eventos. Alguns serviços podem acionar funções do Lambda diretamente. Por exemplo, quando uma imagem é adicionada a um bucket do Amazon S3, o Lambda pode ser acionado para redimensioná-la. Alguns serviços não podem invocar o Lambda diretamente, mas você pode usar um mapeamento da fonte de eventos, que é um mecanismo de pesquisa que lê a partir de uma fonte de eventos e invoca uma função do Lambda. Você pode usar mapeamentos de origem de eventos para processar itens de um stream ou fila em: DynamoDB Streams, Amazon Kinesis, Amazon MQ, Amazon MSK, autogerenciado e Amazon SQS. Apache Kafka

Flexibilidade de roteamento de eventos: EventBridge fornece roteamento baseado em conteúdo com regras de filtragem, permitindo que um único barramento de eventos direcione eventos para destinos diferentes com base no conteúdo do evento. O Amazon SNS fornece distribuição baseada em tópicos para entregar mensagens a vários assinantes simultaneamente. O Amazon SQS fornece buffer ponto a ponto em que os consumidores pesquisam ativamente as mensagens da fila. As combinações comuns incluem o roteamento EventBridge de eventos do Amazon SNS para uma fila do Amazon SQS como um buffer para consumidores downstream, a extração de eventos de um stream ou fila com o EventBridge Pipes e o roteamento de eventos para o Kinesis para análise.

Padrões de integração de API: o API Gateway oferece duas abordagens de integração. As integrações de proxy passam diretamente todas as informações da solicitação para uma função do Lambda para processamento, que é mais simples de configurar. Non-proxy integrações (personalizadas) podem transformar dados antes que eles cheguem à sua função e antes que a saída retorne aos clientes, o que é útil para a migração de código legado ou para manter o código da função focado na lógica de negócios. A API REST fornece o conjunto de recursos mais amplo, incluindo armazenamento em cache, validação de solicitações e WAF. A API HTTP fornece a menor latência e custo. AWS AppSync fornece assinaturas em tempo real e GraphQL. Os URLs de função do Lambda fornecem o endpoint HTTPS de função única mais simples sem exigir o API Gateway. Para comunicação bidirecional em que o servidor precisa enviar dados aos clientes, as WebSocket APIs do API Gateway fornecem conexões persistentes adequadas para bate-papo, painéis em tempo real e jogos multijogador.

Devido ao acoplamento frouxo entre os componentes de um sistema orientado por eventos, suas funções de computação não estão cientes de outras atividades na arquitetura. Você pode escalar componentes de forma independente, um serviço pode falhar sem afetar outros serviços e os eventos podem ser roteados, armazenados em buffer de forma flexível e fornecer um registro para auditoria.

Portability and standards

Sua escolha de serviços sem servidor afeta a portabilidade de sua arquitetura em todos os ambientes. Os aplicativos sem servidor geralmente incluem vários AWS serviços, integrados ao código personalizado executado nas funções do Lambda. Embora o Lambda possa ser integrado à maioria dos AWS serviços, você deve considerar a compensação entre a integração profunda da plataforma e a capacidade de executar cargas de trabalho em outros ambientes.

AWS os serviços nativos (Lambda, Step Functions EventBridge, DynamoDB) fornecem a integração mais profunda e a menor sobrecarga operacional. Você pode usar qualquer um desses serviços por meio do AWS SDK sem precisar instalar aplicativos ou configurar servidores. Tornar-se proficiente no uso desses serviços por meio de código em suas funções do Lambda é uma etapa importante para produzir aplicações com tecnologia sem servidor bem projetadas. No entanto, esses serviços criam acoplamento a APIs e formatos AWS de eventos específicos, o que significa que a migração para outra nuvem exige uma refatoração significativa.

Standards-based serviços (Fargate com Docker contêineres, Amazon MQ comAMQP, Amazon MSK comApache Kafka) são executados em protocolos abertos ou tecnologias de código aberto. Se precisar de um tempo de execução personalizado que não seja fornecido pelo AWS, você pode criar e implantar uma imagem de contêiner personalizada no Fargate. O Amazon MSK oferece Apache Kafka compatibilidade para equipes com experiência existente em Kafka. Essas opções tornam a portabilidade da carga de trabalho mais viável ao custo de maior complexidade operacional e menor integração com outros serviços. AWS

Estruturas de implantação: AWS Serverless Application Model AWS Cloud Development Kit (AWS CDK) geram CloudFormation modelos e são AWS somente. AWS Serverless Application Model se estende CloudFormation com sintaxe abreviada focada em acelerar o desenvolvimento sem servidor, oferecendo definições otimizadas para recursos do API Gateway, Lambda e Step Functions, além de testes locais do Lambda por meio da CLI do SAM. Terraformfornece definição de infraestrutura multinuvem usando um único fluxo de trabalho entre fornecedores, mas com menos ferramentas específicas sem servidor e recursos limitados de testes locais do Lambda.

Contêineres e mensagens baseadas em padrões podem melhorar a portabilidade para requisitos de várias nuvens. Os serviços nativos sem servidor oferecem uma integração próxima com outros AWS serviços, o que pode simplificar o desenvolvimento quando sua carga de trabalho é executada principalmente em funcionamento. AWS

Escolher

As informações a seguir podem ajudar você a avaliar quais serviços AWS sem servidor atendem às suas necessidades de carga de trabalho.

A tabela a seguir destaca quais serviços são otimizados para quais circunstâncias.

Categoria sem servidor

Para que ele é otimizado?

Serviços sem servidor

Computação

Executar código em resposta a eventos com o mínimo de sobrecarga operacional, escalando por solicitação sem custo de inatividade. Executando ambientes de execução isolados e com estado para usuário ou AI-generated código.

Funções do evento Lambda

Lambda MicroVMs

AWS Fargate

Camada de API

Roteamento de HTTP e WebSocket solicitações para serviços de back-end, gerenciamento de autenticação, limitação e armazenamento em cache.

API HTTP do Amazon API Gateway

API REST do Amazon API Gateway

AWS AppSync

URLs de função do Lambda

APIs do Amazon API WebSocket Gateway

Integração de aplicativos

Serviços de desacoplamento por meio de mensagens e roteamento de eventos para publish/subscribe arquiteturas assíncronas e fracamente acopladas.

Amazon Simple Queue Service

Amazon Simple Notification Service

Amazon EventBridge

Orquestração

Coordenar fluxos de trabalho de várias etapas com ramificação, tratamento de erros, novas tentativas e gerenciamento de estado.

AWS Step Functions Fluxos de trabalho padrão

AWS Step Functions Fluxos de trabalho expressos

Armazenamento de dados

Armazenamento e recuperação de dados com escalabilidade automática, sem gerenciamento de servidores e preços de pagamento por uso.

Amazon DynamoDB

Amazon Simple Storage Service

Amazon Aurora sem servidor

Implantação e IaC

Definindo, implantando e gerenciando a infraestrutura sem servidor e o código do aplicativo como código.

AWS Serverless Application Model

AWS Cloud Development Kit (AWS CDK)

Terraformtutorial de introdução no site HashiCorp

Observabilidade

Monitorando o desempenho, rastreando solicitações em todos os serviços e diagnosticando problemas em arquiteturas orientadas por eventos.

Amazon CloudWatch

AWS X-Ray

As guias a seguir fornecem orientação detalhada com base nas suas necessidades específicas de carga de trabalho. Escolha a guia que melhor descreve o que você precisa criar e revise os serviços e exemplos recomendados para esse caso de uso.

Synchronous API backend

Você precisa lidar com solicitações HTTP de clientes web ou móveis, processá-las e retornar respostas com baixa latência.

Para APIs web e back-ends móveis, o API Gateway encaminha solicitações HTTP para funções do Lambda. O DynamoDB lida com o acesso aos dados de baixa latência. A API HTTP fornece roteamento simples a um custo menor, enquanto a API REST adiciona armazenamento em cache, validação de solicitações e integração com WAF. Você pode lidar com a autenticação com o Amazon Cognito e AWS Serverless Application Model definir esses recursos com sintaxe abreviada.

Para implementar o processamento síncrono, use AWS Lambda para computação e o Amazon API Gateway Gateway para solicitações de roteamento. Use AWS Step Functions para orquestrar fluxos de trabalho de microsserviços. Armazene dados e arquivos com o DynamoDB e o Amazon S3 e autentique usuários com o Amazon Amazon Cognito.

Por exemplo, suponha que você queira criar um aplicativo de microsserviços que procure dados meteorológicos por código postal. O cliente resolve o nome do host por meio do Amazon Route 53. A solicitação HTTP GET é roteada para o API Gateway, que verifica um token de acesso por meio do Amazon Cognito e, em seguida, envia a solicitação para uma função do Lambda. A função consulta o DynamoDB, personaliza os dados, envia um evento para o Amazon SQS para análise e outro para o Amazon SNS para alertas. Depois que o tráfego diminui, o Lambda destrói o ambiente de execução. Você paga somente pelo uso real da função.

Arquitetura de microsserviços meteorológicos: a solicitação de um cliente móvel flui pelo Route 53, API Gateway, Cognito, Lambda, DynamoDB, SQS e SNS, com monitoramento por toda parte. CloudWatch
dica

Para obter orientações mais detalhadas sobre a seleção de computadores, consulte AWS Fargate ou AWS Lambda?

Asynchronous event processing

Você precisa lidar com eventos que não exigem uma resposta imediata, com entrega confiável e a capacidade de absorver picos de tráfego.

Para cargas de trabalho que processam eventos sem uma resposta imediata, o Amazon SQS lida com buffer e nivelamento de carga. O Amazon SNS pode distribuir um único evento para vários assinantes em paralelo. EventBridge filtra eventos por conteúdo e se integra aos aplicativos SaaS. O Step Functions coordena o processamento em várias etapas, com o DynamoDB ou o Amazon S3 para armazenar resultados.

Para implementar o processamento assíncrono, use AWS Lambda para computação e orquestração. AWS Step Functions Encaminhe mensagens com o Amazon Simple Notification Service para distribuição e o Amazon Simple Queue Service para filas duráveis. Armazene os resultados no DynamoDB e no Amazon S3.

Por exemplo, quando um usuário carrega uma foto no Amazon S3, o Amazon S3 publica um evento que invoca uma função do Lambda para gerar uma miniatura. Se você também precisar categorizar a imagem e notificar o usuário, use o Amazon SNS para distribuir esse único evento de upload para várias funções do Lambda processando em paralelo.

dica

Para obter orientações mais detalhadas sobre serviços de integração, consulte Amazon SQS, Amazon SNS ou Amazon? EventBridge

Multi-step workflow orchestration

Você precisa coordenar uma sequência de tarefas com lógica de ramificação, tratamento de erros, novas tentativas e etapas de aprovação humana.

Os fluxos de trabalho padrão lidam com processos que duram até 1 ano com execução de exatamente uma vez e histórico completo de auditoria. Para processamento de alto volume e curta duração (até 5 minutos), os fluxos de trabalho expressos operam com menor custo por execução.

O Step Functions é útil quando você tem fluxos de trabalho com mais de um estado, precisa ramificar ou executar tarefas em paralelo. O serviço Step Functions atua como modelo de estado para seu aplicativo. Os fluxos de trabalho padrão fornecem uma execução única com um histórico de execução completo e auditável, tornando-os adequados para processamento de pedidos, fluxos de trabalho de aprovação humana e pipelines de ETL. Os fluxos de trabalho expressos fornecem execução pelo menos uma vez com maior volume e menor custo, o que os torna adequados para ingestão de dados de IoT, transformações de streaming e processamento de eventos de alta taxa.

dica

Para obter orientações mais detalhadas, consulte Como escolher um serviço de integração de AWS aplicativos.

Real-time streaming data

Você precisa ingerir, processar e analisar dados contínuos de alta velocidade em tempo quase real. O Lambda e o Amazon Kinesis podem processar dados de streaming em tempo real. Os casos de uso incluem rastreamento de atividades, análise de fluxo de cliques, filtragem de registros, telemetria de IoT e medição.

Para AWS integração nativa, o Kinesis Data Streams lida com a ingestão de streams. O Amazon MSK pode ingerir streams com compatibilidade. Apache Kafka O Lambda ou o Fargate processam os dados do stream, com o DynamoDB ou o Amazon S3 para armazenar os resultados.

Para implementar streaming sem servidor, use AWS Lambda para computação e o Amazon Kinesis para coletar e analisar dados em tempo real. Armazene resultados com o DynamoDB e o Amazon S3.

Por exemplo, quando os itens são gravados em uma tabela do DynamoDB, o DynamoDB Streams publica eventos que invocam uma função do Lambda para gerar análises em tempo real. Para ingestão de maior volume, como telemetria de IoT, de milhões de dispositivos, use o Kinesis Data Streams para coletar e armazenar os dados em buffer antes do processamento.

Long-running or batch processing

Você precisa de um processamento que exceda o limite de 15 minutos do Lambda, exija conexões persistentes ou se beneficie de tempos de execução de contêineres personalizados.

Para fluxos de trabalho que excedem 15 minutos, mas consistem em etapas distintas, as funções duráveis do Lambda verificam o progresso e a retomada em todas as invocações. O Step Functions Distributed Map pode processar milhões de itens do Amazon S3, Athena ou JSON em paralelo sem provisionar a computação. O Fargate suporta processamento contínuo, conexões persistentes e controle refinado CPU/memory .

Por exemplo, um pipeline de dados noturno que processa 10 milhões de objetos do Amazon S3 usa o Step Functions Distributed Map para paralelizar o trabalho. Um serviço de transcodificação de vídeo que processa arquivos por mais de 30 minutos usa o Fargate. Um fluxo de trabalho de aprovação de empréstimos em várias etapas que abrange dias usa funções duráveis do Lambda para manter o estado entre as etapas de revisão humana.

dica

Para obter orientações mais detalhadas sobre a seleção de computadores, consulte AWS Fargate ou AWS Lambda?

Isolated execution environments

Você precisa executar código fornecido pelo usuário ou AI-generated código em ambientes isolados com forte separação de inquilinos e preservação do estado.

As microVMs Lambda fornecem VM-level isolamento com tecnologia Firecracker, com recursos completos do sistema operacional, inicialização rápida baseada em instantâneos e vida útil de até 8 horas. Cada microVM recebe um URL HTTPS dedicado com suporte HTTP/2, gRPC e protocolos. WebSocket As microVMs podem ser suspensas quando ociosas para reduzir custos e preservar a memória e o estado do disco. Diferentemente das Funções de Eventos, as microVMs usam um modelo de Dockerfile-based programação, alocam um ambiente por sessão e faturam com base em um modelo de linha de base mais um modelo de intermitência (até 4 vezes a linha de base durante o pico de atividade). Cada microVM oferece suporte a redes de saída configuráveis para acesso VPC e conectividade pública à Internet, sem exigir balanceadores de carga ou infraestrutura de entrada.

Por exemplo, um assistente de codificação de IA fornece a cada sessão de usuário sua própria microVM para executar com segurança o código gerado. Uma plataforma de notebook interativa executa o código de cada aluno em uma microVM isolada que persiste no estado entre as interações.

Use

Agora você deve ter uma compreensão clara de cada serviço AWS sem servidor e qual deles pode ser o mais adequado para sua organização e caso de uso. Para explorar como usar e saber mais sobre cada serviço disponível, a seção a seguir fornece links para documentação detalhada, tutoriais práticos e recursos para você começar.

Serverless compute

AWS Lambda

AWS Fargate

  • Introdução ao Fargate no Amazon ECS Aprenda a executar contêineres no Fargate sem gerenciar servidores. Guia de introdução ao Fargate

  • Criação de um cluster com uma tarefa Fargate Linux usando a AWS CLI Configure um cluster, registre uma definição de tarefa e execute uma tarefa. Tutorial do Fargate CLI

Lambda MicroVMs

API layer

API REST do Amazon API Gateway

API HTTP do Amazon API Gateway

AWS AppSync

URLs de função do Lambda

Application integration

Amazon Simple Queue Service

Amazon Simple Notification Service

Amazon EventBridge

Orchestration

AWS Step Functions

Data storage

Amazon DynamoDB

Amazon Simple Storage Service

Amazon Aurora sem servidor

  • Usando o Amazon Aurora Serverless v2 Saiba como o Amazon Aurora Serverless ajusta automaticamente a capacidade com base na demanda. Guia do Aurora Serverless v2

Deployment and IaC

AWS Serverless Application Model

AWS Cloud Development Kit (AWS CDK)

  • Comece com o AWS Cloud Development Kit (AWS CDK) Crie seu primeiro aplicativo CDK e implante a infraestrutura usando sua linguagem de programação preferida. Tutorial de introdução ao CDK

Terraform

Observability

Amazon CloudWatch

AWS X-Ray

  • Introdução às solicitações de AWS X-Ray rastreamento no Lambda, API Gateway e serviços downstream. X-Ray guia de introdução

  • Escolhendo um serviço de AWS monitoramento e observabilidade Use nosso guia de decisão de monitoramento para obter orientações mais detalhadas sobre ferramentas de observabilidade. Guia de decisão de monitoramento

Explore

Depois de determinar qual abordagem se adequa melhor à sua carga de trabalho, revise esses recursos para ajudá-lo a começar a implementar. Você pode encontrar recursos específicos do serviço na seção anterior e recursos gerais de arquitetura sem servidor na seção a seguir.

  • Diagramas de arquitetura Explore diagramas de arquitetura de referência sem servidor em. AWS Explore os diagramas de arquitetura

  • Workshop de padrões sem servidor Crie microsserviços sem servidor com exercícios práticos que abrangem testes de unidade e integração, infraestrutura como código e padrões arquitetônicos comuns. Workshop de padrões sem servidor no site do AWS Workshops.

  • Serverless Land Explore padrões, blogs, vídeos e recursos de aprendizagem sem servidor da comunidade sem servidor. AWS Padrões e recursos de terras sem servidor

  • Whitepapers Explore os whitepapers para obter melhores práticas sem servidor, orientação de arquitetura e otimização de custos. Explore os whitepapers

  • AWS Soluções Explore soluções aprovadas e diretrizes arquitetônicas para casos comuns de uso sem servidor. Explore as soluções