翻訳は機械翻訳により提供されています。提供された翻訳内容と英語版の間で齟齬、不一致または矛盾がある場合、英語版が優先します。
Amazon Kinesis Data Streams のストリーミングテーブルと S3 配信
Amazon Kinesis Data Streams を使用すると、Kinesis データストリームから Apache Iceberg のストリーミングテーブル (Amazon S3 Tables) または汎用 Amazon S3 バケットの 2 つの宛先タイプにストリーミングデータを配信できます。インフラストラクチャを管理する必要はなく、数分以内に配信を開始できます。Amazon Kinesis Data Streams は、ストリームから読み取り、レコードをバッファして集約し、設定された送信先に配信します。配信はフルマネージド型 – プロビジョニングするコネクタ、コンシューマーアプリケーション、コンピューティングリソースはありません。
これらの機能は、オンデマンドアドバンテージまたはオンデマンドスタンダードキャパシティモードで実行されているストリームでサポートされています。ストリームからの配信を設定し、送信先を指定します。その後、Amazon Kinesis Data Streams はスケーリング、再試行、配信の信頼性を自動的に処理します。配信はストリームの読み取りスループットを消費せず、既存のコンシューマーには影響しません。
トピック
データ配信の仕組み
データ配信は、マネージドパイプラインを介して Kinesis データストリームを配信先に接続します。
オンデマンドモードで Kinesis データストリームにデータを発行します。
ストリーム
CreateChannelで を呼び出し、送信先 (Apache Iceberg のストリーミングテーブル、または汎用 Amazon S3 バケット) を指定します。配信はストリームから読み取り、レコードをバッファし、最適なサイズのファイルに集約します。
配信は、指定したデータ鮮度ウィンドウ内で、設定された宛先にファイルを書き込みます。
配信先
データ配信は、次の 2 つの送信先タイプをサポートしています。
- Apache Iceberg でのテーブルのストリーミング
-
ストリーミングテーブルは、Kinesis データストリームを Amazon S3 Tables に保存されている Apache Iceberg テーブルに継続的に配信します。データが到着すると、データは自動的に最適化された Apache Parquet 形式に変換され、インテリジェントなインライン圧縮により、小さなファイルの問題が排除され、ダウンストリームのクエリコストが削減されます。ストリームに公開されてから数分以内に、Amazon Athena、Amazon EMR、Amazon Managed Service for Apache Flink、または Apache Iceberg をサポートするエンジンを通じてデータがクエリ可能になります。
- 汎用 Amazon S3 バケット
-
Amazon S3 配信は、Kinesis データストリームから S3 バケットに直接ストリーミングデータを書き込みます。レコードは元のソース形式で配信され、変換は適用されません。複数のレコードがバッファされ、最適なサイズのオブジェクトにバッチ処理されます。設定可能な圧縮と、出力キーテンプレートで定義する S3 キー構造があります。これは、未加工のログアーカイブ、イベントリプレイ、ダウンストリームバッチ処理などのユースケースに最適です。この場合、配信パイプラインを管理するオーバーヘッドなしで、ストリーミングデータの耐久性が高く低コストのストレージが必要です。
データフロー
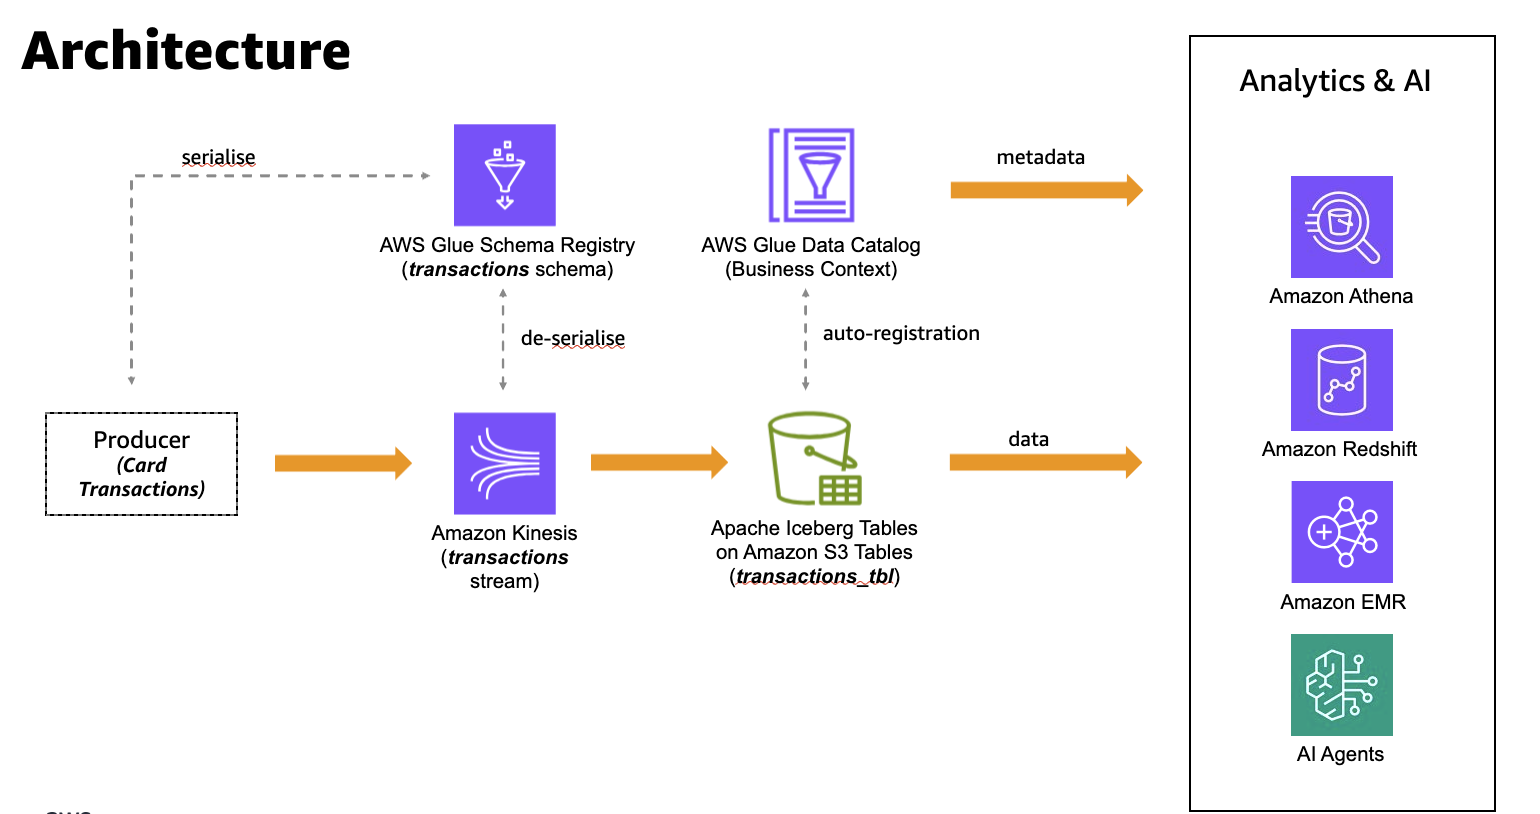
次の図は、Apache Iceberg のストリーミングテーブルに配信するためのend-to-endのデータフローを示しています。この図では、例としてカード取引のユースケースを使用しています。プロデューサーは AWS Glue 、スキーマレジストリのスキーマに対してレコードをシリアル化し、Kinesis データストリームに書き込みます。Amazon Kinesis Data Streams は、Amazon S3 Tables の Apache Iceberg テーブルにレコードを配信します。S3 Tables で分析統合を有効にすると、テーブルメタデータも AWS Glue Data Catalog に登録されます。これはデフォルトでは行われません。その後、配信されたデータとメタデータは、Amazon Athena、Amazon Redshift、Amazon EMR などの分析エンジンと AI エンジンで使用できます。
汎用 Amazon S3 バケットへの配信は、同様のフローに従いますが、2 つの違いがあります。プロデューサーはレコードを Kinesis データストリームに書き込み、Amazon Kinesis Data Streams はレコードを S3 バケットに配信します。レコードは元のソース形式で変換なしで配信されるため、 AWS Glue スキーマレジストリは不要で、テーブルメタデータは AWS Glue データカタログに登録されません。Amazon Kinesis Data Streams は、レコードをバッファして最適なサイズのオブジェクトにバッチ処理し、出力キーテンプレートで定義した S3 キー構造を使用して書き込みます。配信されたオブジェクトは、ダウンストリームのバッチ処理と分析に使用できます。
主な機能
サーバーレス自動スケーリング – ストリームのスループットキャパシティまで、ストリームスループットに合わせて自動的にスケールします。プロビジョニングするコンピューティングリソースはありません。
シャードごとに 1 回限りの配信 – シャードからのレコードは、シャード内で重複や省略なしで、送信先に 1 回だけ配信されます。
ほぼリアルタイムの配信 – 5~15 分 (300~900 秒) の設定可能なデータ鮮度。
自動 Parquet 変換 – Apache Iceberg のストリーミングテーブルの場合、 はストリーミングレコードを最適化された Apache Parquet 形式に変換して、効率的な分析クエリを行います。
インライン圧縮 – レコードを最適なサイズのファイルに集約して、分析クエリのパフォーマンスを実現します。
暗号化 – 送信先でのサーバー側の暗号化のためのカスタマーマネージド AWS KMS キーをサポートします。 AWS マネージドキー (エイリアス)
aws/kinesisは、送信先の暗号化ではサポートされていません。デッドレターキュー – ストリーム ARN、シャード ID、シーケンス番号、エラーコンテキストなど、配信できないレコードの障害メタデータは、S3-basedデッドレターキューに書き込まれます。
CloudWatch メトリクスとログ – Amazon CloudWatch メトリクスを通じて、配信されたバイト数、レコード数、データ鮮度をモニタリングします。Amazon CloudWatch Logs への配信ログ記録を有効にして、トラブルシューティングのために配信バッチの詳細、障害、エラーコンテキストをキャプチャします。
他のコンシューマーに影響を与えない – 拡張ファンアウトスロットや共有スループットを消費しません。
要件
Kinesis データストリームは、オンデマンドスタンダードまたはオンデマンドアドバンテージキャパシティモードを使用する必要があります。
送信先に書き込む配信アクセス許可を付与する IAM サービス実行ロールを作成する必要があります。
レプリケート先バケットまたはテーブルバケットは、Kinesis データストリームと同じリージョンにある必要があります。データ配信は、どちらの送信先タイプでもクロスリージョン配信をサポートしていません。
Apache Iceberg のストリーミングテーブルでは、クロスアカウント配信はサポートされていません。ソースストリーム、レプリケート先 S3 テーブルバケット、 AWS Glue スキーマレジストリはすべて、同じ AWS アカウント リージョンに存在する必要があります。
汎用 Amazon S3 バケットの場合、クロスアカウント配信はレプリケート先バケットでのみサポートされます。チャネルとそのソースストリームは同じ にある必要があります AWS アカウント。送信先バケットのみが別のアカウントにあることができます。
Apache Iceberg でテーブルをストリーミングするには、Amazon S3 でデッドレターキューを設定する必要があります。
