# AWS Glue Studio Glue で Hudi フレームワークを使用する
ジョブを作成または編集すると、AWS Glue Studio では、使用している AWS Glue のバージョンに応じて対応する Hudi ライブラリが自動的に追加されます。詳細は、「[AWS Glue での Hudi フレームワークの使用](https://docs.aws.amazon.com/glue/latest/dg/aws-glue-programming-etl-format-hudi.html)」を参照してください。
## データカタログのデータソースで Apache Hudi フレームワークを使用する
**Hudi データソースフォーマットをジョブに追加するには:**
1. [ソース] メニューで、[AWS Glue Studio データカタログ] を選択します。
1. **[Data source properties]** (データソースのプロパティ) タブで、データベースとテーブルを選択します。
1. AWS Glue Studio に、フォーマットタイプとして Apache Hudi と Amazon S3 URL が表示されます。

## Amazon S3 データソースで Hudi フレームワークを使用する
1. [Source] (ソース) メニューで、[Amazon S3] を選択します。
1. Amazon S3 ソースタイプとしてデータカタログテーブルを選択する場合は、データベースとテーブルを選択します。
1. AWS Glue Studio に、Apache Hudi と Amazon S3 URL がフォーマットとして表示されます。
1. **Amazon S3 ソースタイプ**として Amazon S3 の場所を選択する場合は、**[Browse Amazon S3]** (Amazon S3 を参照) をクリックして Amazon S3 URL を選択します。
1. **[Data format]** (データフォーマット) で、[Apache Hudi] を選択します。
**注記**
AWS Glue Studio が、選択した Amazon S3 フォルダまたはファイルからスキーマを推測できない場合は、**[Additional options]** (追加オプション) を選択し、新しいフォルダまたはファイルを選択します。
**[Additional options]** (追加オプション) の **[Schema inference]** (スキーマ推論) から、次のオプションを選択します。
[AWS Glue Studio にサンプルファイルを自動選択させる] — スキーマを推測できるよう、AWS Glue Studio が Amazon S3 の場所にあるサンプルファイルを選択します。自動選択されたファイルは **[Auto-sampled file]** (自動サンプル化ファイル) フィールドで確認できます。
[Choose a sample file from Amazon S3] (Amazon S3 からサンプルファイルを選択) - **[Browse Amazon S3]** (Amazon S3 を参照) をクリックし、使用する使用する Amazon S3 ファイルを選択します。
1. **[Infer schema]** (スキーマを推測) をクリックします。続いて、**[Output schema]** (出力スキーマ) タブをクリックすると、出力スキーマを確認できます。
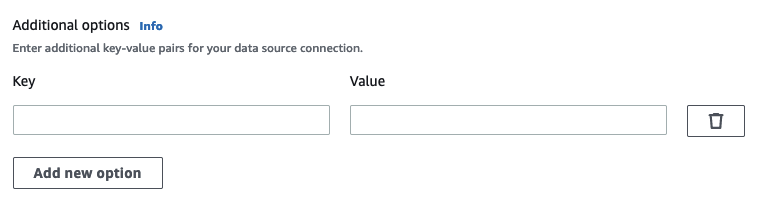
1. **[Additional options]** (追加オプション) をクリックし、キー値ペアを入力します。
## データターゲットで Apache Hudi フレームワークを使用する
### データカタログのデータターゲットで Apache Hudi フレームワークを使用する
1. **[ターゲット]** メニューで [AWS Glue Studio データカタログ] を選択します。
1. **[Data source properties]** (データソースのプロパティ) タブで、データベースとテーブルを選択します。
1. AWS Glue Studio に、フォーマットタイプとして Apache Hudi と Amazon S3 URL が表示されます。
#### Amazon S3 データターゲットで Apache Hudi フレームワークを使用する
値を入力するか、使用可能なオプションの中から選択し、Apache Hudi 形式を設定します。Apache Hudi の詳細については、「[Apache Hudi のドキュメント](https://hudi.apache.org/docs/overview)」を参照してください。

+ **[Hudi Table Name]** (Hudi テーブル名) — お使いの Hudi Table の名前です。
+ **[Hudi Storage Type]** (Hudi ストレージタイプ) — 次の 2 つのうちいずれかを選択します。
+ **[Copy on write]** (書き込み時にコピー) — 読み取りパフォーマンスの最適化のため、推奨されています。こちらはデフォルトの Hudi ストレージタイプです。書き込み中、更新するたびに新しいバージョンのファイルが作成されます。
+ **[Merge on read]** (読み取り時に結合) — 書き込みレイテンシーの最小化のため、推奨されています。更新は、行形式の差分ファイルに記録され、必要に応じて圧縮されて、新しいバージョンの列形式のファイルが作成されます。
+ **[Hudi Write Operation]** (Hudi 書き込みオペレーション) - 次の中から選択します。
+ **[Upsert]** (アップサート) — デフォルトのオペレーションで、入力レコードはインデックスを検索して挿入または更新として最初にタグ付けされます。既存データを更新する場合に推奨されています。
+ **[Insert]** (インサート) — レコードが挿入されます。ただし、既存のレコードはチェックされないため重複する可能性があります。
+ **[Bulk Insert]** (一括インサート) — レコードを挿入します。データの量が多い場合に推奨されています。
+ **[Hudi Record Key Fields]** (Hudi レコードキーフィールド) — 検索バーを使ってプライマリレコードキーを検索し選択します。Hudi のレコードは、レコードキーとレコードが属しているパーティションパスのペアから成るプライマリキーで識別されます。
+ **[Hudi Precombine Field]** (Hudi 事前結合フィールド) — 実際に書き込む前の事前結合で使用されるフィールドです。2 つのレコードのキー値が同じである場合、AWS Glue Studio は、事前結合フィールドの値が大きい方のレコードを選択します。増分値 (例: updated\_at) が属するフィールドを設定します。
+ **[Compression Type]** (圧縮タイプ) — 圧縮タイプ (非圧縮、GZIP、LZO、Snappy) の中から 1 つ選択します。
+ **[Amazon S3 Target Location]** (Amazon S3 ターゲットの場所) — **[Browse S3]** (S3 を参照) をクリックして Amazon S3 ターゲットの場所を選択します。
+ **[Data Catalog update options]** (データカタログ更新オプション) — 次の中から選択します。
+ Do not update the Data Catalog(データカタログを更新しない): (デフォルト) スキーマが変更されたり、新しいパーティションが追加された場合、ジョブでデータカタログを更新したくない場合は、このオプションを選択します。
+ [Create a table in the Data Catalog and on subsequent runs, update the schema and add new partitions] (データカタログにテーブルを作成し、それ以降の実行時にスキーマを更新して新しいパーティションを追加する): このオプションを選択すると、最初のジョブの実行時に、ジョブによりデータカタログにテーブルが作成されます。それ以降のジョブの実行時にスキーマが変更されたり、新しいパーティションが追加されたりすると、ジョブによりデータカタログテーブルが更新されます。
また、データカタログからデータベースを選択し、テーブル名を入力する必要があります。
+ [Create a table in the Data Catalog and on subsequent runs, keep existing schema and add new partitions] (データカタログでテーブル作成し、それ以降の実行時に既存のスキーマの保持して新しいパーティションを追加する): このオプションを選択すると、最初のジョブの実行時に、ジョブによりデータカタログにテーブルが作成されます。それ以降のジョブの実行時に、新しいパーティションを追加するため、ジョブでデータカタログテーブルが更新されます。
また、データカタログからデータベースを選択し、テーブル名を入力する必要があります。
+ Partition keys (パーティションキー): 出力でパーティションキーとして使用する列を選択します。さらにパーティションキーを追加するには、[Add a partition key] (パーティションキーの追加) を選択します。
+ **[Addtional options]** (追加オプション) — 必要に応じてキーと値のペアを入力します。
## AWS Glue Studio によるコード生成
ジョブを保存すると、Hudi のソースまたはターゲットが検出された場合に、次のジョブパラメータがジョブに追加されます。
+ `--datalake-formats` — ビジュアルジョブで、([Format] (形式) を選択することで、直接的またはデータレイクでバックアップされたカタログテーブルを選択することで間接的に) 検出されたデータレイク形式の個別リスト。
+ `--conf ` — `--datalake-formats` の値に基づいて生成される。例えば、`--datalake-formats` の値が「hudi」である場合、AWS Glue はこのパラメータの `spark.serializer=org.apache.spark.serializer.KryoSerializer —conf spark.sql.hive.convertMetastoreParquet=false` の値を生成します。
## AWS Glue が提供したライブラリのオーバーライド
AWS Glue でサポートされていない Hudi のバージョンを使用するには、独自の Hudi ライブラリ JAR ファイルを指定します。独自の JAR ファイルを使用するには:
+ `--extra-jars` ジョブパラメータを使用します。例えば、`'--extra-jars': 's3pathtojarfile.jar'`。詳細については、「[AWS Glue ジョブのパラメータ](https://docs.aws.amazon.com/glue/latest/dg/aws-glue-programming-etl-glue-arguments.html)」を参照してください。
+ `--datalake-formats` ジョブパラメータの値として、`hudi` を含めることはできません。値として空白の文字列を入力すると、AWS Glue はデータレイクライブラリを自動的に提供することができません。詳細は、「[AWS Glue での Hudi フレームワークの使用](https://docs.aws.amazon.com/glue/latest/dg/aws-glue-programming-etl-format-hudi.html)」を参照してください。