翻訳は機械翻訳により提供されています。提供された翻訳内容と英語版の間で齟齬、不一致または矛盾がある場合、英語版が優先します。
# AWS データベースサービスの選択
**最初のステップを実行する**
| | |
| --- |--- |
| **目的** | どの AWS データベースが組織に最適かを判断するのに役立ちます。 |
| **最終更新日** | 2026 年 6 月 2 日 |
| **対象サービス** | + [Amazon Aurora](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_AuroraOverview.html)
+ [Amazon Aurora DSQL](https://docs.aws.amazon.com/aurora-dsql/latest/userguide/what-is-aurora-dsql.html)
+ [Amazon Aurora PostgreSQL Limitless Database](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/limitless.html)
+ [Amazon DocumentDB (MongoDB 互換性)](https://docs.aws.amazon.com/documentdb/latest/developerguide/what-is.html)
+ [Amazon DynamoDB](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/Introduction.html)
+ [Amazon ElastiCache](https://docs.aws.amazon.com/AmazonElastiCache/latest/dg/WhatIs.html)
+ [Amazon Keyspaces (Apache Cassandra 向け)](https://docs.aws.amazon.com/keyspaces/latest/devguide/what-is-keyspaces.html)
+ [Amazon MemoryDB](https://docs.aws.amazon.com/memorydb/latest/devguide/what-is-memorydb.html)
+ [Amazon Neptune](https://docs.aws.amazon.com/neptune/latest/userguide/intro.html)
+ [Amazon Relational Database Service](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/Welcome.html) (Amazon RDS)
+ [Amazon Timestream](https://docs.aws.amazon.com/timestream/latest/developerguide/what-is-timestream.html) |
## 序章
AWS は、さまざまなワークロードをサポートするために、さまざまなデータモデルで増え続けるデータベースオプション (15 以上) を提供しています。これには、リレーショナル、キーバリュー、ドキュメント、インメモリ、グラフ、時系列、ベクトル、およびワイド列が含まれます。
適切なデータベースまたは複数のデータベースを選択するには、組織のニーズに基づいて一連の決定を行う必要があります。この決定ガイドは、適切な質問を行い、実装の明確な道筋を提供し、既存のデータベースから移行するのに役立ちます。
[](https://www.youtube.com/watch?v=MSB_mHUJUaA)
## を理解する
データベースは、データを効率的に保存、管理、取得し、あらゆるタイプとサイズのアプリケーションの整合性、スケーラビリティ、パフォーマンスを確保する重要なバックエンドシステムです。
この決定ガイドは、利用可能な選択肢の範囲を理解し、データベースを選択するための基準を確立し、各データベースの一意のプロパティに関する詳細情報を提供するのに役立つように設計されています。その後、各データベースが提供する機能の詳細を確認できます。
**データベースを使用して AWS 構築するアプリケーションのプロパティは何ですか?**
+ **インターネットスケールアプリケーション:** これらのアプリケーションは、数百テラバイトのデータにわたって 1 秒あたり 1 億件以上のリクエストを処理できます。ワークロードに柔軟性を提供するために、垂直方向と水平方向に自動的にスケーリングされます。
+ **リアルタイムアプリケーション:** キャッシュ、セッションストア、ゲームリーダーボード、ライドハイリング、広告ターゲティング、リアルタイム分析などのリアルタイムアプリケーションでは、1 秒あたり 1 兆件以上のリクエストをサポートするためにマイクロ秒単位のレイテンシーと高スループットが必要です。
+ **エンタープライズアプリケーション:** エンタープライズアプリケーションは、コアビジネスプロセス (売上、請求、カスタマーサービス、人事など) とline-of-businessプロセス (ホテルチェーンの予約システムや保険会社のリスク管理システムなど) を管理します。これらのアプリケーションには、高速、スケーラブル、セキュア、可用性、信頼性を備えたデータベースが必要です。
+ **ベクトルデータベースと生成 AI アプリケーションでのベクトル検索:** 使用するデータベースサービスには、ドメイン固有のデータ (財務記録、ヘルスレコード、ゲノムデータ、サプライチェーン情報など) が豊富に含まれている可能性があります。このデータにより、お客様のビジネスや、事業を展開するより広範な業界について、ユニークで貴重な視点を得ることができます。生成 AI を使用するには、セマンティックコンテキストに使用するドメイン固有のデータを一連の要素としてエンコードし、それぞれを内部的に「ベクトル」として表現する必要があります。このコンテキストに関連するデータは通常、内部データベース、データレイク、または非構造化データやドキュメントストア、つまりドメイン固有のデータや知識をホストするデータストアから取得されます。これらのデータストアは、一般的にナレッジベースと呼ばれます。[Retrieval Augmented Generation (RAG)](https://docs.aws.amazon.com/sagemaker/latest/dg/jumpstart-foundation-models-customize-rag.html) は、これらのナレッジベースから事実を取得して、up-to-dateで正確で洞察力のあるデータを持つ[大規模言語モデル (LLMs) を](https://aws.amazon.com/what-is/large-language-model/)グラウンドするプロセスです。次の図で説明されているように、 [AWS は AWS データベースおよび検索サービスにベクトル機能を追加](https://aws.amazon.com/blogs/database/the-role-of-vector-datastores-in-generative-ai-applications/)しました。これにより、データがある場所にベクトルデータセットを保存し、アプリケーションアーキテクチャを簡素化し、試行済み、テスト済み、使い慣れたツールを使用できます。ベクトルデータベースまたはベクトルデータストアは、ベクトル機能を持つデータベースを意味します。このようなデータベースは、生成 AI でデータを使用する方法をさらに強化することもできます。

**注記**
このガイドでは、オンライントランザクション処理 (OLTP) アプリケーションに適したデータベースに焦点を当てています。大量のデータを迅速かつ効率的に保存および分析する必要がある場合 (通常 OLAP アプリケーションで満たされる要件)、 は [Amazon Redshift](https://docs.aws.amazon.com/redshift/latest/mgmt/welcome.html) AWS を提供します。Amazon Redshift は、大規模な分析ワークロードを処理するように設計された、フルマネージド型のクラウドベースのデータウェアハウスサービスです。
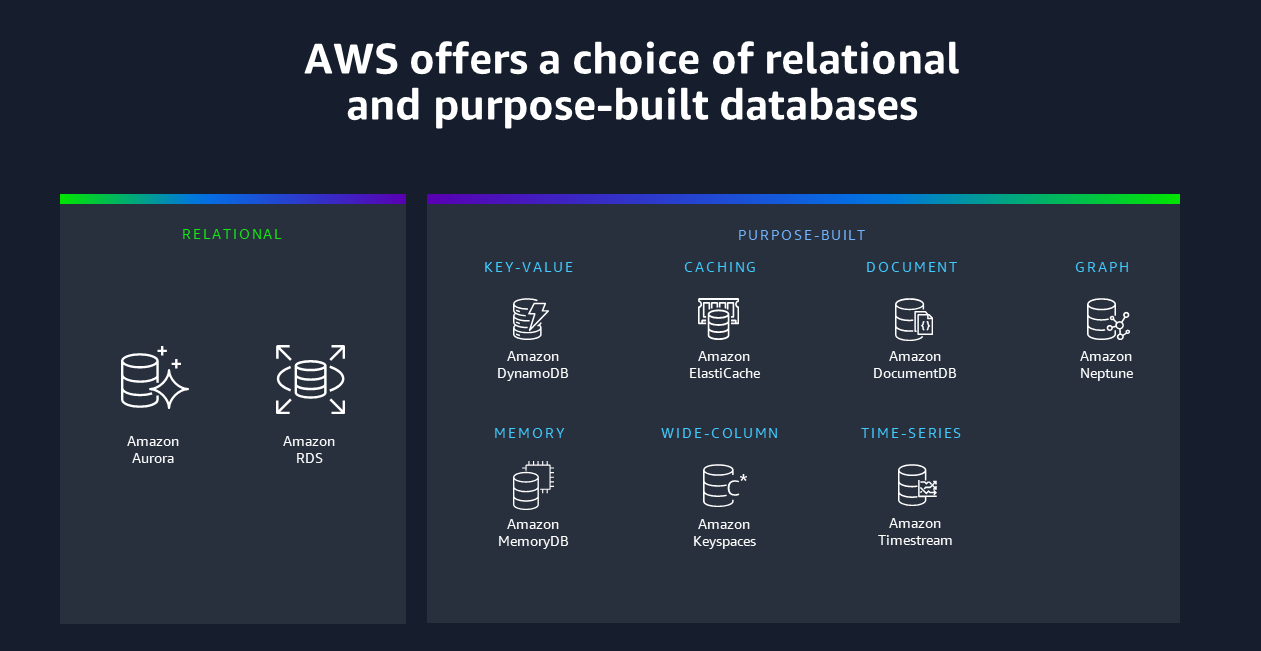
OLTP データベースには、リレーショナルと非リレーショナルの 2 AWS つの大まかなカテゴリがあります。
+ AWS リレーショナルデータベースファミリーには、Amazon Aurora と Amazon RDS 用の 9 つの一般的なエンジンが含まれています。Amazon Aurora エンジンには、Amazon Aurora with PostgreSQL 互換エディション、Amazon Aurora MySQL 互換エディション、Amazon Aurora DSQL が含まれています。Amazon RDS エンジンには、PostgreSQL、MySQL、MariaDB、SQL Server、Oracle、Db2 が含まれます。
+ 非リレーショナルデータベースオプションは、特定のデータモデル向けに設計されています。これには、キー値、ドキュメント、キャッシュ、インメモリ、グラフ、時系列、およびワイド列データモデルが含まれます。
これらはすべて、このガイドの [選択](#db-choose)セクションで詳しく説明します。
**データベース移行**
使用するデータベースサービスを決定する前に、ビジネス目標、データベースの選択、既存のデータベースの移行方法を考慮する必要があります。
最適なデータベース移行戦略は、 を最大限に活用するのに役立ちます AWS クラウド。これには、専用クラウドデータベースを使用するようにアプリケーションを移行することが含まれる場合があります。RDS for PostgreSQL や RDS for MySQL など、既存のデータベースのフルマネージドバージョンを使用する利点が必要な場合があります。
または、Oracle や SQL Server などの商用ライセンスデータベースから Amazon Aurora に移行することもできます。アプリケーションをモダナイズし、アプリケーションのワークフロー要件に最適なデータベースを選択することを検討してください。
[Amazon Aurora DSQL](https://docs.aws.amazon.com/aurora-dsql/latest/userguide/what-is-aurora-dsql.html) は、アクティブ/アクティブマルチリージョンレプリケーション、強力な整合性、プロビジョニングや管理を行うインフラストラクチャのないサーバーレス分散 SQL データベースです。Aurora DSQL は PostgreSQL と互換性があり、ワークロードに基づいてコンピューティング、I/O、ストレージを自動的にスケーリングします。Aurora DSQL は、データベースインフラストラクチャを管理せずにリレーショナルデータモデルの利点を必要とするマイクロサービス、サーバーレス、イベント駆動型のアーキテクチャでトランザクションワークロードをサポートします。
[Amazon Aurora PostgreSQL Limitless Database](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/limitless.html) は、シャーディングによる自動水平スケーリング、1 秒あたり数百万の書き込みトランザクションの処理、ペタバイト単位のデータの管理を提供しながら、単一のデータベース内で簡単に操作できます。Limitless Database は、リレーショナルワークロードが単一の Aurora インスタンスの制限を超える書き込みスループットまたはストレージを必要とする場合に使用します。
最初にアプリケーションを移行してから変換することを選択した場合は、再プラットフォームを決定できます。このプロセスでは、使用するアプリケーションに変更はありませんが、クラウド内のフルマネージドサービスを活用できます。データベースが に完全に含まれたら AWS クラウド、アプリケーションのモダナイズ作業を開始できます。この戦略は、現在のオンプレミス環境を迅速に終了し、モダナイゼーションに集中するのに役立ちます。
を使用して [AWS Database Migration Service](https://aws.amazon.com/dms/) Amazon Aurora にデータを移動できます。移行戦略に役立つリソースについては、[Explore](#db-explore)「」セクションを参照してください。
## 考慮する
でデータベースをホストすることを検討しています AWS。これは、クラウド移行ジャーニーの最初のステップとしてグリーンフィールド/パイロットプロジェクトをサポートする場合や、中断を最小限に抑えて既存のワークロードを移行したい場合があります。または、ワークロードを マネージドに移植したり AWS のサービス、完全にクラウドに焦点を当てるようにリファクタリングしたりすることもできます。
もちろん、データベースを選択する際の最初の主な考慮事項は、ビジネス目標です。組織を変革へと導いている戦略的方向性は何ですか? 商用ライセンスにコミットする必要がないように、既存のワークロードをリホストするか、新しいプラットフォームにリファクタリングするかを検討してください。
目的が何であっても、適切な基準を考慮すると、データベースの決定が容易になります。考慮すべき主要な基準の概要を次に示します。
------
#### [ Migration strategy ]
リホスト戦略を選択して、データ移行の問題を減らしながら、クラウドに迅速にデプロイできます。Amazon Elastic Compute Cloud (Amazon EC2) にデータベースエンジンソフトウェアをインストールし、データを移行して、オンプレミスで管理するのと同じ方法でデータベースを管理します。リホストはクラウドへの迅速な道ですが、アップグレード、パッチ、バックアップ、容量の計画と管理、パフォーマンスの維持、可用性の目標などの運用タスクは残されています。
または、オンプレミスのリレーショナルデータベースをフルマネージド Amazon RDS インスタンスに移行する再プラットフォーム戦略を選択することもできます。
これは、ワークロードをクラウドに焦点を当てるようにリファクタリングする機会と考えることができます。例えば、Amazon Aurora または Amazon DynamoDB、Amazon Neptune、Amazon DocumentDB (MongoDB 互換) などの専用 NoSQL データベースを使用できます。
最後に、 はサーバーレスデータベース AWS を提供します。サーバーレスデータベースは、pay-for-use料金モデルと組み込みの高可用性により、アプリケーションの需要に合わせて拡張できます。サーバーレスデータベースを使用すると、俊敏性を高め、コストを最適化できます。サーバーのプロビジョニング、パッチ適用、管理が不要になるだけでなく、多くの AWS サーバーレスデータベースにはダウンタイムを短縮するメンテナンスオプションが用意されています。
AWS サーバーレスサービスには、Amazon Aurora DSQL、Amazon Aurora Serverless、Amazon DynamoDB、Amazon ElastiCache、Amazon Keyspaces (Apache Cassandra 向け)、Amazon Timestream for LiveAnalytics、Amazon Neptune Serverless などがあります。
------
#### [ Characteristics of your data ]
任意のデータベース選択の中核には、保存、取得、分析、操作に必要なデータの特性が含まれます。これには、以下が含まれます。
+ データモデル。たとえば、リレーショナル、構造化、半構造化、時系列、ベクトル、または高度に接続されたデータセットを使用していますか?
+ データアクセス。データへのアクセス方法
+ リアルタイムデータが必要な範囲。
+ 特定のデータレコードサイズが考慮されているかどうか。
------
#### [ Operational considerations ]
運用上の主な考慮事項は、データの場所と管理方法です。実行する必要がある 2 つの主要な選択肢は次のとおりです。
+ **データベースはセルフホスト型またはフルマネージド型ですか?**: ここでの中核となる質問は、チームがビジネスに最大の価値を提供する場所です。データベースがセルフホスト型である場合は、データベースのday-to-dayメンテナンス、モニタリング、パッチ適用を担当します。
フルマネージド AWS 型データベースを選択すると、未分化のデータベース管理タスクが削除され、作業が簡素化されます。このオプションを使用すると、チームはスキーマ設計、クエリ構築、クエリ最適化を改善することで、価値の提供に集中できます。チームは、ビジネス目標に沿ったアプリケーションを開発することもできます。
+ **サーバーレスデータベースまたはプロビジョニングされたデータベースが必要ですか?**: まず、[Amazon Aurora DSQL](https://docs.aws.amazon.com/aurora-dsql/latest/userguide/what-is-aurora-dsql.html)、[Amazon DynamoDB](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/Introduction.html)、[Amazon Keyspaces (Apache Cassandra 用)](https://docs.aws.amazon.com/keyspaces/latest/devguide/what-is-keyspaces.html)、[Amazon Timestream for LiveAnalytics](https://docs.aws.amazon.com/timestream/latest/developerguide/what-is-timestream.html)、[Amazon ElastiCache](https://docs.aws.amazon.com/AmazonElastiCache/latest/dg/WhatIs.html)、[Amazon Neptune](https://docs.aws.amazon.com/neptune/latest/userguide/intro.html)、[Amazon Aurora](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_AuroraOverview.html) へのリンクを確認してください。プロビジョニングされたスループット容量とスケーリングに関するドキュメント。さらに、[Amazon Aurora Serverless v2 ](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-serverless-v2.html)のこのガイダンスでは、可変性の高いワークロードに適している理由について説明します (たとえば、データベースの使用量が短時間多くなり、その後に長時間の軽いアクティビティやまったくアクティビティがないなど)。
------
#### [ Resiliency, performance, and security ]
データベースの選択によって、必要な耐障害性、パフォーマンス、およびセキュリティレベルが提供されるようにすることが重要です。
+ 耐障害性 - データベースの耐障害性は、あらゆるビジネスにとって重要です。回復性を実現するには、バックアップと復元、レプリケーション、フェイルオーバー、point-in-timeリカバリ (PITR) の機能など、多くの重要な要素に注意する必要があります。
+ パフォーマンス - データベースがトランザクションの高い同時実行数 (10,000 以上) をサポートする必要があるかどうか、および複数の地理的リージョンにデプロイする必要があるかどうかを検討します。ワークロードがマイクロ秒 (1 桁ミリ秒ではなく) で測定される応答時間で非常に高い読み取りパフォーマンスを必要とする場合は、[Amazon ElastiCache](https://docs.aws.amazon.com/AmazonElastiCache/latest/dg/WhatIs.html) などのメモリ内キャッシュソリューションをデータベースと一緒に使用することや、[Amazon MemoryDB](https://docs.aws.amazon.com/memorydb/latest/devguide/what-is-memorydb.html) などの完全に耐久性があり永続的なメモリ内データベースを使用することを検討することをお勧めします。
+ セキュリティ - セキュリティは、 AWS とお客様の[間の責任](https://aws.amazon.com/compliance/shared-responsibility-model/)共有です。責任 AWS 共有モデルでは、これを が AWS 管理するクラウドのセキュリティと、お客様が管理するクラウド内のセキュリティと定義しています。具体的なセキュリティ上の考慮事項には、データのあらゆるレベルでのデータ保護、認証、コンプライアンス、データセキュリティ、機密データの保存、監査要件のサポートなどがあります。
------
#### [ Vector database and vector search considerations ]
AWS のサービス ベクトルデータベースまたはベクトル検索機能を備えた を選択するときは、まず、探索しているサービスにチームがどの程度精通しているかについて考えます。開発者チームが特定のデータベースエンジンにすでに精通している場合、ベクトル検索に同じデータベースエンジンを使用すると、既存の知識をより有効に活用し、より迅速に開発できます。開発者は、新しいスキルセットを学習する代わりに、現在のスキル、ツール、フレームワーク、プロセスを使用して、既存のデータベースエンジンの新機能を含めることができます。これがお客様の状況にどのように適用されるかは次のとおりです。
+ データベースエンジニアのチームは、[Amazon Aurora](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Aurora.AuroraPostgreSQL.html) PostgreSQL でホストされている 100 個のリレーショナルデータベースのセットをすでに管理している場合があります。アプリケーションのベクトル検索要件を持つ新しいデータベースをサポートする場合は、まず既存の Amazon Aurora PostgreSQL データベースで pgvector 拡張機能を評価する必要があります。一方、チームが PostgreSQL のコミュニティバージョンを使用することを希望する場合、[Amazon RDS for PostgreSQL](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/CHAP_PostgreSQL.html) は [pgvector](https://github.com/pgvector/pgvector) 拡張機能もサポートします。
+ 同様に、チームがグラフデータを使用している場合は、既存の AWS インフラストラクチャとシームレスに統合され、便利なグラフクエリと視覚化機能を提供する [Amazon Neptune Analytics](https://docs.aws.amazon.com/neptune-analytics/latest/userguide/what-is-neptune-analytics.html) の使用を検討してください。[GraphRAG](https://aws.amazon.com/blogs/database/using-knowledge-graphs-to-build-graphrag-applications-with-amazon-bedrock-and-amazon-neptune/) のユースケースや、大量のグラフデータを分析してインサイトを取得し、傾向を見つけるのに最適です。
+ 一般的なオープンソースデータストア Valkey および Redis OSS で作業し、リアルタイムアプリケーション用に高度にスケーラブルなインメモリデータベースが必要な場合は、[Amazon MemoryDB](https://docs.aws.amazon.com/memorydb/latest/devguide/what-is-memorydb.html) の使用を検討してください。使い慣れたインターフェイスを提供するため、チームは既存の Valkey および Redis OSS の知識とクライアントライブラリを使用でき、Amazon MemoryDB のフルマネージド、耐久性、スケーラブルな機能を活用できます。Amazon MemoryDB のベクトル検索は、Amazon MemoryDB の機能を拡張します。既存の Amazon MemoryDB 機能と組み合わせて使用できます。ベクトル検索を使用しないアプリケーションは、ベクトル検索が存在していることによる影響を受けません。ベクトル検索は、Amazon MemoryDB が利用可能なすべてのリージョンで使用できます。Amazon MemoryDB のベクトル検索は、ピークパフォーマンスとスケールが最も重要な選択基準であるユースケースに最適です。既存の Amazon MemoryDB データ、または Valkey または Redis OSS API を使用して、機械学習と生成 AI のユースケースを構築できます。これには、取得拡張生成、異常検出、ドキュメント取得、リアルタイムレコメンデーションが含まれます。
+ 現在のテクノロジースタックでベクトル検索がサポートされていない場合は、サーバーレスサービスを活用してベクトル検索のニーズのギャップを埋めることができます。例えば、[OpenSearch Serverless](https://docs.aws.amazon.com/opensearch-service/latest/developerguide/what-is.html) を使用すると、クラスターを作成または管理しなくても、[Amazon Bedrock](https://docs.aws.amazon.com/bedrock/latest/userguide/what-is-bedrock.html) コンソールでエクスペリエンス[をすばやく](https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base-create.html)作成できます。データが [Amazon DynamoDB ](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/Introduction.html)に保存されている場合、OpenSearch Serverless はゼロ ETL 統合を使用したベクトル検索に最適です。
+ 大規模なコスト最適化ベクトルストレージの場合、[Amazon S3 Vectors ](https://aws.amazon.com/s3/features/vectors/)はベクトルデータを Amazon S3 に直接保存およびクエリするためのネイティブサポートを提供します。S3 Vectors は、AI エージェント、推論、RAG、セマンティック検索ワークロードを 10 億ベクトル規模でサポートしています。
次の表は、生成 AI ワークロードに適したオプションを選択するのに役立つ、 AWS データベースサービス全体のベクトル機能をまとめたものです。
| サービス | ベクトル機能 | レイテンシー | 適しているチーム |
| --- | --- | --- | --- |
| OpenSearch Service | ネイティブ k-NN | 低~中 | 大規模な RAG、ハイブリッド検索、ログ分析 |
| Amazon Aurora PostgreSQL | pgvector 拡張機能 | 低 | ベクトルとトランザクションデータを必要とするリレーショナルアプリを 1 つのデータベースにまとめる |
| Amazon MemoryDB | ネイティブベクトル検索 | ミリ秒未満 | セマンティックキャッシュ、リアルタイム推論、ultra-low-latencyの取得 |
| Amazon Neptune Analytics | ベクトル類似性 \+ グラフ分析 | 中 | GraphRAG、knowledge-graph-enhanced RAG パイプライン |
| Amazon DocumentDB | ネイティブベクトル検索 (HNSW/IVFFlat インデックス) | 低 | ベクトル検索要件を持つ MongoDB 互換アプリケーション |
| Amazon S3 Vectors | ネイティブベクトルストレージとクエリ | より高い | 10 億ベクトル規模でのコスト最適化バルクベクトルストレージ |
| Amazon DynamoDB | ネイティブベクトル検索 (ベクトルインデックス) \+ OpenSearch へのゼロ ETL | 可変 | ベクトル検索が補完的なワークロードであるオペレーションストア |
考慮すべき追加の基準には、実装のしやすさ、スケーラビリティ、パフォーマンスなどがあります。このブログでは、[生成 AI アプリケーションのデータベースを選択する際の重要な考慮事項](https://aws.amazon.com/blogs/database/key-considerations-when-choosing-a-database-for-your-generative-ai-applications/)について詳しく説明します。
------
## 選択
データベースオプションを評価する基準がわかったので、どの AWS データベースサービスが組織に適しているかを選択する準備が整いました。
この表は、各 AWS データベースエンジンとそのデータモデル、ユースケース、最適化を示しています。これを使用して、ユースケースに最適なデータベースを判断します。
| データベースエンジン | データモデル | いつ使用しますか? | 何に最適化されていますか? |
| --- |--- |--- |--- |
| [**Amazon Aurora**](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_AuroraOverview.html) | リレーショナル | オンプレミスのリレーショナルワークロードを移行またはモダナイズする場合や、ワークロードのクエリパターンが予測しにくい場合は、 を使用します。標準 MySQL の最大 5 倍のスループットで MySQL および PostgreSQL 互換エンジンをサポートします。 | テーブル、行、列に保存される構造化データ用に最適化されています。リレーショナルデータベースは、結合による複雑なクエリをサポートします。 |
| [**Amazon Aurora DSQL**](https://docs.aws.amazon.com/aurora-dsql/latest/userguide/what-is-aurora-dsql.html) | リレーショナル | アクティブ/アクティブマルチリージョンレプリケーション、強力な整合性、管理するサーバーのない分散 SQL がアプリケーションに必要な場合に使用します。 | ACID トランザクション、リレーショナルモデル、サーバーレス自動スケーリングを必要とする OLTP ワークロード。PostgreSQL 互換。 |
| --- |--- |--- |--- |
| [**Amazon Aurora PostgreSQL Limitless Database**](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/limitless.html) | リレーショナル | 単一のデータベースエクスペリエンスを維持しながら、リレーショナルワークロードが単一の Aurora インスタンスの制限を超える書き込みスループットまたはストレージを必要とする場合に使用します。 | 自動シャーディングによる 1 秒あたり数百万の書き込みトランザクションとペタバイト規模のストレージ。PostgreSQL 互換。 |
| [**Amazon RDS**](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/Welcome.html) | リレーショナル | PostgreSQL MariaDB 、SQL Server、Oracle、Db2 の 6 つの一般的なエンジンから選択できるフルマネージドリレーショナルデータベースが必要な場合は、 を使用します。 MySQL | 完全な SQL サポート、自動バックアップ、ソフトウェアパッチ適用、高可用性のためのマルチ AZ 配置により、構造化データ用に最適化されています。 |
| --- |--- |--- |--- |
| [**Amazon DynamoDB**](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/Introduction.html) | Key-value | セッションストアやショッピングカートなどのワークロードに を使用します。キーバリューデータベースは、分散処理とストレージを通じて数百万の同時ユーザーに対応しながら、大量のデータと非常に高いリクエストスループットにスケールできます。 | サーバーレスの NoSQL フルマネージドデータベースに 1 桁ミリ秒のパフォーマンスをあらゆる規模で提供するように最適化されています。 |
| [**Amazon DocumentDB (MongoDB 互換性)**](https://docs.aws.amazon.com/documentdb/latest/developerguide/what-is.html) | ドキュメント | ドキュメントのフィールド全体で豊富なクエリ機能を備えた JSON のようなドキュメントを保存する場合に使用します。 | 多層属性を持つドキュメントとして半構造化データを保存するために最適化されています。 |
| --- |--- |--- |--- |
| [**Amazon Keyspaces (Apache Cassandra 向け)**](https://docs.aws.amazon.com/keyspaces/latest/devguide/what-is-keyspaces.html) | ワイドカラム | オンプレミスの Cassandra ワークロードを移行する必要がある場合、または 1 桁ミリ秒のレイテンシーを必要とするアプリケーションでデータを高速で処理する必要がある場合に使用します。 | 高読み取り/書き込みと高スループットを必要とするワークロードに最適化され、低レイテンシーと線形スケーラビリティが組み合わされます。 |
| [**Amazon Neptune**](https://docs.aws.amazon.com/neptune/latest/userguide/intro.html) | グラフ | ソーシャルネットワーク、不正検出、レコメンデーションエンジンのユースケースなど、オブジェクトの複雑なネットワークをモデル化する必要がある場合に使用します。 | 多数の関係を横断して評価し、レイテンシーを最小限に抑えながらパターンを識別するために最適化されています。 |
| --- |--- |--- |--- |
| [**Amazon ElastiCache**](https://docs.aws.amazon.com/AmazonElastiCache/latest/dg/WhatIs.html) | インメモリ | 読み取りパフォーマンスを向上させるためにキャッシュレイヤーが必要な場合は、 を使用します。サーバーレスおよびノードベースのデプロイオプションで Valkey、Memcached、Redis OSS エンジンをサポートします。 | 頻繁にアクセスされるデータのエフェメラルキャッシュとしてマイクロ秒の読み取りとサブミリ秒の書き込みをサポートするように最適化されています。 |
| [**Amazon MemoryDB**](https://docs.aws.amazon.com/memorydb/latest/devguide/what-is-memorydb.html) | インメモリ | ミリ秒未満の読み込みレイテンシーで完全なデータ永続性が必要な場合は、 を使用します。マイクロサービスアーキテクチャの高性能プライマリデータベースとして最適です。 | マイクロ秒の読み取りと 1 桁のミリ秒の書き込み、マルチ AZ の耐久性を備えた耐久性のあるインメモリデータベースとして最適化されています。 |
| --- |--- |--- |--- |
| [**Amazon Timestream**](https://docs.aws.amazon.com/timestream/latest/developerguide/what-is-timestream.html) | 時系列 | モノのインターネット (IoT) データ、アプリケーションメトリクス、アセット追跡など、多数のソースからの可能性のある大量の時系列データがある場合に使用します。 | タイムスタンプとトレンドラインに関連付けられたデータの保存とクエリ用に最適化されています。 |
## 使用アイテム
このセクションでは、選択したデータベースサービスの詳細と、それらの使用を開始する方法について説明します。
選択したデータベースは、すべての要件を満たしていない可能性があるため、ニーズとワークロードの要件を慎重に検討することが重要です。
このガイドで説明されている考慮事項、独自の「必須」要件、および柔軟性のある要件に基づいて優先順位を付けます。これにより、効果的なトレードオフを行い、ニーズに最適な結果を得ることができます。
また、通常、最適なデータベースを組み合わせてアプリケーション要件に対応できることも考慮してください。複数のデータベースタイプでソリューションを構築することで、各タイプが提供する強みを活用できます。
たとえば、e コマースのユースケースでは、半構造化データによって提供される柔軟性のために Amazon DocumentDB (製品カタログとユーザープロファイル用) を使用できますが、DynamoDB によって提供される予測可能な低レイテンシー (ユーザーが製品カタログを閲覧している場合) と組み合わせることができます。リレーショナルデータモデルとトランザクションのサポートが必要なインベントリ処理と注文処理の組み合わせに Aurora を追加することもできます。
利用可能な各 AWS データベースサービスの詳細については、各サービスの仕組みを調べるためのパスが用意されています。次のセクションでは、入門に役立つ詳細なドキュメント、実践的なチュートリアル、リソースへのリンクを提供します。
------
#### [ Amazon Aurora ]
+ **Amazon Aurora の開始方法**
このガイドにはチュートリアルが含まれており、さまざまな種類のエンドポイントや Aurora クラスターをスケールアップ/スケールダウンする方法など、より高度な Aurora の概念と手順について説明します。
[ガイドを見る](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_GettingStartedAurora.html)
+ **Amazon Aurora PostgreSQL エクスプレス設定**
一般的なワークロード用に最適化された事前設定されたデフォルトを使用して、効率的なデータベース作成を数秒で開始できます。
[ガイドを見る](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_GettingStartedAurora.AuroraPostgreSQL.ExpressConfig.html)
+ **Amazon Aurora の高可用性**
Amazon Aurora には、クラスター内の DB インスタンスの一部またはすべてが使用できなくなっても、データの安全性を維持するのに役立つ高可用性機能が含まれています。また、これらの機能により、少なくとも 1 つの DB インスタンスがアプリケーションからのデータベースリクエストを処理する準備が整います。
[ガイドを見る](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Concepts.AuroraHighAvailability.html)
+ **Amazon Aurora グローバルデータベースを使用する**
Aurora グローバルデータベースの使用を開始します。このガイドでは、Aurora MySQL および Aurora PostgreSQL を使用する Aurora グローバルデータベースでサポートされているエンジンと AWS リージョン 可用性の概要を説明します。
[ガイドを見る](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-global-database-getting-started.html)
------
#### [ Amazon Aurora DSQL ]
+ **Amazon Aurora DSQL の開始方法**
最初の Aurora DSQL クラスターを作成し、PostgreSQL 互換ドライバーとツールを使用して接続します。Aurora DSQL はサーバーレスで、管理するインフラストラクチャはありません。
[Aurora DSQL の使用を開始する](https://docs.aws.amazon.com/aurora-dsql/latest/userguide/getting-started.html)
+ **マルチリージョンクラスター**
強力な整合性、自動障害復旧、99.999% の可用性を備えたアクティブ/アクティブマルチリージョンクラスターを設定します。
[マルチリージョン設定の詳細](https://docs.aws.amazon.com/aurora-dsql/latest/userguide/multi-region.html)
+ **SQL 機能の互換性**
Aurora DSQL でサポートされている PostgreSQL の機能、式、データ型を確認します。
[ガイドを見る](https://docs.aws.amazon.com/aurora-dsql/latest/userguide/working-with-postgresql-compatibility.html)
------
#### [ Amazon Aurora Limitless ]
+ **Amazon Aurora PostgreSQL Limitless Database の使用**
自動水平シャーディングを使用して、単一インスタンス Aurora の制限を超えてスケールします。1 秒あたり数百万の書き込みトランザクションを処理し、単一データベースエクスペリエンスを維持しながらペタバイトのデータを管理します。
[Limitless Database の詳細](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/limitless.html)
+ **Limitless データベースアーキテクチャ**
1 つのデータベースイメージをクライアントに提示しながら分散処理を可能にするルーターとシャードの 2 層アーキテクチャについて説明します。
[アーキテクチャの詳細](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/limitless-architecture.html)
+ **Limitless Database の開始方法**
最初の Limitless Database DB シャードグループを作成し、テーブルのシャーディングを設定します。
[シャーディングの使用を開始する](https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/limitless-get-started.html)
------
#### [ Amazon RDS ]
+ **Amazon RDS の開始方法 **
Amazon RDS を使用して DB インスタンスを作成して接続します。DB2、MariaDB、MySQL、Microsoft SQL Server、Oracle、または PostgreSQL を使用する DB インスタンスを作成する方法について説明します。
[ガイドを見る](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/CHAP_GettingStarted.html)
+ **PostgreSQL データベースを作成して接続する **
PostgreSQL データベースを実行する環境を作成し (この環境を DB インスタンスと呼びます)、データベースに接続し、DB インスタンスを削除します。
[チュートリアルの開始方法 ](https://aws.amazon.com/getting-started/hands-on/create-connect-postgresql-db/)
+ **ウェブサーバーと Amazon RDS DB インスタンスを作成する **
PHP を使用する Apache ウェブサーバーのインストールと、MySQL データベースの作成を説明します。ウェブサーバーは、Amazon Linux を使用して Amazon EC2 インスタンスで実行されます。MySQL データベースは MySQL DB インスタンスです。
[チュートリアルを使用する ](https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/TUT_WebAppWithRDS.html)
------
#### [ Amazon DocumentDB ]
+ **Amazon DocumentDB の開始方法**
7 つのステップで Amazon DocumentDB の使用を開始できます。このガイドでは AWS Cloud9 、 を使用して、 から直接 MongoDB シェルを使用してクラスターに接続し、クエリを実行します AWS マネジメントコンソール。
[ガイドを見る](https://docs.aws.amazon.com/documentdb/latest/developerguide/get-started-guide.html)
+ **Amazon DocumentDB を使用したドキュメントデータベースの設定**
このチュートリアルは、MongoDB シェルを使用して環境から Amazon DocumentDB クラスターへの接続を開始し、いくつかのクエリを実行するのに役立ちます。 AWS Cloud9 MongoDB
[チュートリアルの開始方法](https://aws.amazon.com/getting-started/hands-on/getting-started-amazon-documentdb-with-aws-cloud9/)
+ **Amazon DocumentDB を使用するためのベストプラクティス**
Amazon DocumentDB を使用する際のベストプラクティスと、基本的な運用ガイドラインについて説明します。
[ ガイドを見る](https://docs.aws.amazon.com/documentdb/latest/developerguide/best_practices.html)
+ **MongoDB から Amazon DocumentDB への移行 **
既存のセルフマネージド MongoDB データベースを Amazon DocumentDB のフルマネージドデータベースに移行する方法について説明します。
[チュートリアルの開始方法](https://docs.aws.amazon.com/dms/latest/sbs/chap-mongodb2documentdb.html)
+ **MongoDB の互換性の評価 **
Amazon DocumentDB 互換ツールを使用して、アプリケーションのソースコードまたは MongoDB サーバープロファイルログを使用して MongoDB アプリケーションの互換性を評価できます。
[ツールを使用する](https://github.com/awslabs/amazon-documentdb-tools/tree/master/compat-tool)
------
#### [ Amazon DynamoDB ]
+ **Amazon DynamoDB とは **
このガイドでは、このフルマネージド NoSQL データベースサービスを使用して、分散データベースの運用とスケーリング (ハードウェアのプロビジョニング、セットアップと設定、レプリケーション、ソフトウェアパッチ適用、クラスタースケーリングなど) の管理上の負担を軽減する方法について説明します。
[ ガイドを見る](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/Introduction.html)
+ 「**DynamoDB の使用開始**」
このガイドには、DynamoDB テーブルへの接続、作成、管理の方法を示す実践的なチュートリアルが含まれています。
[ ガイドを見る](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/GettingStarted.html)
+ **Amazon DynamoDB と AWS SDKs を使用したプログラミング**
このガイドでは、Amazon DynamoDB と AWS SDKs を使用してプログラムする方法と、エラー処理について説明します。DynamoDB のダウンロード可能バージョン、または DynamoDB ウェブサービスのいずれかでコード例を実行できます。
[ガイドを見る](https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/Programming.html)
------
#### [ Amazon ElastiCache ]
+ **Amazon ElastiCache のドキュメント **
ユーザーガイド、特定の AWS CLI および API リファレンスなど、Amazon ElastiCache ドキュメントの全セットをご覧ください。
[ガイドを見る](https://docs.aws.amazon.com/elasticache/index.html)
+ **Amazon ElastiCache の開始方法 **
Amazon ElastiCache コンソールを使用して Valkey (クラスターモードが無効) クラスターを作成、アクセス許可を付与、接続、削除する方法について説明します。
[ガイドを見る](https://docs.aws.amazon.com/AmazonElastiCache/latest/dg/GettingStarted.html)
------
#### [ Amazon MemoryDB ]
+ **Amazon MemoryDB の開始方法**
MemoryDB コンソールを使用して MemoryDB クラスターを作成、アクセス許可を付与、接続、削除する手順について説明します。
[ガイドを使用する](https://docs.aws.amazon.com/memorydb/latest/devguide/getting-started.html)
+ **Amazon MemoryDB for Valkey の使用を開始する**
MemoryDB for Valkey の概要、その利点、MemoryDB for Redis OSS データベースを MemoryDB for Valkey データベースにアップグレードする方法について説明します。
[ブログを読む](https://aws.amazon.com/blogs/database/get-started-with-amazon-memorydb-for-valkey/)
+ **Amazon MemoryDB と Java ベースの統合 AWS Lambda**
データストアの一般的なユースケースの一部である Amazon MemoryDB について説明します。Amazon MemoryDB は、耐久性と読み取りと書き込みの高速化を実現するように設計されています。
[ブログを読む](https://aws.amazon.com/blogs/compute/integrating-amazon-memorydb-for-redis-with-java-based-aws-lambda/)
------
#### [ Amazon Keyspaces ]
+ **Amazon Keyspaces の開始方法 (Apache Cassandra 用)**
このガイドは、Apache Cassandra と Amazon Keyspaces (Apache Cassandra 用) を初めて使用する場合を対象としています。Amazon Keyspaces を正常に使用するために必要なすべてのプログラムとドライバーをインストールする手順を説明します。
[ガイドを見る](https://docs.aws.amazon.com/keyspaces/latest/devguide/getting-started.html)
+ **Amazon Keyspaces の使用に関する初心者コース (Apache Cassandra 向け)**
Amazon Keyspaces の利点、一般的なユースケース、技術的な概念について説明します。提供されているサンプルコードまたは のインタラクティブツールを使用してサービスを試すことができます AWS マネジメントコンソール。
[コースを受講する (サインインが必要)](https://skillbuilder.aws/learn/KHGZNGWXKV/getting-started-with-amazon-keyspaces/MXK17GET8G)
+ **変更データキャプチャ (CDC) ストリームの使用**
イベント駆動型アーキテクチャ、分析、AI アプリケーション向けに、Amazon Keyspaces テーブルにリアルタイムのデータ変更をキャプチャします。
[CDC ストリームを調べる](https://docs.aws.amazon.com/keyspaces/latest/devguide/cdc.html)
------
#### [ Amazon Neptune ]
+ **Amazon Neptune の開始方法**
フルマネージド型のグラフデータベースサービスである Amazon Neptune の使用を開始するのに役立ちます。このガイドでは、Neptune データベースを作成する方法について説明します。
[ガイドを見る](https://docs.aws.amazon.com/neptune/latest/userguide/graph-get-started.html)
+ **ナレッジグラフを使用して Amazon Bedrock と Amazon Neptune で GraphRAG アプリケーションを構築する**
[LlamaIndex](https://www.llamaindex.ai/) フレームワークで Amazon Bedrock と Amazon Neptune を使用して GraphRAG アプリケーションを構築します。
[ブログを読む](https://aws.amazon.com/blogs/database/using-knowledge-graphs-to-build-graphrag-applications-with-amazon-bedrock-and-amazon-neptune/)
+ **Amazon Neptune を使用してリアルタイムの不正検出ソリューションを構築する**
ここでは、企業が Amazon Neptune ML とリアルタイム帰納的推論機能を使用して、不正取引のリアルタイムアラートを取得する方法を示します。これにより、不正損失を減らし、収益を増やすことができます。
[ブログを読む](https://aws.amazon.com/blogs/database/build-a-real-time-fraud-detection-solution-using-amazon-neptune-ml/)
------
#### [ Amazon Timestream ]
+ **Amazon Timestream の開始方法 **
Amazon Timestream の使用を開始するのに役立ちます。このガイドでは、完全に機能するサンプルアプリケーションを設定する手順について説明します。
[ガイドを見る](https://docs.aws.amazon.com/timestream/latest/developerguide/getting-started.html)
+ **Amazon Timestream のベストプラクティス **
データモデリング、セキュリティ、設定、データ取り込み、クエリ、クライアントアプリケーション、サポートされている統合に関連するプラクティスなど、ベストプラクティスについて説明します。
[ガイドを見る](https://docs.aws.amazon.com/timestream/latest/developerguide/best-practices.html)
+ ** AWS SDKs を使用した Amazon Timestream へのアクセス**
Java、Go、Python、Node.js、.NET のいずれかの言語で AWS SDKs を使用して Amazon Timestream にアクセスする方法について説明します。
[ガイドを見る](https://docs.aws.amazon.com/timestream/latest/developerguide/getting-started-sdks.html)
+ **時系列データとそれが重要な理由を理解する **
時系列データの性質、さまざまなタイプの業界における存在、および有効にするさまざまなユースケースについて説明します。
[ブログを読む](https://aws.amazon.com/blogs/database/understanding-time-series-data-and-why-it-matters/)
+ **Amazon Timestream for InfluxDB 3**
InfluxDB 3 に基づくマネージド時系列データベースサービス。時系列ワークロードのパフォーマンスと機能を強化します。
[ガイドを見る](https://docs.aws.amazon.com/timestream/latest/developerguide/influxdb3.html)
------
## Explore
| | |
| --- |--- |
| **ロール**
開発者
[ソリューションアーキテクト](https://aws.amazon.com/architecture/databases/?cards-all.sort-by=item.additionalFields.sortDate&cards-all.sort-order=desc&awsf.content-type=*all&awsf.methodology=*all)
[プロフェッショナル開発](https://explore.skillbuilder.aws/learn/course/external/view/elearning/13585/introduction-to-building-with-aws-databases)
[スタートアップ](https://aws.amazon.com/startups/start-building/how-to-choose-a-database/)
[意思決定者](https://aws.amazon.com/free/database/) | **移行戦略**
[AWS Database Migration Serviceの開始方法](https://docs.aws.amazon.com/dms/latest/userguide/CHAP_GettingStarted.html)
[AWS Schema Conversion Toolの使用](https://aws.amazon.com/dms/schema-conversion-tool/)
[AWS Well-Architected フレームワーク](https://docs.aws.amazon.com/wellarchitected/latest/framework/welcome.html)
[ワークロードに適したデータベースとデータベース移行プランの選択](https://aws.amazon.com/blogs/architecture/selecting-the-right-database-and-database-migration-plan-for-your-workloads/) |
+ **アーキテクチャ図**
データベースの開発、スケーリング、テストに役立つリファレンスアーキテクチャ図をご覧ください AWS。
[アーキテクチャ図を調べる ](https://aws.amazon.com/architecture/?cards-all.sort-by=item.additionalFields.sortDate&cards-all.sort-order=desc&awsf.content-type=content-type%23reference-arch-diagram&awsf.methodology=*all&awsf.tech-category=tech-category%23databases&awsf.industries=*all&awsf.business-category=*all&awsm.page-cards-all=1)
+ **ホワイトペーパー**
開始方法、ベストプラクティス、データベースの移行に役立つホワイトペーパーをご覧ください。
[ホワイトペーパーの詳細 ](https://aws.amazon.com/whitepapers/?whitepapers-main.sort-by=item.additionalFields.sortDate&whitepapers-main.sort-order=desc&awsf.whitepapers-content-type=*all&awsf.whitepapers-global-methodology=*all&awsf.whitepapers-tech-category=tech-category%23databases&awsf.whitepapers-industries=*all&awsf.whitepapers-business-category=*all&awsm.page-whitepapers-main=1)
+ **AWS ソリューション**
データベースの一般的なユースケースについて、厳選されたソリューションとアーキテクチャガイダンスをご覧ください。
[ソリューションの詳細 ](https://aws.amazon.com/solutions/databases/)