Le traduzioni sono generate tramite traduzione automatica. In caso di conflitto tra il contenuto di una traduzione e la versione originale in Inglese, quest'ultima prevarrà.
Tabelle di streaming e distribuzione S3 per Amazon Kinesis Data Streams
Con Amazon Kinesis Data Streams, puoi distribuire dati in streaming dai tuoi flussi di dati Kinesis a due tipi di destinazione: tabelle di streaming su Apache Iceberg (Amazon S3 Tables) o bucket Amazon S3 generici. Non è necessario gestire alcuna infrastruttura e puoi iniziare a distribuire in pochi minuti. Amazon Kinesis Data Streams legge dal flusso, memorizza e aggrega i record e li consegna alla destinazione configurata. La consegna è completamente gestita: non ci sono connettori, applicazioni di consumo o risorse di calcolo da fornire.
Queste funzionalità sono supportate per gli stream eseguiti in modalità On-Demand Advantage o On-Demand Standard capacity. Puoi configurare la consegna dal tuo stream e specificare una destinazione. Amazon Kinesis Data Streams gestisce quindi automaticamente il ridimensionamento, i tentativi e l'affidabilità della distribuzione. La distribuzione non consuma il throughput di lettura dello stream e non ha alcun impatto sui consumatori esistenti.
Argomenti
Come funziona la distribuzione dei dati
La distribuzione dei dati collega il flusso di dati Kinesis a una destinazione di consegna tramite una pipeline gestita:
I dati vengono pubblicati su un flusso di dati Kinesis in modalità. On-Demand
Si chiama
CreateChannello stream e si specifica una destinazione (tabelle di streaming su Apache Iceberg o un bucket Amazon S3 generico).La distribuzione legge dallo stream, memorizza i record nel buffer e li aggrega in file di dimensioni ottimali.
La consegna scrive i file nella destinazione configurata all'interno della finestra di aggiornamento dei dati specificata.
Destinazioni di consegna
La consegna dei dati supporta due tipi di destinazione:
- Tabelle di streaming su Apache Iceberg
-
Lo streaming delle tabelle trasferisce continuamente il flusso di dati Kinesis nelle tabelle Apache Iceberg archiviate in Amazon S3 Tables. Man mano che i dati arrivano, vengono convertiti automaticamente in un formato Apache Parquet ottimizzato con una compattazione intelligente in linea che elimina il problema dei file di piccole dimensioni e riduce i costi delle query a valle. Entro pochi minuti dalla pubblicazione nel tuo stream, i dati diventano interrogabili tramite Amazon Athena, Amazon EMR, Amazon Managed Service for Apache Flink o qualsiasi motore che supporti Apache Iceberg.
- Bucket Amazon S3 per uso generico
-
Amazon S3 Delivery scrive i dati in streaming dal flusso di dati Kinesis direttamente in un bucket S3. I record vengono consegnati nel loro formato sorgente originale senza alcuna trasformazione applicata. Più record vengono memorizzati nel buffer e raggruppati in oggetti di dimensioni ottimali, con compressione configurabile e una struttura di chiave S3 definita tramite il modello di chiave di output. È ideale per casi d'uso come l'archiviazione dei log non elaborati, la riproduzione di eventi e l'elaborazione batch a valle, in cui è necessario uno storage duraturo e a basso costo dei dati di streaming senza il sovraccarico della gestione di una pipeline di distribuzione.
Flusso di dati
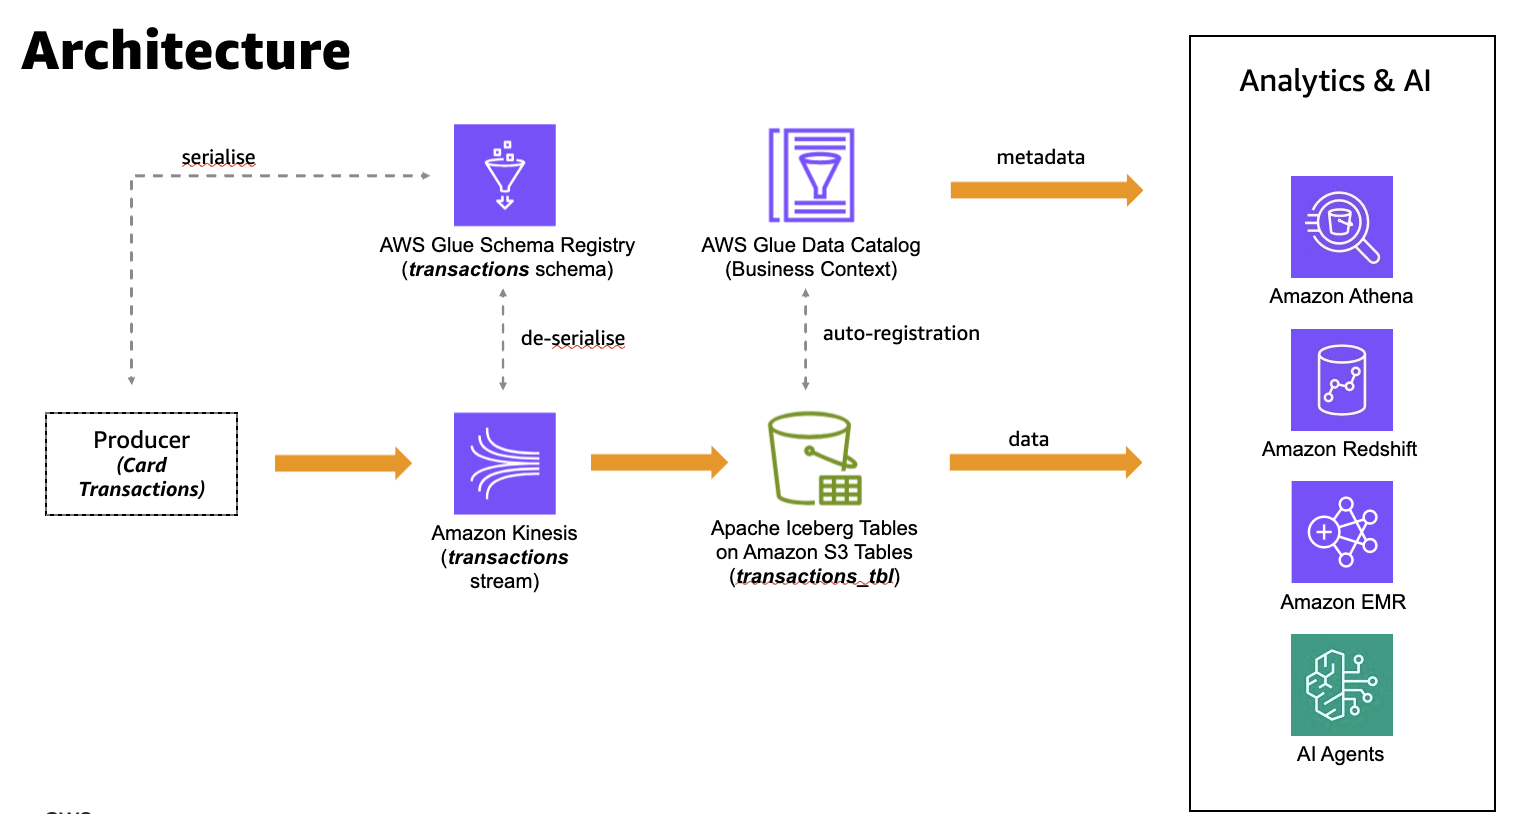
Il diagramma seguente mostra un flusso di dati end-to-end per la distribuzione alle tabelle di streaming su Apache Iceberg. Il diagramma utilizza un caso d'uso relativo alle transazioni con carta come esempio. Un produttore serializza i record in base a uno AWS Glue schema in Schema Registry e li scrive in un flusso di dati Kinesis. Amazon Kinesis Data Streams invia i record alle tabelle Apache Iceberg su Amazon S3 Tables. Se abiliti l'integrazione delle analisi in S3 Tables, i metadati delle tabelle vengono registrati anche nel AWS Glue Data Catalog; ciò non avviene per impostazione predefinita. I dati forniti e i relativi metadati sono quindi disponibili per motori di analisi e intelligenza artificiale come Amazon Athena, Amazon Redshift e Amazon EMR.
La distribuzione a bucket Amazon S3 per uso generico segue un flusso simile, con due differenze. Un produttore scrive i record in un flusso di dati Kinesis e Amazon Kinesis Data Streams li invia al bucket S3. I record vengono consegnati nel formato sorgente originale senza alcuna conversione, quindi AWS Glue lo Schema Registry non è richiesto e nessun metadato di tabella è registrato nel Data Catalog. AWS Glue Amazon Kinesis Data Streams memorizza in buffer e batch i record in oggetti di dimensioni ottimali e li scrive utilizzando la struttura di chiave S3 definita tramite il modello di chiave di output. Gli oggetti consegnati sono quindi disponibili per l'elaborazione e l'analisi in batch a valle.
Funzionalità chiave
Scalabilità automatica senza server: si adatta automaticamente al throughput dello stream, fino alla capacità di throughput dello stream. Nessuna risorsa di calcolo da fornire.
Exactly-once consegna per frammento: i record di un frammento vengono consegnati alla destinazione esattamente una volta, senza duplicati o omissioni all'interno dello shard.
Consegna quasi in tempo reale: aggiornamento dei dati configurabile da 5 a 15 minuti (da 300 a 900 secondi).
Conversione automatica del parquet: per le tabelle di streaming su Apache Iceberg, converte i record di streaming in formato Apache Parquet ottimizzato per query di analisi efficienti.
Compattazione in linea: aggrega i record in file di dimensioni ottimali per le prestazioni delle query di analisi.
Crittografia: supporta le AWS KMS chiavi gestite dal cliente per la crittografia lato server a destinazione. Il Chiave gestita da AWS (l'
aws/kinesisalias) non è supportato per la crittografia della destinazione.Dead-letter queue: i metadati di errore per i record che non possono essere recapitati, tra cui l'ARN dello stream, l'ID dello shard, il numero di sequenza e il contesto dell'errore, vengono scritti in una coda di lettere morte. S3-based
CloudWatch metriche e log: monitora i byte consegnati, il conteggio dei record e l'aggiornamento dei dati tramite le metriche di Amazon. CloudWatch Abilita la registrazione delle consegne su Amazon CloudWatch Logs per acquisire i dettagli del batch di consegna, gli errori e il contesto degli errori per la risoluzione dei problemi.
Nessun impatto sugli altri consumatori: non utilizza slot fan-out avanzati o throughput condiviso.
Requisiti
Il flusso di dati Kinesis deve utilizzare la modalità di capacità On-Demand Standard o On-Demand Advantage.
È necessario creare un ruolo di esecuzione del servizio IAM che conceda le autorizzazioni di consegna per scrivere a destinazione.
Il bucket di destinazione o il bucket di tabella deve trovarsi nella stessa regione del flusso di dati Kinesis. La distribuzione dei dati non supporta la consegna in più regioni per nessuno dei due tipi di destinazione.
Per le tabelle di streaming su Apache Iceberg, la distribuzione tra account non è supportata. Lo stream di origine, il bucket di tabelle S3 di destinazione e AWS Glue lo Schema Registry devono trovarsi tutti nella stessa Account AWS regione.
Per i bucket Amazon S3 per uso generico, la consegna tra account è supportata solo per il bucket di destinazione. Il canale e il relativo stream di origine devono essere nello stesso Account AWS; solo il bucket di destinazione può trovarsi in un account diverso.
Per le tabelle di streaming su Apache Iceberg, devi configurare una coda di lettere morte in Amazon S3.
