Le traduzioni sono generate tramite traduzione automatica. In caso di conflitto tra il contenuto di una traduzione e la versione originale in Inglese, quest'ultima prevarrà.
Ottimizzazione dei costi - Rete
La progettazione di sistemi per l'alta disponibilità (HA) è una best practice per ottenere resilienza e tolleranza ai guasti. In pratica, ciò significa distribuire i carichi di lavoro e l'infrastruttura sottostante su più zone di disponibilità (AZ) in una determinata regione AWS. Garantire che queste caratteristiche siano presenti per il tuo ambiente Amazon EKS migliorerà l'affidabilità complessiva del tuo sistema. Inoltre, i tuoi ambienti EKS saranno probabilmente composti anche da una varietà di costrutti (ad esempio VPC), componenti (ad esempio ELB) e integrazioni (ad esempio ECR e altri registri di container).
La combinazione di sistemi ad alta disponibilità e altri componenti specifici per i casi d'uso può svolgere un ruolo significativo nel modo in cui i dati vengono trasferiti ed elaborati. Ciò avrà a sua volta un impatto sui costi sostenuti per il trasferimento e l'elaborazione dei dati.
Le pratiche descritte di seguito vi aiuteranno a progettare e ottimizzare i vostri ambienti EKS al fine di ottenere un rapporto costo-efficacia per diversi domini e casi d'uso.
Comunicazione da Pod a Pod
A seconda della configurazione, la comunicazione di rete e il trasferimento di dati tra pod possono avere un impatto significativo sul costo complessivo di esecuzione dei carichi di lavoro Amazon EKS. Questa sezione tratterà diversi concetti e approcci per mitigare i costi legati alla comunicazione tra pod, considerando al contempo le architetture ad alta disponibilità (HA), le prestazioni delle applicazioni e la resilienza.
Limitazione del traffico verso una zona di disponibilità
Il progetto Kubernetes ha iniziato sin dall'inizio a sviluppare costrutti compatibili con la topologia, tra cui etichette come kubernetes. io/hostname, topology.kubernetes. io/regione topology.kubernetes. io/zone assegnato ai nodi per abilitare funzionalità come la distribuzione del carico di lavoro tra domini di errore e provider di volume con riconoscimento della topologia. Dopo la laurea in Kubernetes 1.17, le etichette sono state utilizzate anche per abilitare funzionalità di routing basate sulla topologia per la comunicazione da Pod a Pod.
Di seguito sono riportate alcune strategie su come controllare la quantità di traffico cross-AZ tra i Pod del cluster EKS per ridurre i costi e minimizzare la latenza.
Se desideri una visibilità granulare della quantità di traffico Cross-AZ tra i Pod del tuo cluster (ad esempio la quantità di dati trasferiti in byte), fai riferimento a questo post. https://aws.amazon.com/blogs/containers/getting-visibility-into-your-amazon-eks-cross-az-pod-to-pod-network-bytes/
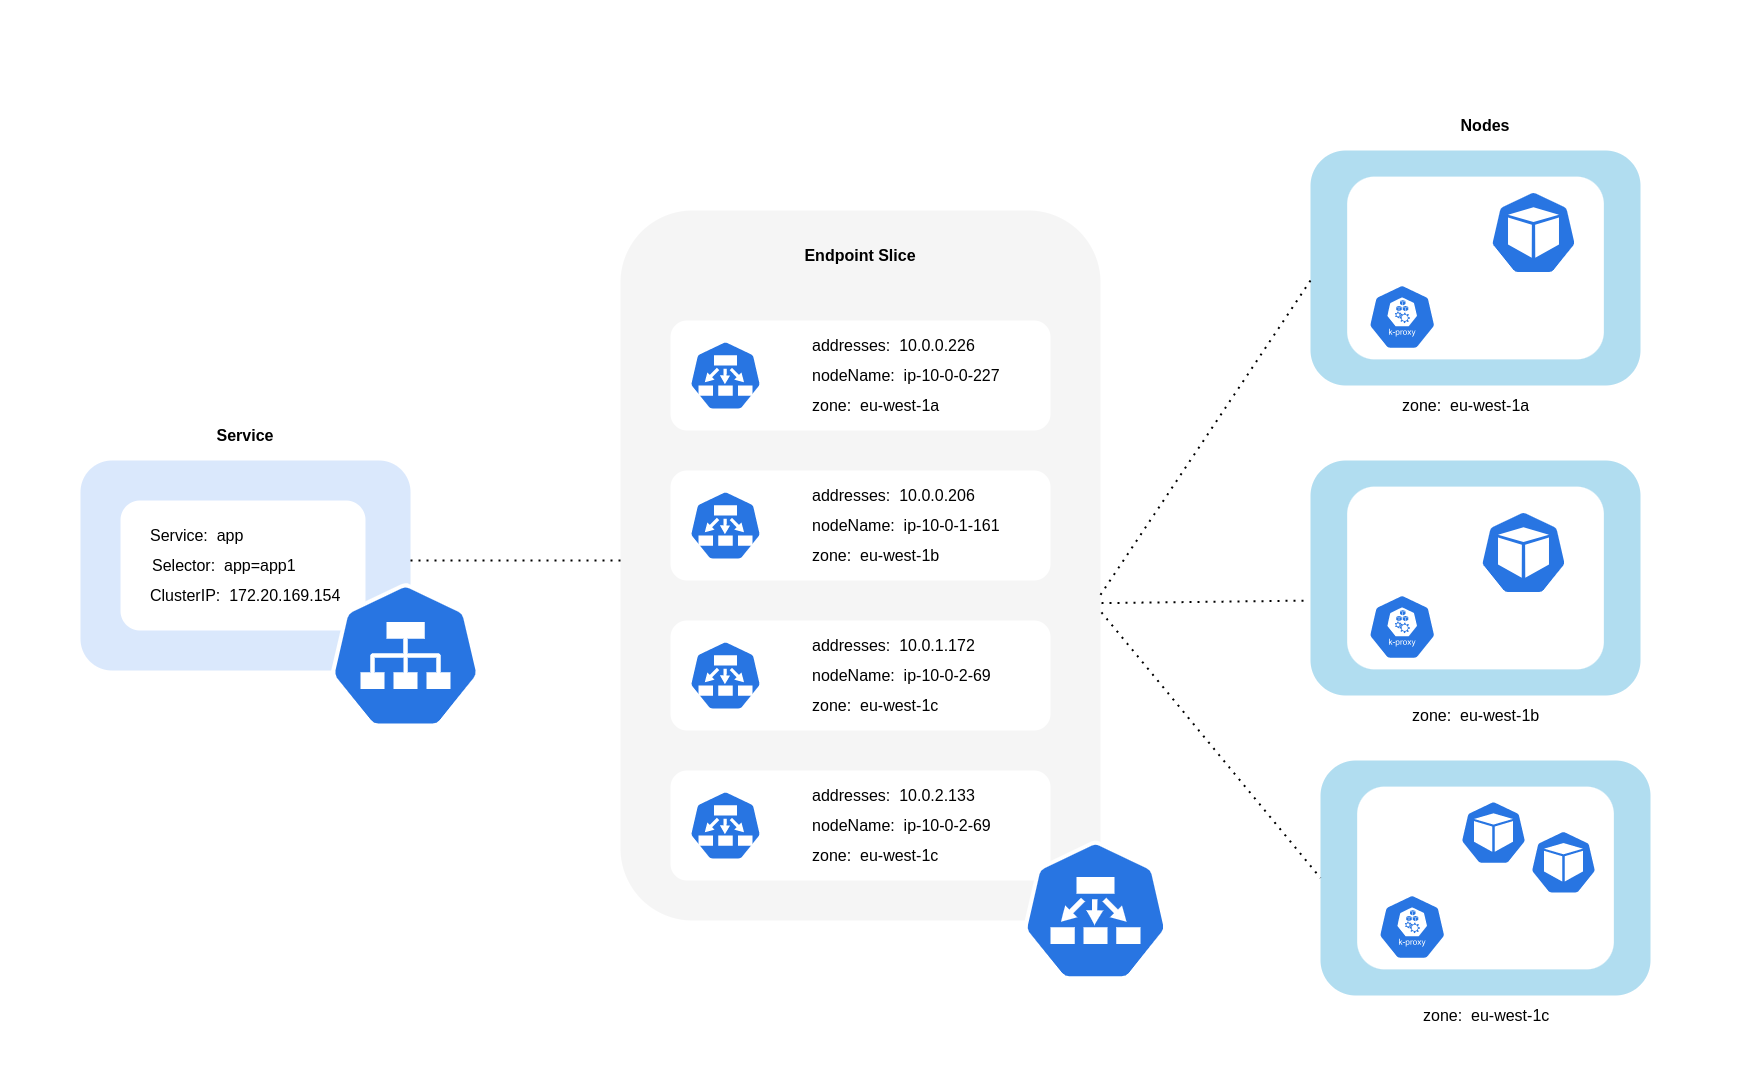
Come mostra il diagramma precedente, i servizi sono il livello di astrazione della rete stabile che riceve il traffico destinato ai tuoi Pod. Quando viene creato un servizio, ne vengono creati diversi. EndpointSlices Ciascuno EndpointSlice ha un elenco di endpoint contenente un sottoinsieme di indirizzi Pod insieme ai nodi su cui sono in esecuzione e qualsiasi informazione topologica aggiuntiva. Quando si utilizza Amazon VPC CNI, kube-proxy viene eseguito come daemonset su ogni nodo. Mantiene le regole di rete per consentire la comunicazione Pod e il rilevamento dei servizi. Alternative e BPF-based CNI potrebbero non utilizzare kube-proxy ma fornire un comportamento equivalente. Svolge il ruolo di routing interno, ma lo fa in base a ciò che consuma dal creato. EndpointSlices
Su Amazon EKS, kube-proxy utilizza principalmente le regole NAT di iptables (o nftables, IPVS
Utilizzo del Topology Aware Routing (precedentemente noto come Topology Aware Hints)
Quando il routing basato sulla topologia kube-proxyindirizzeranno quindi il traffico da una zona a un endpoint in base ai suggerimenti che vengono applicati.
Il diagramma seguente mostra come EndpointSlices i suggerimenti siano organizzati in modo tale da kube-proxy poter sapere a quale destinazione devono andare in base al punto di origine zonale. Senza suggerimenti, non esiste tale allocazione o organizzazione e il traffico verrà indirizzato tramite proxy verso diverse destinazioni zonali indipendentemente dalla provenienza.

In alcuni casi, il EndpointSlice controller può applicare un suggerimento per una zona diversa, il che significa che l'endpoint potrebbe finire per servire il traffico proveniente da una zona diversa. Il motivo è cercare di mantenere una distribuzione uniforme del traffico tra endpoint in zone diverse.
Di seguito è riportato un frammento di codice su come abilitare il routing basato sulla topologia per un servizio.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
  annotations:
    service.kubernetes.io/topology-mode: Auto
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
La schermata seguente mostra il risultato dell'applicazione corretta da parte del EndpointSlice controller di un suggerimento a un endpoint per una replica Pod in esecuzione nell'AZ. eu-west-1a

Nota
È importante notare che il routing basato sulla topologia è ancora in versione beta. Questa funzionalità offre prestazioni più prevedibili con carichi di lavoro distribuiti uniformemente su tutta la topologia del cluster, poiché il controller alloca gli endpoint in modo proporzionale tra le zone ma può saltare l'assegnazione dei suggerimenti quando le risorse dei nodi in una zona sono troppo squilibrate per evitare un sovraccarico eccessivo. Pertanto, si consiglia vivamente di utilizzarla insieme ai vincoli di pianificazione che aumentano la disponibilità di un'applicazione, come i vincoli di diffusione della topologia dei pod. https://kubernetes.io/docs/concepts/scheduling-eviction/topology-spread-constraints/
Utilizzo della distribuzione del traffico
Introdotta in Kubernetes 1.30 e resa disponibile a livello generale nella versione 1.33, Traffic Distribution
Di seguito è riportato un frammento di codice su come abilitare la distribuzione del traffico per un servizio.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  trafficDistribution: PreferClose
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
Quando si abilita la distribuzione del traffico, emerge una sfida comune: gli endpoint all'interno di una singola AZ possono sovraccaricarsi se la maggior parte del traffico proviene dalla stessa zona. Questo sovraccarico può creare problemi significativi:
-
Un singolo Horizontal Pod Autoscaler (HPA) che gestisce un'implementazione Multi-AZ può rispondere ridimensionando i pod su diversi AZ. Tuttavia, questa azione non riesce ad affrontare efficacemente l'aumento del carico nella zona interessata.
-
Questa situazione a sua volta può portare a un'inefficienza delle risorse. Quando gli autoscaler del cluster come Karpenter rilevano la scalabilità orizzontale del pod tra diversi AZ, possono fornire nodi aggiuntivi negli AZ non interessati, con conseguente allocazione di risorse non necessaria.
Per superare questa sfida:
-
Crea implementazioni separate per zona con i propri HPA scalabili indipendentemente l'uno dall'altro.
-
Sfrutta i vincoli di diffusione della topologia per garantire la distribuzione del carico di lavoro nel cluster, il che aiuta a prevenire il sovraccarico degli endpoint nelle zone ad alto traffico.
Utilizzo di Autoscaler: assegna i nodi a una AZ specifica
Consigliamo vivamente di eseguire i carichi di lavoro in ambienti ad alta disponibilità su più AZ. Ciò migliora l'affidabilità delle applicazioni, soprattutto quando si verifica un problema con un AZ. Se siete disposti a sacrificare l'affidabilità per ridurre i costi legati alla rete, potete limitare i nodi a una singola AZ.
Per eseguire tutti i Pod nella stessa AZ, esegui il provisioning dei nodi di lavoro nella stessa AZ o pianifica i Pod sui nodi di lavoro in esecuzione sulla stessa AZ. Per eseguire il provisioning dei nodi all'interno di una singola AZ, definisci un gruppo di nodi con sottoreti appartenenti alla stessa AZ con Cluster Autoscaler (CA). topology.kubernetes.io/zone e specifica l'AZ in cui desideri creare i nodi di lavoro. Ad esempio, lo snippet di provisioner di Karpenter riportato di seguito fornisce i nodi nell'AZ us-west-2a.
Karpenter
apiVersion: karpenter.sh/v1
kind: Provisioner
metadata:
name: single-az
spec:
  requirements:

* key: "topology.kubernetes.io/zone"`
operator: In
values: ["us-west-2a"]
Cluster Autoscaler (CA)
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-ca-cluster
  region: us-east-1
  version: "1.21"
availabilityZones:

* us-east-1a
managedNodeGroups:
* name: managed-nodes
labels:
  role: managed-nodes
instanceType: t3.medium
minSize: 1
maxSize: 10
desiredCapacity: 1
...
Utilizzo di Pod Assignment e Node Affinity
In alternativa, se hai nodi di lavoro in esecuzione in più AZ, ogni nodo avrebbe l'etichetta topology.kubernetes. io/zonenodeSelector o programmare i Pod sui nodeAffinity nodi di un singolo AZ. Ad esempio, il seguente file manifest pianificherà il Pod all'interno di un nodo in esecuzione in AZ us-west-2a.
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    env: test
spec:
  nodeSelector:
    topology.kubernetes.io/zone: us-west-2a
  containers:

* name: nginx
image: nginx
imagePullPolicy: IfNotPresent
Limitazione del traffico verso un nodo
Ci sono casi in cui limitare il traffico a livello zonale non è sufficiente. Oltre a ridurre i costi, potrebbe essere necessario ridurre la latenza di rete tra determinate applicazioni con frequenti intercomunicazioni. Per ottenere prestazioni di rete ottimali e ridurre i costi, è necessario un modo per limitare il traffico verso un nodo specifico. Ad esempio, il microservizio A dovrebbe sempre comunicare con il microservizio B sul nodo 1, anche in configurazioni ad alta disponibilità (HA). Il fatto che il microservizio A sul nodo 1 comunichi con il microservizio B sul nodo 2 può avere un impatto negativo sulle prestazioni desiderate per applicazioni di questo tipo, specialmente se il nodo 2 si trova completamente in una AZ separata.
Utilizzo della politica interna sul traffico del servizio
Per limitare il traffico di rete Pod a un nodo, puoi utilizzare la politica sul traffico interno del Servizio Local, il traffico sarà limitato agli endpoint sul nodo da cui proviene il traffico. Questa politica impone l'uso esclusivo degli endpoint locali del nodo. Di conseguenza, i costi relativi al traffico di rete per quel carico di lavoro saranno inferiori rispetto a quelli derivanti dalla distribuzione a livello di cluster. Inoltre, la latenza sarà inferiore, rendendo l'applicazione più performante.
Nota
È importante notare che questa funzionalità non può essere combinata con il routing basato sulla topologia in Kubernetes.

Di seguito è riportato un frammento di codice su come impostare la politica di traffico interno per un servizio.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
  internalTrafficPolicy: Local
Per evitare comportamenti imprevisti dell'applicazione dovuti a cali di traffico, è necessario prendere in considerazione i seguenti approcci:
-
Esegui un numero sufficiente di repliche per ciascuno dei Pod comunicanti
-
Disponi di una distribuzione relativamente uniforme dei Pod utilizzando i vincoli di diffusione della topologia https://kubernetes.io/docs/concepts/scheduling-eviction/topology-spread-constraints/
-
Utilizza le regole di affinità dei pod per la co-locazione dei Pod comunicanti
In questo esempio, hai 2 repliche di Microservice A e 3 repliche di Microservice B. Se Microservice A ha le sue repliche distribuite tra i Nodi 1 e 2 e il Microservice B ha tutte e 3 le sue repliche sul Nodo 3, allora non saranno in grado di comunicare a causa della politica interna sul traffico. Local Quando non sono disponibili endpoint locali del nodo, il traffico viene interrotto.

Se Microservice B ha 2 delle sue 3 repliche sui nodi 1 e 2, allora ci sarà comunicazione tra le applicazioni peer. Ma avresti comunque una replica isolata di Microservice B senza alcuna replica peer con cui comunicare.

Nota
In alcuni scenari, una replica isolata come quella illustrata nel diagramma precedente potrebbe non essere motivo di preoccupazione se serve comunque a uno scopo (ad esempio soddisfare le richieste provenienti dal traffico esterno in entrata).
Utilizzo della politica sul traffico interno del servizio con vincoli di diffusione della topologia
L'utilizzo della politica di traffico interna insieme ai vincoli di diffusione della topologia può essere utile per garantire il numero giusto di repliche per la comunicazione di microservizi su nodi diversi.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: express-test
spec:
  replicas: 6
  selector:
    matchLabels:
      app: express-test
  template:
    metadata:
      labels:
        app: express-test
        tier: backend
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: "topology.kubernetes.io/zone"
        whenUnsatisfiable: ScheduleAnyway
        labelSelector:
          matchLabels:
            app: express-test
Utilizzo della politica di traffico interna del servizio con Pod Affinity Rules
Un altro approccio consiste nell'utilizzare le regole di affinità Pod quando si utilizza la politica sul traffico interno del Servizio. Con Pod affinity, puoi influenzare lo scheduler affinché co-localizzi determinati Pod a causa delle loro frequenti comunicazioni. Applicando rigidi vincoli di pianificazione (requiredDuringSchedulingIgnoredDuringExecution) su determinati Pod, otterrai risultati migliori per la co-locazione dei Pod quando lo Scheduler posiziona i Pod sui nodi.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: graphql
  namespace: ecommerce
  labels:
    app.kubernetes.io/version: "0.1.6"
    ...
    spec:
      serviceAccountName: graphql-service-account
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
Comunicazione tra Load Balancer e Pod
I carichi di lavoro EKS sono in genere gestiti da un load balancer che distribuisce il traffico ai Pod pertinenti nel cluster EKS. La tua architettura può comprendere sistemi di bilanciamento del carico interni ed esterni. and/or A seconda dell'architettura e delle configurazioni del traffico di rete, la comunicazione tra load balancer e Pods può contribuire in modo significativo ai costi di trasferimento dei dati.
Puoi utilizzare AWS Load Balancer Controller
Quando si utilizza la modalità istanza, NodePort verrà aperto un nodo su ogni nodo del cluster EKS. Il load balancer eseguirà quindi il proxy del traffico in modo uniforme tra i nodi. Se su un nodo è installato il Pod di destinazione, non saranno sostenuti costi di trasferimento dei dati. Tuttavia, se il Pod di destinazione si trova su un nodo separato e in un AZ diverso da quello che NodePort riceve il traffico, ci sarà un ulteriore salto di rete dal kube-proxy al Pod di destinazione. In tale scenario, saranno applicati costi di trasferimento dati tra le due AZ. A causa della distribuzione uniforme del traffico tra i nodi, è molto probabile che ci siano costi aggiuntivi per il trasferimento dei dati associati ai salti di traffico di rete interzona dai proxy kube ai Pod di destinazione pertinenti.
Il diagramma seguente illustra un percorso di rete per il traffico che fluisce dal load balancer al Pod di destinazione e successivamente dal Pod di NodePort destinazione su un nodo separato in un kube-proxy AZ diverso. Questo è un esempio dell'impostazione della modalità di istanza.

Quando si utilizza la modalità ip, il traffico di rete viene inviato tramite proxy dal load balancer direttamente al Pod di destinazione. Di conseguenza, questo approccio non prevede costi per il trasferimento dei dati.
Nota
Si consiglia di impostare il load balancer in modalità traffico IP per ridurre i costi di trasferimento dei dati. Per questa configurazione, è anche importante assicurarsi che il load balancer sia distribuito su tutte le sottoreti del VPC.
Il diagramma seguente illustra i percorsi di rete per il traffico che fluisce dal load balancer ai Pods in modalità IP di rete.

Trasferimento dati da Container Registry
Amazon ECR
Il trasferimento dei dati nel registro privato Amazon ECR è gratuito. In-region il trasferimento dei dati non comporta alcun costo, ma il trasferimento dei dati verso Internet e tra aree geografiche verrà addebitato alle tariffe di trasferimento dati Internet su entrambi i lati del trasferimento.
È necessario utilizzare la funzionalità di replica delle immagini integrata di eCRS per replicare le immagini dei contenitori pertinenti nella stessa regione dei carichi di lavoro. In questo modo la replica verrebbe addebitata una sola volta e tutte le estrazioni di immagini nella stessa regione (intraregionale) sarebbero gratuite.
È possibile ridurre ulteriormente i costi di trasferimento dei dati associati all'estrazione di immagini da ECR (trasferimento dati in uscita) utilizzando Interface VPC Endpoints per connettersi ai repository ECR locali. L'approccio alternativo di connessione all'endpoint AWS pubblico di ECR (tramite un NAT Gateway e un Internet Gateway) comporterà costi di elaborazione e trasferimento dei dati più elevati. La sezione successiva tratterà in modo più dettagliato la riduzione dei costi di trasferimento dei dati tra i carichi di lavoro e i servizi AWS.
Se esegui carichi di lavoro con immagini particolarmente grandi, puoi creare le tue Amazon Machine Images (AMI) personalizzate con immagini di container prememorizzate nella cache. Ciò può ridurre il tempo iniziale di estrazione dell'immagine e i potenziali costi di trasferimento dei dati da un registro di container ai nodi di lavoro EKS.
Trasferimento di dati su Internet: servizi & AWS
È pratica comune integrare i carichi di lavoro Kubernetes con altri servizi AWS o strumenti e piattaforme di terze parti tramite Internet. L'infrastruttura di rete sottostante utilizzata per indirizzare il traffico da e verso la destinazione pertinente può influire sui costi sostenuti nel processo di trasferimento dei dati.
Utilizzo dei gateway NAT
I gateway NAT sono componenti di rete che eseguono la traduzione degli indirizzi di rete (NAT). Il diagramma seguente mostra i pod in un cluster EKS che comunicano con altri servizi AWS (Amazon ECR, DynamoDB e S3) e piattaforme di terze parti. In questo esempio, i Pod vengono eseguiti in sottoreti private in AZ separati. Per inviare e ricevere traffico da Internet, un gateway NAT viene distribuito nella sottorete pubblica di un AZ, consentendo a qualsiasi risorsa con indirizzi IP privati di condividere un unico indirizzo IP pubblico per accedere a Internet. Questo NAT Gateway a sua volta comunica con il componente Internet Gateway, consentendo l'invio dei pacchetti alla destinazione finale.
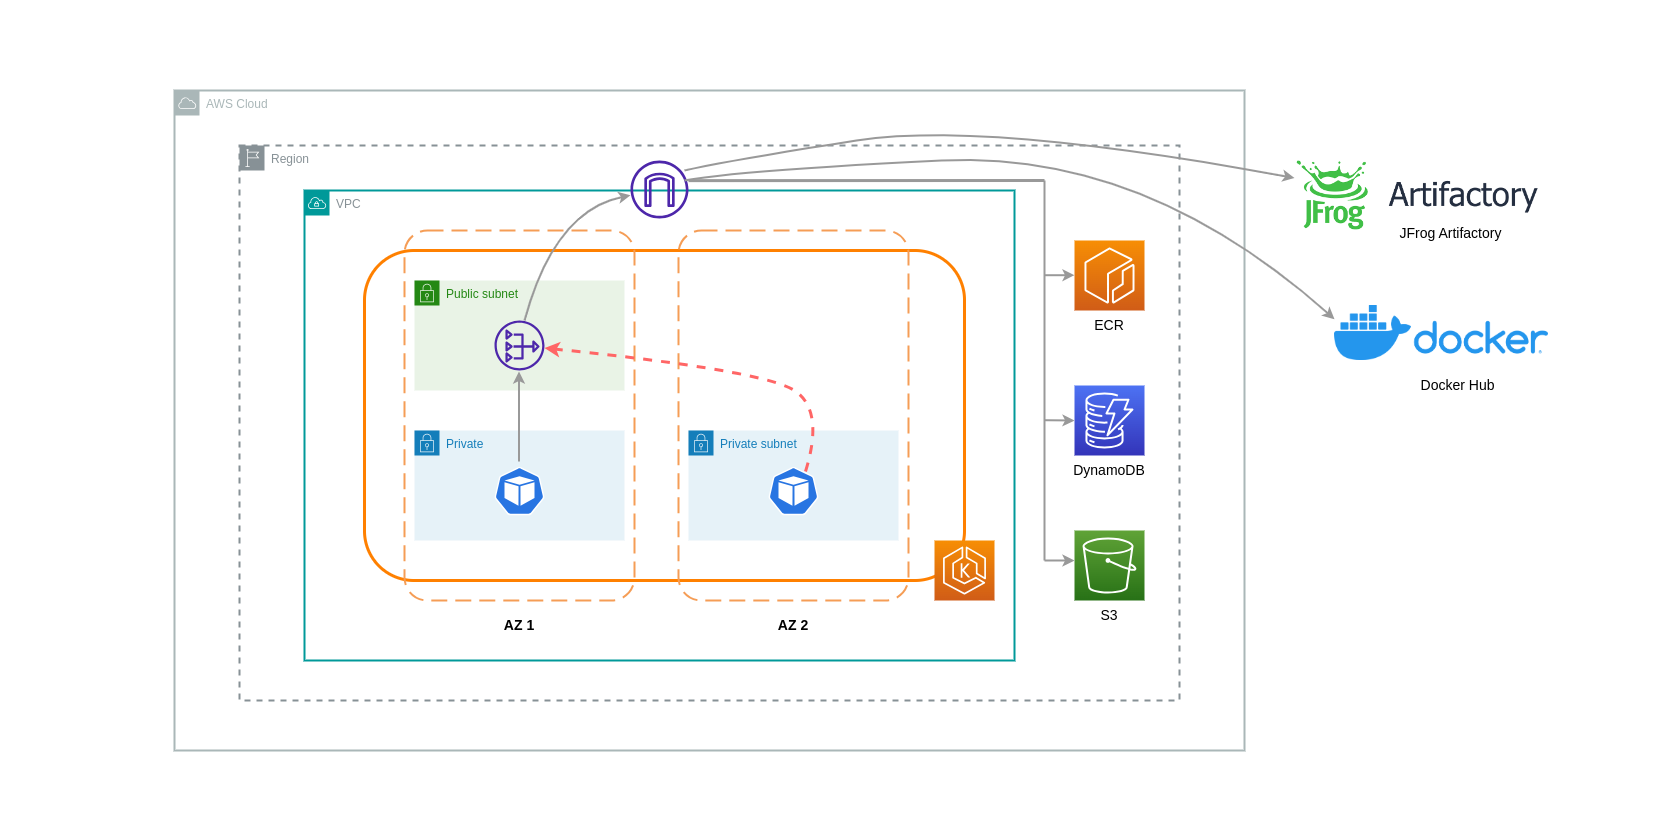
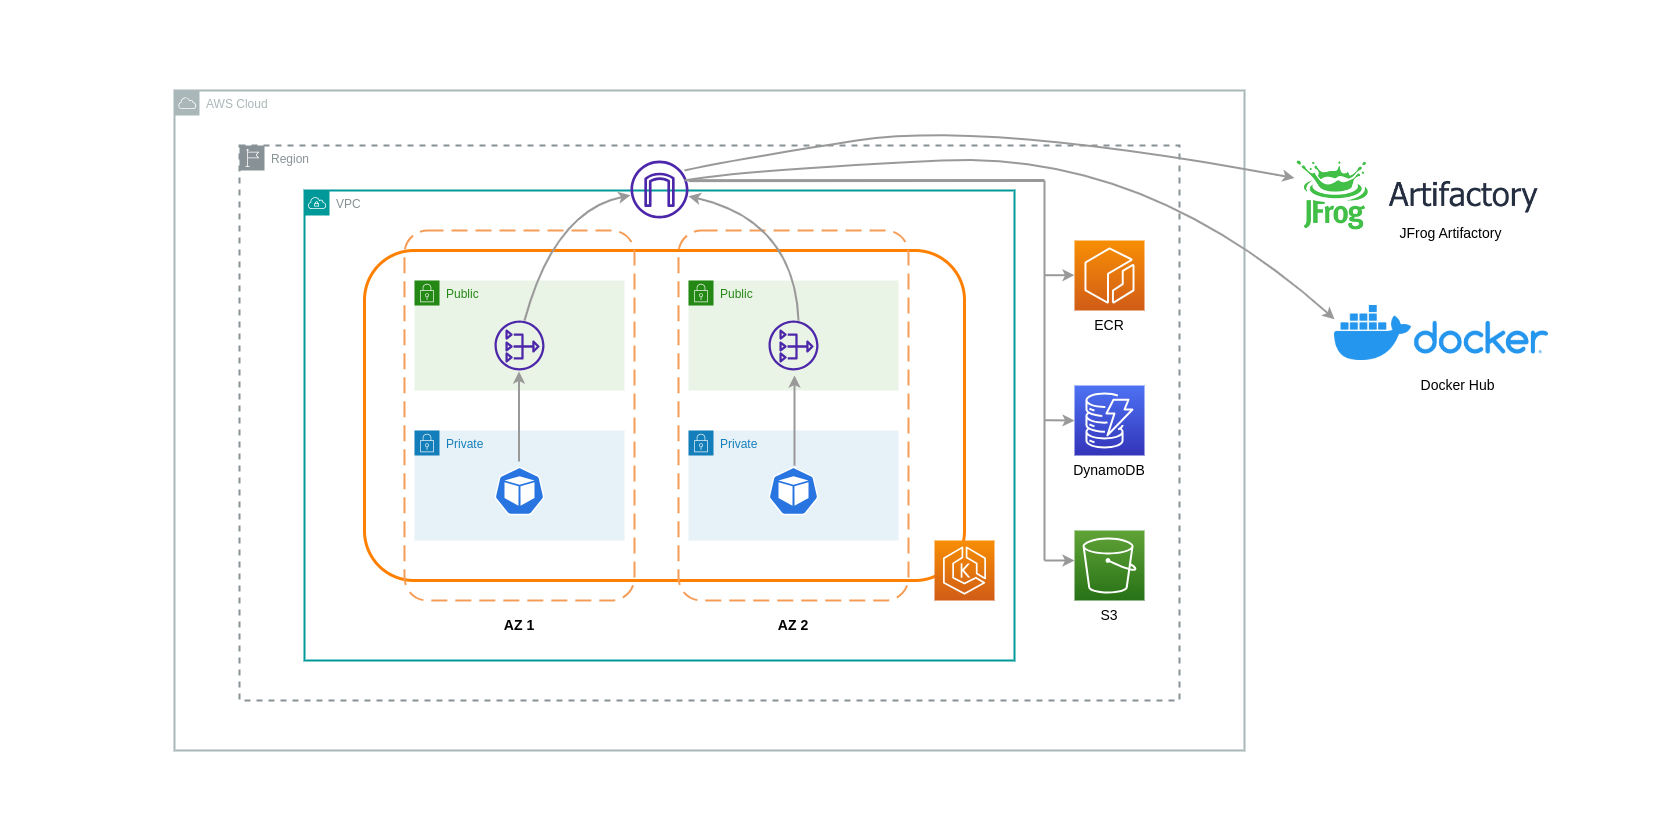
Quando si utilizzano i gateway NAT per questi casi d'uso, è possibile ridurre al minimo i costi di trasferimento dei dati implementando un gateway NAT in ogni AZ. In questo modo, il traffico indirizzato a Internet passerà attraverso il NAT Gateway nella stessa AZ, evitando il trasferimento di dati tra le AZ. Tuttavia, anche se risparmierai sul costo del trasferimento dei dati Inter-AZ, questa configurazione implica che dovrai sostenere il costo di un gateway NAT aggiuntivo nella tua architettura.
Questo approccio consigliato è illustrato nel diagramma seguente.
Utilizzo di endpoint VPC
Per ridurre ulteriormente i costi in tali architetture, è necessario utilizzare VPC Endpoints per stabilire la connettività tra i carichi di lavoro e i servizi AWS. Gli endpoint VPC consentono di accedere ai servizi AWS dall'interno di un VPC senza che i pacchetti attraversino Internet. data/network Tutto il traffico è interno e rimane all'interno della rete AWS. Esistono due tipi di endpoint VPC: Interface VPC Endpoint (supportati da molti servizi AWS) e Gateway VPC Endpoint (supportati solo da S3 e DynamoDB).
Endpoint Gateway VPC
Non ci sono costi orari o di trasferimento dati associati agli endpoint Gateway VPC. Quando si utilizzano Gateway VPC Endpoint, è importante notare che non sono estendibili oltre i confini del VPC. Non possono essere utilizzati nel peering VPC, nelle reti VPN o tramite Direct Connect.
Interfaccia: VPC Endpoint
Gli endpoint VPC hanno una tariffa oraria
Il diagramma seguente mostra i Pods che comunicano con i servizi AWS tramite VPC Endpoint.

Trasferimento di dati tra VPC
In alcuni casi, potresti avere carichi di lavoro in VPC distinti (all'interno della stessa regione AWS) che devono comunicare tra loro. Ciò può essere ottenuto consentendo al traffico di attraversare la rete Internet pubblica tramite Internet Gateway collegati ai rispettivi VPC. Tale comunicazione può essere abilitata implementando componenti dell'infrastruttura come istanze EC2, gateway NAT o istanze NAT in sottoreti pubbliche. Tuttavia, una configurazione che include questi componenti comporterà costi per i dati in entrata e in uscita dai VPC. processing/transferring Se il traffico da e verso i VPC separati si sposta tra gli AZ, ci sarà un costo aggiuntivo per il trasferimento dei dati. Il diagramma seguente illustra una configurazione che utilizza NAT Gateway e Internet Gateway per stabilire la comunicazione tra carichi di lavoro in diversi VPC.

Connessioni peering VPC
Per ridurre i costi relativi a questi casi d'uso, puoi utilizzare VPC Peering. Con una connessione VPC Peering, non sono previsti costi di trasferimento dati per il traffico di rete che rimane all'interno dello stesso AZ. Se il traffico attraversa l'AZs, verrà addebitato un costo. Tuttavia, l'approccio VPC Peering è consigliato per una comunicazione conveniente tra carichi di lavoro in VPC separati all'interno della stessa regione AWS. Tuttavia, è importante notare che il peering VPC è efficace principalmente per la connettività VPC 1:1 perché non consente reti transitive.
Lo schema seguente è una rappresentazione di alto livello della comunicazione dei carichi di lavoro tramite una connessione peering VPC.

Connessioni di rete transitive
Come indicato nella sezione precedente, le connessioni VPC Peering non consentono la connettività di rete transitiva. Se desideri connettere 3 o più VPC con requisiti di rete transitiva, dovresti utilizzare un Transit Gateway (TGW). Ciò ti consentirà di superare i limiti del peering VPC o qualsiasi sovraccarico operativo associato all'avere più connessioni di peering VPC tra più VPC. La fatturazione viene effettuata su base oraria
Il diagramma seguente mostra il traffico Inter-AZ che fluisce attraverso un TGW tra carichi di lavoro in diversi VPC ma all'interno della stessa regione AWS.

Utilizzo di una Service Mesh
Le service mesh offrono potenti funzionalità di rete che possono essere utilizzate per ridurre i costi relativi alla rete negli ambienti cluster EKS. Tuttavia, dovresti considerare attentamente le attività operative e la complessità che una service mesh introdurrà nel tuo ambiente se ne adotti una.
Limitazione del traffico alle zone di disponibilità
Utilizzo della distribuzione ponderata per località di Istio
Istio consente di applicare le politiche di rete al traffico dopo che si è verificato il routing. Questo viene fatto utilizzando le regole di destinazione
Nota
Prima di implementare la distribuzione ponderata per località, è necessario iniziare a comprendere i modelli di traffico di rete e le implicazioni che la politica delle regole di destinazione può avere sul comportamento dell'applicazione. Pertanto, è importante disporre di meccanismi di tracciamento distribuiti con strumenti come AWS o Jaeger. X-Ray
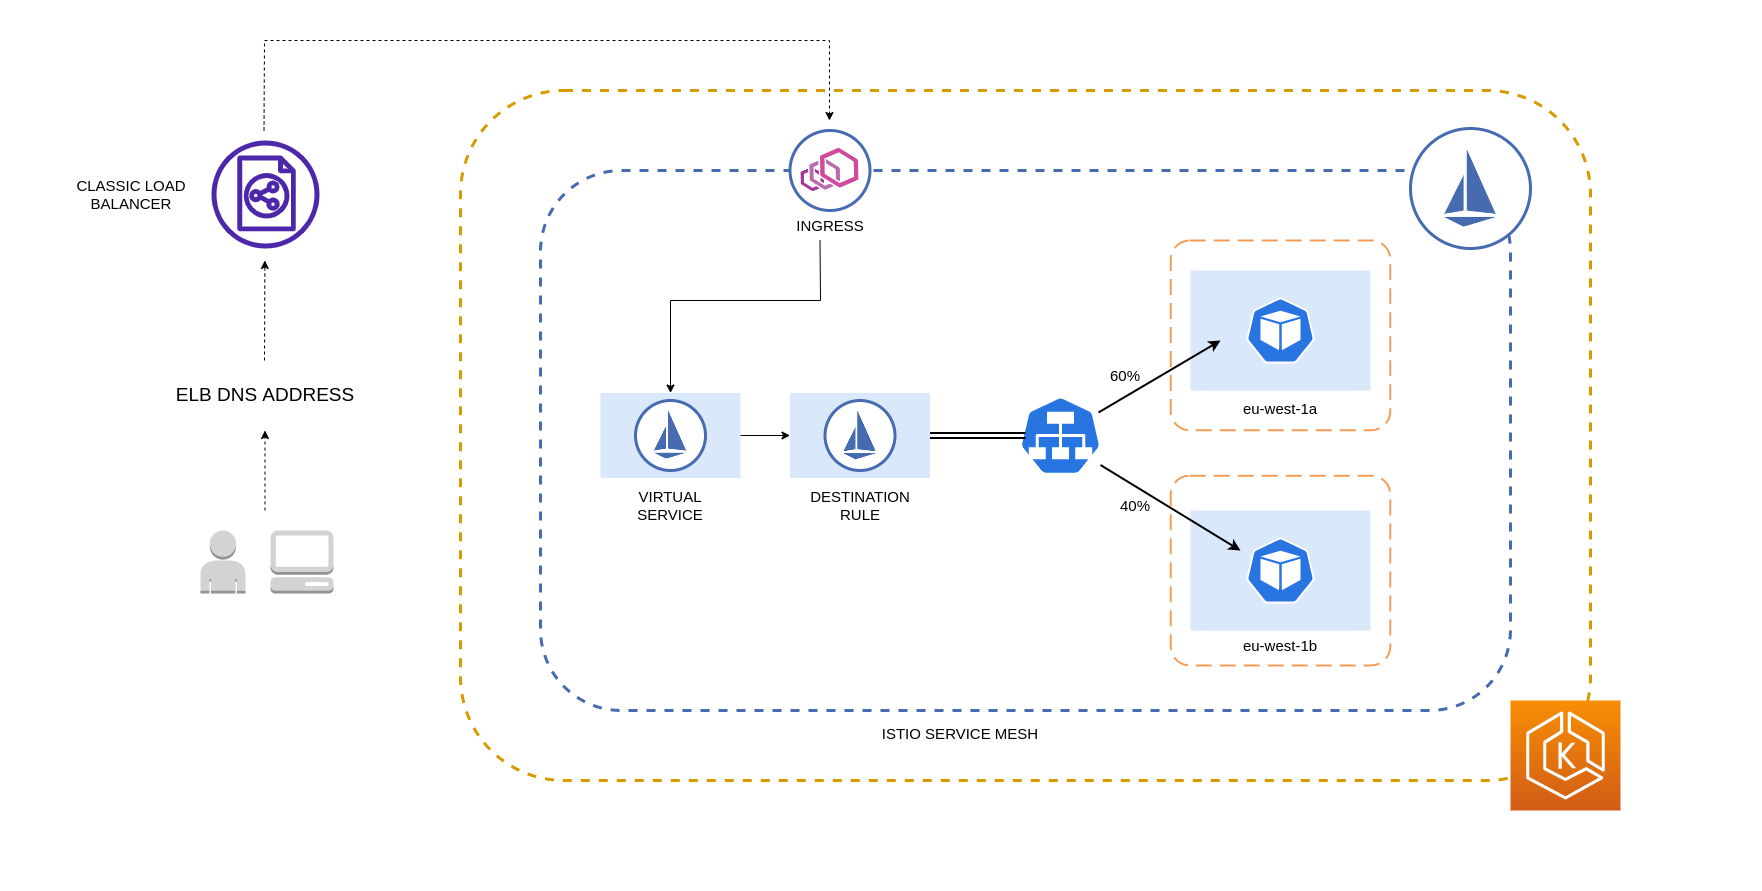
Le regole di destinazione Istio descritte sopra possono essere applicate anche per gestire il traffico da un load balancer ai Pods nel cluster EKS. Le regole di distribuzione ponderate per località possono essere applicate a un servizio che riceve traffico da un sistema di bilanciamento del carico ad alta disponibilità (in particolare Ingress Gateway). Queste regole consentono di controllare la quantità di traffico destinata in base alla sua origine zonale, in questo caso il load balancer. Se configurato correttamente, verrà generato meno traffico interzona in uscita rispetto a un load balancer che distribuisce il traffico in modo uniforme o casuale tra le repliche Pod in diversi AZ.
Di seguito è riportato un esempio di blocco di codice di una risorsa Destination Rule in Istio. Come si può vedere di seguito, questa risorsa specifica configurazioni ponderate per il traffico in entrata da 3 diversi AZ nella regione. eu-west-1 Queste configurazioni dichiarano che la maggior parte del traffico in entrata (il 70% in questo caso) da una determinata AZ deve essere indirizzato tramite proxy a una destinazione nella stessa AZ da cui proviene.
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: express-test-dr
spec:
  host: express-test.default.svc.cluster.local
  trafficPolicy:
    loadBalancer:                      +
      localityLbSetting:
        distribute:
        - from: eu-west-1/eu-west-1a/  +
          to:
            "eu-west-1/eu-west-1a/_": 70
            "eu-west-1/eu-west-1b/_": 20
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1b/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 70
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1c/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 10
            "eu-west-1/eu-west-1c/*": 70**
    connectionPool:
      http:
        http2MaxRequests: 10
        maxRequestsPerConnection: 10
    outlierDetection:
      consecutiveGatewayErrors: 1
      interval: 1m
      baseEjectionTime: 30s
Nota
Il peso minimo che può essere distribuito alla destinazione è dell'1%. Il motivo è mantenere le regioni e le zone di failover nel caso in cui gli endpoint nella destinazione principale diventino non integri o non disponibili.
Il diagramma seguente illustra uno scenario in cui è presente un sistema di bilanciamento del carico ad alta disponibilità nella regione eu-west-1 e viene applicata una distribuzione ponderata per località. La politica delle regole di destinazione per questo diagramma è configurata per inviare il 60% del traffico proveniente da eu-west-1a a Pods nella stessa AZ, mentre il 40% del traffico da eu-west-1a dovrebbe andare a Pods in eu-west-1b.
Limitazione del traffico alle zone e ai nodi di disponibilità
Utilizzo della politica interna sul traffico del servizio con Istio
Per mitigare i costi di rete associati al traffico esterno in entrata e al traffico interno tra i Pod, puoi combinare le regole di destinazione di Istio e la politica sul traffico interno del servizio Kubernetes. Il modo di combinare le regole di destinazione di Istio con la politica del traffico interno del servizio dipenderà in gran parte da 3 fattori:
-
Il ruolo dei microservizi
-
Schemi di traffico di rete tra i microservizi
-
Come devono essere distribuiti i microservizi nella topologia del cluster Kubernetes
Il diagramma seguente mostra come sarebbe il flusso di rete nel caso di una richiesta annidata e come le politiche sopra menzionate controllerebbero il traffico.

-
L'utente finale invia una richiesta all'APP A, che a sua volta invia una richiesta annidata all'APP C. Questa richiesta viene prima inviata a un sistema di bilanciamento del carico ad alta disponibilità, che presenta istanze in AZ 1 e AZ 2, come mostrato nel diagramma precedente.
-
La richiesta esterna in arrivo viene quindi indirizzata alla destinazione corretta dal servizio virtuale Istio.
-
Una volta indirizzata la richiesta, la regola di destinazione Istio controlla la quantità di traffico diretto ai rispettivi AZ in base alla provenienza (AZ 1 o AZ 2).
-
Il traffico viene quindi indirizzato al Servizio per l'APP A e viene quindi inviato tramite proxy ai rispettivi endpoint Pod. Come mostrato nel diagramma, l'80% del traffico in entrata viene inviato agli endpoint Pod in AZ 1 e il 20% del traffico in entrata viene inviato a AZ 2.
-
L'APP A effettua quindi una richiesta interna all'APP C. Il servizio dell'APP C ha una politica di traffico interna abilitata (
internalTrafficPolicy`: Local`). -
La richiesta interna dall'APP A (sul NODO 1) all'APP C ha esito positivo grazie all'endpoint locale del nodo disponibile per l'APP C.
-
La richiesta interna dall'APP A (sul NODO 3) all'APP C ha esito negativo perché non sono disponibili endpoint locali del nodo per l'APP C. Come mostra il diagramma, l'APP C non ha repliche sul NODO 3. * *
Le schermate seguenti sono tratte da un esempio dal vivo di questo approccio. La prima serie di schermate mostra una richiesta esterna andata a buon fine graphql e una richiesta annidata riuscita graphql da una orders replica co-locata sul nodo. ip-10-0-0-151.af-south-1.compute.internal


Con Istio, puoi verificare ed esportare le statistiche di tutti i cluster e gli endpoint orders endpoint di cui il graphql proxy è a conoscenza possono essere ottenuti utilizzando il seguente comando:
kubectl exec -it deploy/graphql -n ecommerce -c istio-proxy -- curl localhost:15000/clusters | grep orders
...
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_error::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_success::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_timeout::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_total::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**health_flags::healthy**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**region::af-south-1**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**zone::af-south-1b**
...
In questo caso, il graphql proxy è a conoscenza solo dell'ordersendpoint della replica con cui condivide un nodo. Se rimuovi l'internalTrafficPolicy: Localimpostazione dal servizio degli ordini ed esegui nuovamente un comando come quello precedente, i risultati restituiranno tutti gli endpoint delle repliche distribuiti tra i diversi nodi. Inoltre, esaminando rq_total i rispettivi endpoint, noterai una quota relativamente uniforme nella distribuzione della rete. Di conseguenza, se gli endpoint sono associati a servizi upstream eseguiti in AZ diversi, questa distribuzione della rete tra le zone comporterà costi più elevati.
Come accennato in una sezione precedente, puoi co-localizzare i Pod che comunicano di frequente facendo uso di pod-affinity.
...
spec:
...
  template:
    metadata:
      labels:
        app: graphql
        role: api
        workload: ecommerce
    spec:
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
      nodeSelector:
        managedBy: karpenter
        billing-team: ecommerce
...
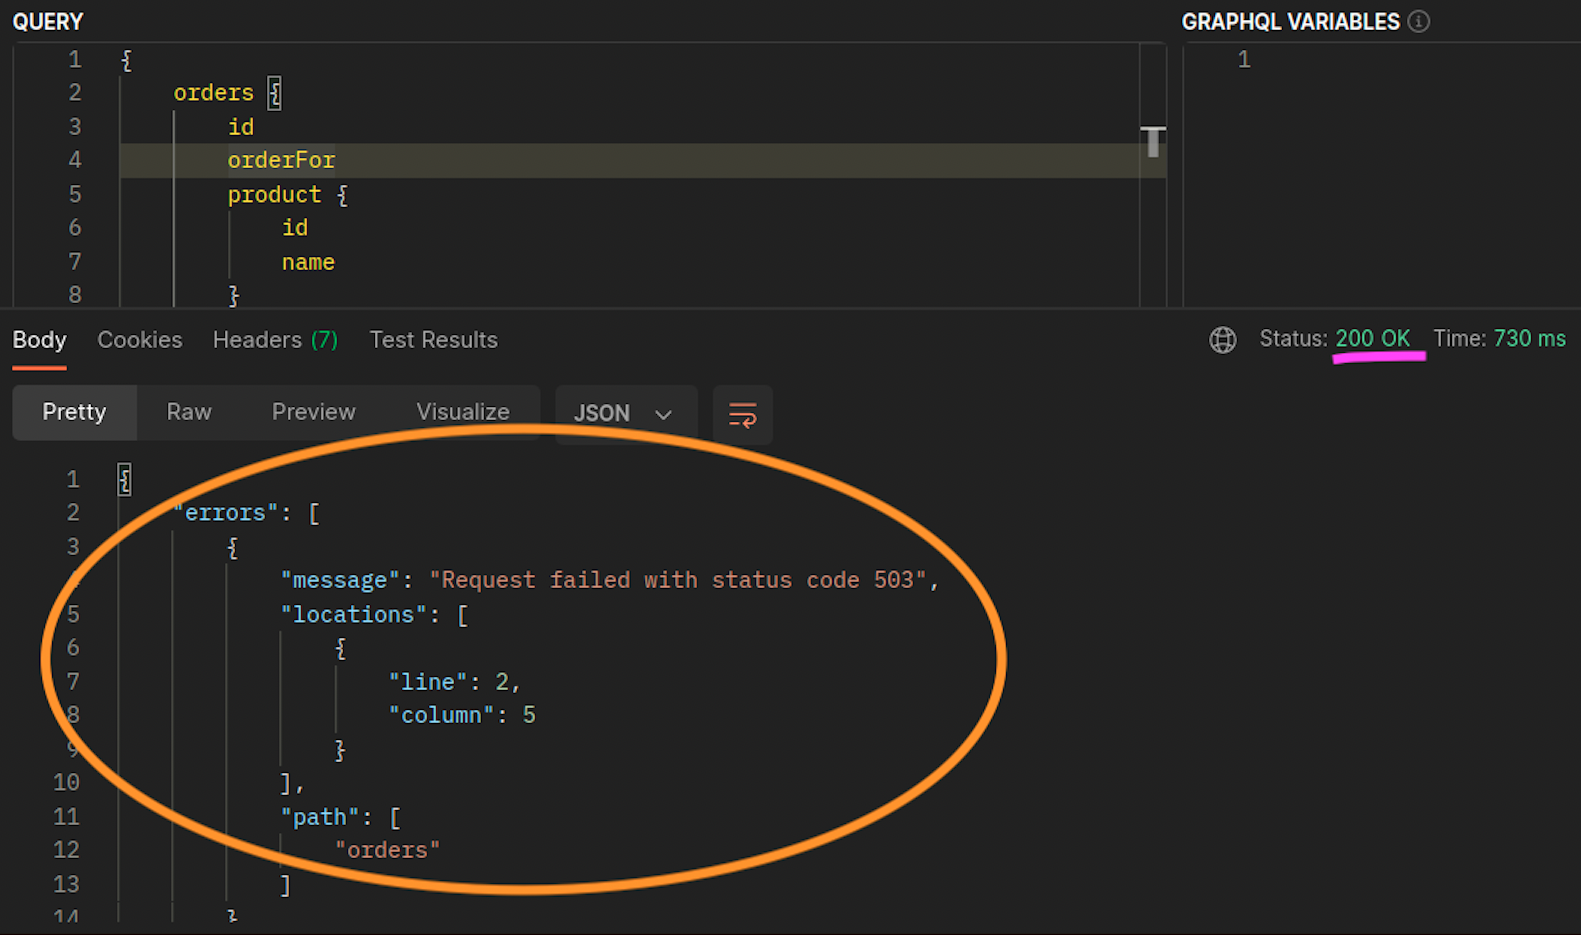
Quando le orders repliche graphql e non coesistono sullo stesso nodo (ip-10-0-0-151.af-south-1.compute.internal), la prima richiesta a graphql ha esito positivo, come indicato nella schermata di Postman qui sotto, mentre la seconda richiesta annidata da 200 response code a ha esito negativo con a. graphql orders 503 response code

Risorse aggiuntive
-
Risolvere i costi di latenza e trasferimento dati su EKS utilizzando Istio
-
Ottenere visibilità sui byte di rete da pod a pod di Amazon EKS Cross-AZ
-
Ottimizza il traffico AZ con il routing basato sulla topologia
-
Ottimizza i costi e le prestazioni di Kubernetes con la politica interna sul traffico del servizio
-
Ottimizza costi e prestazioni di Kubernetes con Istio and Service Internal Traffic Policy
-
Comprendere i costi di trasferimento dei dati per i servizi di container AWS
