Le traduzioni sono generate tramite traduzione automatica. In caso di conflitto tra il contenuto di una traduzione e la versione originale in Inglese, quest'ultima prevarrà.
Scenario: un agente AI dell'assistenza clienti che utilizza AgentCore la memoria
In questa sezione imparerai come creare un agente AI per l'assistenza clienti che utilizzi la AgentCore memoria per fornire assistenza personalizzata conservando la cronologia delle conversazioni ed estraendo informazioni a lungo termine sulle preferenze degli utenti. L'argomento include esempi di codice per la AgentCore CLI e l' AWS SDK.
Prendiamo in considerazione un cliente, Sarah, che contatta l'agente AI dell'assistenza del tuo sito web per gli acquisti per chiedere informazioni su un ordine ritardato. Il flusso di interazione attraverso le API di AgentCore memoria sarebbe simile al seguente:
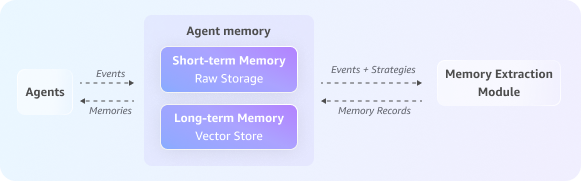
Argomenti
Fase 1: Creare una AgentCore memoria
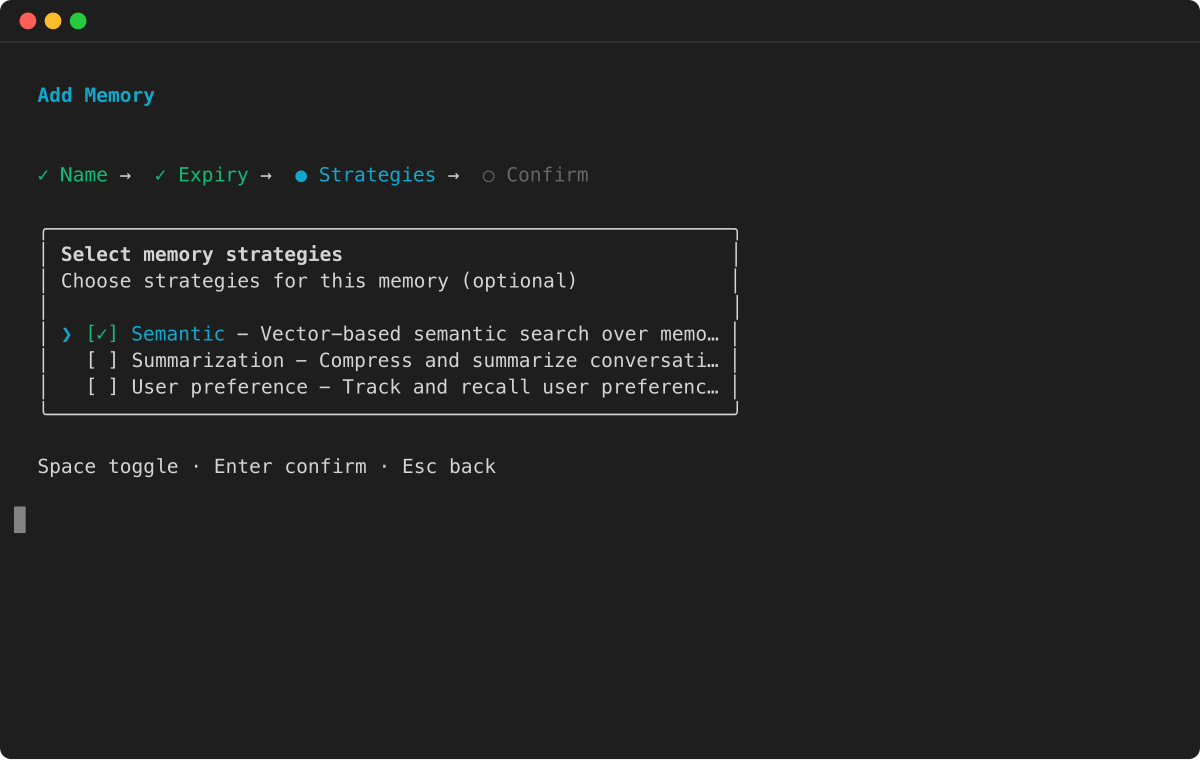
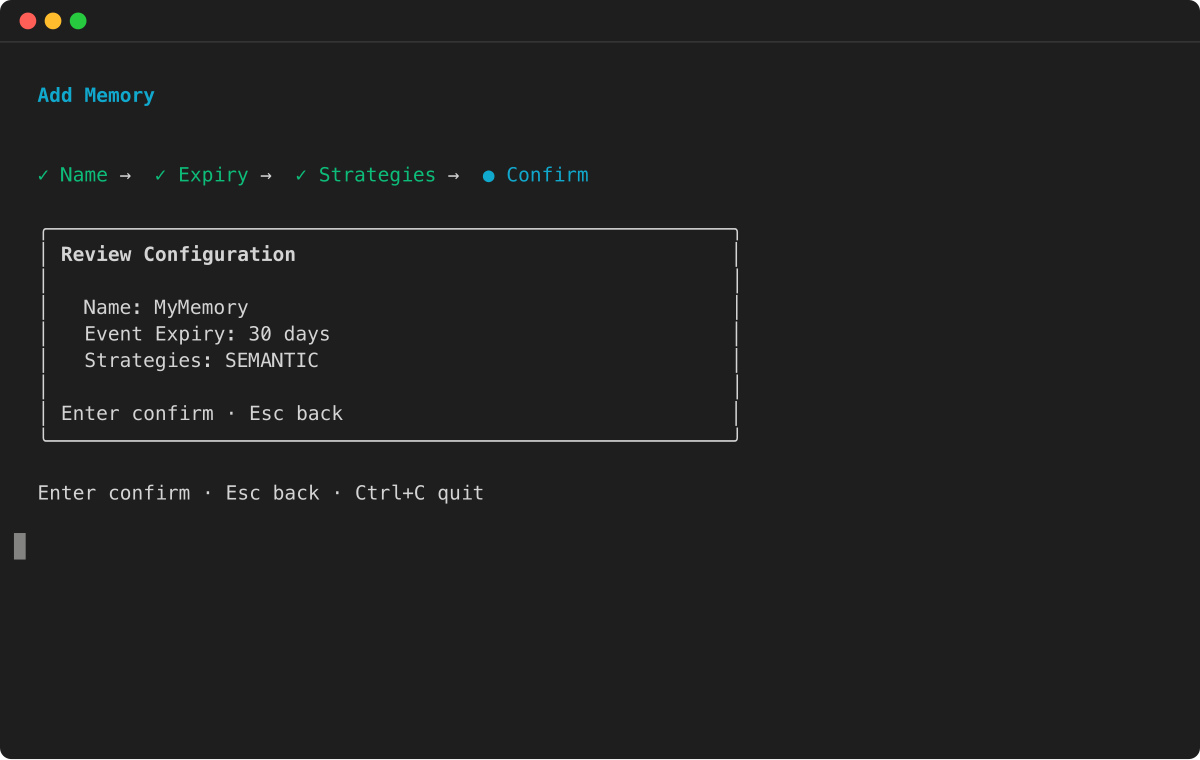
Innanzitutto, si crea una risorsa di memoria con funzionalità di memoria sia a breve che a lungo termine, configurando le strategie per estrarre le informazioni a lungo termine.
Esempio
Fase 2: Avvio della sessione
Quando Sarah avvia la conversazione, l'agente crea un nuovo e univoco ID di sessione per tracciare questa interazione separatamente.
# Unique identifier for the customer, Sarah
sarah_actor_id = "user-sarah-123"

# Unique identifier for this specific support session
support_session_id = "customer-support-session-1"

print(f"Session started for Actor ID: {sarah_actor_id}, Session ID: {support_session_id}")
Fase 3: Acquisisci la cronologia delle conversazioni
Mentre Sarah spiega il problema, l'agente registra ogni turno della conversazione (sia le sue domande che le risposte dell'agente). In questo modo l'intera conversazione viene inserita nella memoria a breve termine e vengono forniti i dati grezzi per l'elaborazione delle strategie di memoria a lungo termine.
print("Capturing conversational events...")

full_conversation_payload = [
    {
        'conversational': {
            'role': 'USER',
            'content': {'text': "Hi, my order #ABC-456 is delayed."}
        }
    },
    {
        'conversational': {
            'role': 'ASSISTANT',
            'content': {'text': "I'm sorry to hear that, Sarah. Let me check the status for you."}
        }
    },
    {
        'conversational': {
            'role': 'USER',
            'content': {'text': "By the way, for future orders, please always use FedEx. I've had issues with other carriers."}
        }
    },
    {
        'conversational': {
            'role': 'ASSISTANT',
            'content': {'text': "Thank you for that information. I have made a note to use FedEx for your future shipments."}
        }
    }
]

data_client.create_event(
    memoryId=memory_id,
    actorId=sarah_actor_id,
    sessionId=support_session_id,
    eventTimestamp=datetime.now(),
    payload=full_conversation_payload
)

print("Conversation history has been captured in short-term memory.")
Fase 4: Generazione di memoria a lungo termine
In background, viene eseguito il processo di estrazione asincrono. Questo processo analizza gli eventi grezzi recenti utilizzando le strategie di memoria configurate per estrarre ricordi a lungo termine come riassunti, fatti semantici o preferenze dell'utente, che vengono poi archiviati per un uso futuro.
Fase 5: Recupera le interazioni passate dalla memoria a breve termine
Per fornire assistenza contestuale, l'agente carica la cronologia delle conversazioni correnti. Questo aiuta l'agente a capire quali problemi Sarah ha sollevato nella chat in corso.
print("\nRetrieving current conversation history from short-term memory...")

response = data_client.list_events(
    memoryId=memory_id,
    actorId=sarah_actor_id,
    sessionId=support_session_id,
    maxResults=10
)

# Reverse the list of events to display them in chronological order
event_list = reversed(response.get('events', []))

for event in event_list: print(event)
Fase 6: Usa le memorie a lungo termine per un'assistenza personalizzata
L'agente esegue una ricerca semantica tra le memorie a lungo termine estratte per trovare informazioni pertinenti sulle preferenze di Sarah, sulla cronologia degli ordini o sulle preoccupazioni passate. Ciò consente all'agente di fornire un'assistenza altamente personalizzata senza dover chiedere a Sarah di ripetere le informazioni che ha già condiviso nelle chat precedenti.
# Wait for the asynchronous extraction to finish
print("\nWaiting 60 seconds for long-term memory processing...")
time.sleep(60)

# --- Example 1: Retrieve the user's shipping preference ---
print("\nRetrieving user preferences from long-term memory...")
preference_response = data_client.retrieve_memory_records(
    memoryId=memory_id,
    namespace=f"/users/{sarah_actor_id}/preferences/",
    searchCriteria={"searchQuery": "Does the user have a preferred shipping carrier?"}
)
for record in preference_response.get('memoryRecordSummaries', []):
    print(f"- Retrieved Record: {record}")

# --- Example 2: Broad query about the user's issue (across sessions with the help of namespacePath) ---
print("\nPerforming a broad search for user's reported issues...")
issue_response = data_client.retrieve_memory_records(
    memoryId=memory_id,
    namespacePath=f"/summaries/{sarah_actor_id}/",
    searchCriteria={"searchQuery": "What problem did the user report with their order?"}
)
for record in issue_response.get('memoryRecordSummaries', []):
    print(f"- Retrieved Record: {record}")
Questo approccio integrato consente all'agente di mantenere un contesto completo durante le sessioni, riconoscere i clienti abituali, richiamare dettagli importanti e offrire esperienze personalizzate senza interruzioni, garantendo un'assistenza clienti più rapida, naturale ed efficace.
