Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
Tabel streaming dan pengiriman S3 untuk Amazon Kinesis Data Streams
Dengan Amazon Kinesis Data Streams, Anda dapat mengirimkan data streaming dari aliran data Kinesis ke dua jenis tujuan: tabel streaming di Apache Iceberg (Tabel Amazon S3), atau bucket Amazon S3 tujuan umum. Anda tidak perlu mengelola infrastruktur apa pun, dan Anda dapat mulai mengirimkan dalam beberapa menit. Amazon Kinesis Data Streams membaca dari rekaman streaming, buffer, dan agregat, dan mengirimkannya ke tujuan yang dikonfigurasi. Pengiriman dikelola sepenuhnya — tidak ada konektor, aplikasi konsumen, atau sumber daya komputasi untuk penyediaan.
Kemampuan ini didukung untuk aliran yang berjalan dalam mode On-Demand Advantage atau Kapasitas On-Demand Standar. Anda mengonfigurasi pengiriman dari aliran Anda dan menentukan tujuan. Amazon Kinesis Data Streams kemudian menangani penskalaan, percobaan ulang, dan keandalan pengiriman secara otomatis. Pengiriman tidak menghabiskan throughput baca streaming Anda dan tidak berdampak pada konsumen yang sudah ada.
Topik
Cara kerja pengiriman data
Pengiriman data menghubungkan aliran data Kinesis Anda ke tujuan pengiriman melalui pipeline terkelola:
Anda mempublikasikan data ke aliran data Kinesis dalam On-Demand mode.
Anda memanggil
CreateChannelstreaming dan menentukan tujuan (tabel streaming di Apache Iceberg, atau bucket Amazon S3 tujuan umum).Pengiriman membaca dari aliran, catatan buffer, dan menggabungkannya ke dalam file berukuran optimal.
Pengiriman menulis file ke tujuan yang dikonfigurasi dalam jendela kesegaran data yang Anda tentukan.
Tujuan pengiriman
Pengiriman data mendukung dua jenis tujuan:
- Tabel streaming di Apache Iceberg
-
Tabel streaming terus mengirimkan aliran data Kinesis Anda ke tabel Apache Iceberg yang disimpan di Tabel Amazon S3. Saat data tiba, secara otomatis dikonversi ke format Apache Parquet yang dioptimalkan dengan pemadatan inline cerdas yang menghilangkan masalah file kecil dan mengurangi biaya kueri hilir. Dalam beberapa menit setelah dipublikasikan ke streaming Anda, data dapat ditanyakan melalui Amazon Athena, Amazon EMR, Amazon Managed Service untuk Apache Flink, atau mesin apa pun yang mendukung Apache Iceberg.
- Bucket Amazon S3 tujuan umum
-
Pengiriman Amazon S3 menulis data streaming dari aliran data Kinesis Anda langsung ke bucket S3. Catatan dikirim dalam format sumber aslinya tanpa transformasi yang diterapkan. Beberapa catatan disangga dan dikelompokkan ke dalam objek berukuran optimal, dengan kompresi yang dapat dikonfigurasi dan struktur kunci S3 yang Anda tentukan melalui template kunci keluaran. Ini sangat ideal untuk kasus penggunaan seperti arsip log mentah, pemutaran ulang acara, dan pemrosesan batch hilir, di mana Anda memerlukan penyimpanan data streaming yang tahan lama dan berbiaya rendah tanpa overhead mengelola saluran pengiriman.
Aliran data
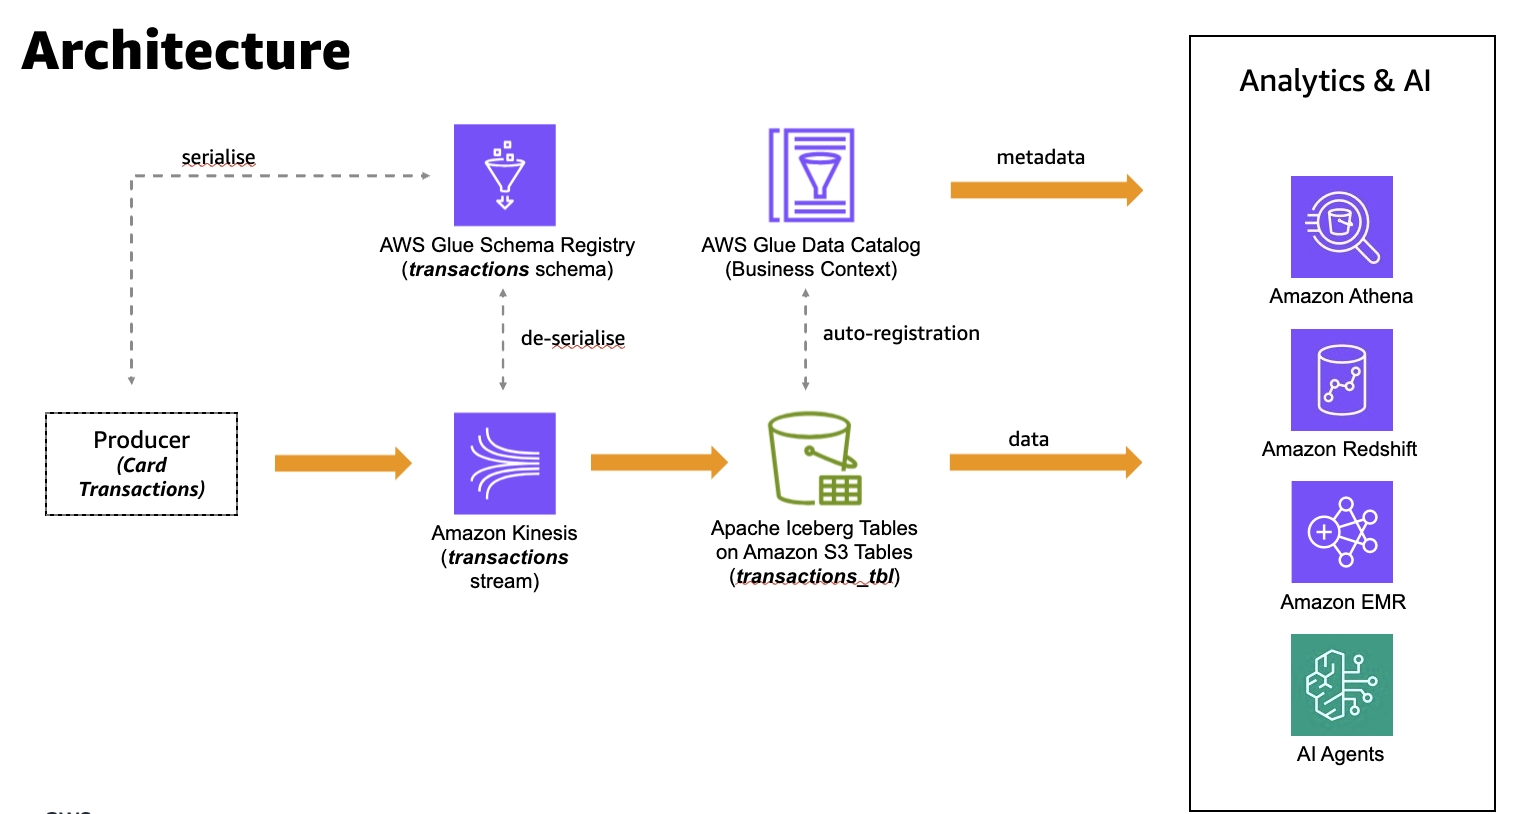
Diagram berikut menunjukkan aliran data end-to-end untuk pengiriman ke tabel streaming di Apache Iceberg. Diagram menggunakan kasus penggunaan transaksi kartu sebagai contoh. Seorang produser membuat serial rekaman terhadap skema di AWS Glue Schema Registry dan menuliskannya ke aliran data Kinesis. Amazon Kinesis Data Streams mengirimkan catatan ke tabel Apache Iceberg di Tabel Amazon S3. Jika Anda mengaktifkan integrasi analitik di Tabel S3, metadata tabel juga terdaftar di Katalog AWS Glue Data; ini tidak terjadi secara default. Data yang dikirimkan dan metadatanya kemudian tersedia untuk analitik dan mesin AI seperti Amazon Athena, Amazon Redshift, dan Amazon EMR.
Pengiriman ke bucket Amazon S3 tujuan umum mengikuti aliran yang sama, dengan dua perbedaan. Produser menulis catatan ke aliran data Kinesis, dan Amazon Kinesis Data Streams mengirimkannya ke bucket S3 Anda. Catatan dikirim dalam format sumber aslinya tanpa konversi, jadi Registri AWS Glue Skema tidak diperlukan dan tidak ada metadata tabel yang terdaftar di Katalog Data. AWS Glue Amazon Kinesis Data Streams buffer dan batch record ke dalam objek berukuran optimal dan menulisnya menggunakan struktur kunci S3 yang Anda tentukan melalui template kunci keluaran. Objek yang dikirim kemudian tersedia untuk pemrosesan batch hilir dan analitik.
Kemampuan kunci
Pengiriman data menyediakan kemampuan kunci berikut:
Auto-scaling tanpa server — Menskalakan secara otomatis dengan throughput streaming Anda, hingga kapasitas throughput streaming. Tidak ada sumber daya komputasi untuk penyediaan.
Exactly-once pengiriman per pecahan — Catatan dari pecahan dikirim ke tujuan tepat sekali, tanpa duplikat atau kelalaian dalam pecahan.
Pengiriman mendekati waktu nyata - Kesegaran data yang dapat dikonfigurasi dari 5 hingga 15 menit (300 hingga 900 detik).
Konversi Parket Otomatis - Untuk tabel streaming di Apache Iceberg, mengubah catatan streaming menjadi format Apache Parquet yang dioptimalkan untuk kueri analitik yang efisien.
Pemadatan sebaris — Menggabungkan catatan ke dalam file berukuran optimal untuk kinerja kueri analitik.
Enkripsi - Mendukung AWS KMS kunci yang dikelola pelanggan untuk enkripsi sisi server di tujuan. Kunci yang dikelola AWS (
aws/kinesisalias) tidak didukung untuk enkripsi tujuan.Dead-letter antrian — Metadata kegagalan untuk catatan yang tidak dapat dikirimkan — termasuk ARN aliran, ID pecahan, nomor urut, dan konteks kesalahan — ditulis ke antrian huruf mati. S3-based
CloudWatch metrik dan log — Pantau byte yang dikirimkan, jumlah catatan, dan kesegaran data melalui metrik Amazon. CloudWatch Aktifkan pencatatan pengiriman ke Amazon CloudWatch Logs untuk menangkap detail batch pengiriman, kegagalan, dan konteks kesalahan untuk pemecahan masalah.
Tidak berdampak pada konsumen lain — Tidak mengkonsumsi slot fan-out yang ditingkatkan atau throughput bersama.
Persyaratan
Pengiriman data memiliki persyaratan sebagai berikut:
Aliran data Kinesis Anda harus menggunakan mode kapasitas On-Demand Standar atau On-Demand Advantage.
Anda harus membuat peran eksekusi layanan IAM yang memberikan izin pengiriman untuk menulis ke tujuan Anda.
Bucket tujuan atau keranjang meja Anda harus berada di Wilayah yang sama dengan aliran data Kinesis Anda. Pengiriman data tidak mendukung pengiriman lintas wilayah untuk kedua jenis tujuan.
Untuk tabel streaming di Apache Iceberg, pengiriman lintas akun tidak didukung. Aliran sumber, bucket tabel S3 tujuan, dan Registri AWS Glue Skema semuanya harus berada di Wilayah yang sama Akun AWS dan sama.
Untuk bucket Amazon S3 tujuan umum, pengiriman lintas akun hanya didukung untuk bucket tujuan. Saluran dan aliran sumbernya harus sama Akun AWS; hanya bucket tujuan yang dapat berada di akun yang berbeda.
Untuk streaming tabel di Apache Iceberg, Anda harus mengonfigurasi antrian huruf mati di Amazon S3.
