Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
Jalankan uji beban khusus
Pengujian beban Amazon SageMaker Inference Recommender melakukan tolok ukur ekstensif berdasarkan persyaratan produksi untuk latensi dan throughput, pola lalu lintas khusus, dan titik akhir tanpa server atau instans real-time (hingga 10) yang Anda pilih.
Bagian berikut menunjukkan cara membuat, menjelaskan, dan menghentikan uji beban secara terprogram menggunakan AWS SDK untuk Python (Boto3) dan AWS CLI, atau secara interaktif menggunakan Amazon SageMaker Studio Classic atau konsol AI. SageMaker
Membuat pekerjaan uji beban
Buat uji beban secara terprogram menggunakan AWS SDK untuk Python (Boto3), dengan AWS CLI, atau secara interaktif menggunakan Studio Classic atau konsol AI. SageMaker Seperti rekomendasi inferensi Inferensi Recommender, tentukan nama pekerjaan untuk uji beban Anda, ARN peran AWS IAM, konfigurasi input, dan paket model ARN Anda sejak Anda mendaftarkan model Anda dengan registri model. Tes beban mengharuskan Anda juga menentukan pola lalu lintas dan kondisi berhenti.
- AWS SDK untuk Python (Boto3)
-
Gunakan
CreateInferenceRecommendationsJobAPI untuk membuat uji beban Inference Recommender. TentukanAdvanceduntukJobTypebidang dan berikan:-
Nama pekerjaan untuk uji beban Anda (
JobName). Nama pekerjaan harus unik di Wil AWS ayah Anda dan di dalam AWS akun Anda. -
Nama Sumber Daya Amazon (ARN) dari peran IAM yang memungkinkan Inferensi Rekomendasi untuk melakukan tugas atas nama Anda. Definisikan ini untuk
RoleArnlapangan. -
Kamus konfigurasi titik akhir (
InputConfig) di mana Anda menentukan yang berikut:-
Untuk
TrafficPattern, tentukan fase atau pola lalu lintas tangga. Dengan pola lalu lintas fase, pengguna baru muncul setiap menit pada tingkat yang Anda tentukan. Dengan pola lalu lintas tangga, pengguna baru muncul pada interval waktu (atau langkah) dengan kecepatan yang Anda tentukan. Pilih salah satu cara berikut:-
Untuk
TrafficType, tentukanPHASES. Kemudian, untukPhasesarray, tentukanInitialNumberOfUsers(berapa banyak pengguna bersamaan untuk memulai, dengan minimal 1 dan maksimum 3),SpawnRate(jumlah pengguna yang akan muncul dalam satu menit untuk fase pengujian beban tertentu, dengan minimal 0 dan maksimum 3), danDurationInSeconds(berapa lama fase lalu lintas harus, dengan minimal 120 dan maksimum 3600). -
Untuk
TrafficType, tentukanSTAIRS. Kemudian, untukStairsarray, tentukanDurationInSeconds(berapa lama fase lalu lintas harus, dengan minimal 120 dan maksimum 3600),NumberOfSteps(berapa banyak interval yang digunakan selama fase), danUsersPerStep(berapa banyak pengguna ditambahkan selama setiap interval). Perhatikan bahwa panjang setiap langkah adalah nilaiDurationInSeconds / NumberOfSteps. Misalnya, jika AndaDurationInSecondsadalah600dan Anda menentukan5langkah-langkah, maka setiap langkah panjangnya 120 detik.catatan
Pengguna didefinisikan sebagai aktor yang dihasilkan sistem yang berjalan dalam loop dan memanggil permintaan ke titik akhir sebagai bagian dari Inference Recommender. Untuk wadah XGBoost khas yang berjalan pada
ml.c5.largeinstance, titik akhir dapat mencapai 30.000 pemanggilan per menit (500 tps) hanya dengan 15-20 pengguna.
-
-
Untuk
ResourceLimit, tentukanMaxNumberOfTests(jumlah maksimum uji beban benchmarking untuk pekerjaan Inferensi Recommender, dengan minimal 1 dan maksimum 10) danMaxParallelOfTests(jumlah maksimum uji beban benchmarking paralel untuk pekerjaan Rekomendasi Inferensi, dengan minimal 1 dan maksimum 10). -
Untuk
EndpointConfigurations, Anda dapat menentukan salah satu dari berikut ini:-
InstanceTypeBidang, tempat Anda menentukan jenis instance tempat Anda ingin menjalankan tes beban. -
The
ServerlessConfig, di mana Anda menentukan nilai ideal Anda untukMaxConcurrencydanMemorySizeInMBuntuk titik akhir tanpa server. Untuk informasi selengkapnya, lihat dokumentasi Serverless Inference.
-
-
-
Kamus kondisi penghentian (
StoppingConditions), di mana jika salah satu kondisi terpenuhi, pekerjaan Inferensi Recommender berhenti. Untuk contoh ini, tentukan bidang berikut dalam kamus:-
Untuk
MaxInvocations, tentukan jumlah maksimum permintaan per menit yang diharapkan untuk titik akhir, dengan minimal 1 dan maksimum 30.000. -
Untuk
ModelLatencyThresholds, tentukanPercentile(ambang persentil latensi model) danValueInMilliseconds(nilai persentil latensi model dalam milidetik). -
(Opsional) Untuk
FlatInvocations, Anda dapat menentukan apakah akan melanjutkan uji beban saat kecepatan TPS (pemanggilan per menit) rata. Tingkat TPS yang rata biasanya berarti bahwa titik akhir telah mencapai kapasitas. Namun, Anda mungkin ingin terus memantau titik akhir dalam kondisi kapasitas penuh. Untuk melanjutkan uji beban saat ini terjadi, tentukan nilai ini sebagaiContinue. Jika tidak, nilai defaultnya adalahStop.
-
# Create a low-level SageMaker service client. import boto3 aws_region=<INSERT>sagemaker_client=boto3.client('sagemaker', region=aws_region) # Provide a name to your recommendation based on load testing load_test_job_name="<INSERT>"# Provide the name of the sagemaker instance type instance_type="<INSERT>"# Provide the IAM Role that gives SageMaker permission to access AWS services role_arn='arn:aws:iam::<account>:role/*' # Provide your model package ARN that was created when you registered your # model with Model Registry model_package_arn='arn:aws:sagemaker:<region>:<account>:role/*' sagemaker_client.create_inference_recommendations_job( JobName=load_test_job_name, JobType="Advanced", RoleArn=role_arn, InputConfig={ 'ModelPackageVersionArn': model_package_arn, "JobDurationInSeconds": 7200, 'TrafficPattern' : { # Replace PHASES with STAIRS to use the stairs traffic pattern 'TrafficType': 'PHASES', 'Phases': [ { 'InitialNumberOfUsers': 1, 'SpawnRate': 1, 'DurationInSeconds': 120 }, { 'InitialNumberOfUsers': 1, 'SpawnRate': 1, 'DurationInSeconds': 120 } ] # Uncomment this section and comment out the Phases object above to use the stairs traffic pattern # 'Stairs' : { # 'DurationInSeconds': 240, # 'NumberOfSteps': 2, # 'UsersPerStep': 2 # } }, 'ResourceLimit': { 'MaxNumberOfTests': 10, 'MaxParallelOfTests': 3 }, "EndpointConfigurations" : [{ 'InstanceType': 'ml.c5.xlarge' }, { 'InstanceType': 'ml.m5.xlarge' }, { 'InstanceType': 'ml.r5.xlarge' }] # Uncomment the ServerlessConfig and comment out the InstanceType field if you want recommendations for a serverless endpoint # "ServerlessConfig": { # "MaxConcurrency":value, # "MemorySizeInMB":value# } }, StoppingConditions={ 'MaxInvocations': 1000, 'ModelLatencyThresholds':[{ 'Percentile': 'P95', 'ValueInMilliseconds': 100 }], # Change 'Stop' to 'Continue' to let the load test continue if invocations flatten 'FlatInvocations': 'Stop' } )Lihat Panduan Refer SageMaker ensi API Amazon untuk daftar lengkap argumen opsional dan wajib yang dapat Anda sampaikan
CreateInferenceRecommendationsJob. -
- AWS CLI
-
Gunakan
create-inference-recommendations-jobAPI untuk membuat uji beban Inference Recommender. TentukanAdvanceduntukJobTypebidang dan berikan:-
Nama pekerjaan untuk uji beban Anda (
job-name). Nama pekerjaan harus unik di Wil AWS ayah Anda dan di dalam AWS akun Anda. -
Nama Sumber Daya Amazon (ARN) dari peran IAM yang memungkinkan Inferensi Rekomendasi untuk melakukan tugas atas nama Anda. Definisikan ini untuk
role-arnlapangan. -
Kamus konfigurasi titik akhir (
input-config) di mana Anda menentukan yang berikut:-
Untuk
TrafficPattern, tentukan fase atau pola lalu lintas tangga. Dengan pola lalu lintas fase, pengguna baru muncul setiap menit pada tingkat yang Anda tentukan. Dengan pola lalu lintas tangga, pengguna baru muncul pada interval waktu (atau langkah) dengan kecepatan yang Anda tentukan. Pilih salah satu cara berikut:-
Untuk
TrafficType, tentukanPHASES. Kemudian, untukPhasesarray, tentukanInitialNumberOfUsers(berapa banyak pengguna bersamaan untuk memulai, dengan minimal 1 dan maksimum 3),SpawnRate(jumlah pengguna yang akan muncul dalam satu menit untuk fase pengujian beban tertentu, dengan minimal 0 dan maksimum 3), danDurationInSeconds(berapa lama fase lalu lintas harus, dengan minimal 120 dan maksimum 3600). -
Untuk
TrafficType, tentukanSTAIRS. Kemudian, untukStairsarray, tentukanDurationInSeconds(berapa lama fase lalu lintas harus, dengan minimal 120 dan maksimum 3600),NumberOfSteps(berapa banyak interval yang digunakan selama fase), danUsersPerStep(berapa banyak pengguna ditambahkan selama setiap interval). Perhatikan bahwa panjang setiap langkah adalah nilaiDurationInSeconds / NumberOfSteps. Misalnya, jika AndaDurationInSecondsadalah600dan Anda menentukan5langkah-langkah, maka setiap langkah panjangnya 120 detik.catatan
Pengguna didefinisikan sebagai aktor yang dihasilkan sistem yang berjalan dalam loop dan memanggil permintaan ke titik akhir sebagai bagian dari Inference Recommender. Untuk wadah XGBoost khas yang berjalan pada
ml.c5.largeinstance, titik akhir dapat mencapai 30.000 pemanggilan per menit (500 tps) hanya dengan 15-20 pengguna.
-
-
Untuk
ResourceLimit, tentukanMaxNumberOfTests(jumlah maksimum uji beban benchmarking untuk pekerjaan Inferensi Recommender, dengan minimal 1 dan maksimum 10) danMaxParallelOfTests(jumlah maksimum uji beban benchmarking paralel untuk pekerjaan Rekomendasi Inferensi, dengan minimal 1 dan maksimum 10). -
Untuk
EndpointConfigurations, Anda dapat menentukan salah satu dari berikut ini:-
InstanceTypeBidang, tempat Anda menentukan jenis instance tempat Anda ingin menjalankan tes beban. -
The
ServerlessConfig, di mana Anda menentukan nilai ideal Anda untukMaxConcurrencydanMemorySizeInMBuntuk titik akhir tanpa server.
-
-
-
Kamus kondisi penghentian (
stopping-conditions), di mana jika salah satu kondisi terpenuhi, pekerjaan Inferensi Recommender berhenti. Untuk contoh ini, tentukan bidang berikut dalam kamus:-
Untuk
MaxInvocations, tentukan jumlah maksimum permintaan per menit yang diharapkan untuk titik akhir, dengan minimal 1 dan maksimum 30.000. -
Untuk
ModelLatencyThresholds, tentukanPercentile(ambang persentil latensi model) danValueInMilliseconds(nilai persentil latensi model dalam milidetik). -
(Opsional) Untuk
FlatInvocations, Anda dapat menentukan apakah akan melanjutkan uji beban saat kecepatan TPS (pemanggilan per menit) rata. Tingkat TPS yang rata biasanya berarti bahwa titik akhir telah mencapai kapasitas. Namun, Anda mungkin ingin terus memantau titik akhir dalam kondisi kapasitas penuh. Untuk melanjutkan uji beban saat ini terjadi, tentukan nilai ini sebagaiContinue. Jika tidak, nilai defaultnya adalahStop.
-
aws sagemaker create-inference-recommendations-job\ --region<region>\ --job-name<job-name>\ --job-type ADVANCED\ --role-arn arn:aws:iam::<account>:role/*\ --input-config \"{ \"ModelPackageVersionArn\": \"arn:aws:sagemaker:<region>:<account>:role/*\", \"JobDurationInSeconds\": 7200, \"TrafficPattern\" : { # Replace PHASES with STAIRS to use the stairs traffic pattern \"TrafficType\": \"PHASES\", \"Phases\": [ { \"InitialNumberOfUsers\": 1, \"SpawnRate\": 60, \"DurationInSeconds\": 300 } ] # Uncomment this section and comment out the Phases object above to use the stairs traffic pattern # 'Stairs' : { # 'DurationInSeconds': 240, # 'NumberOfSteps': 2, # 'UsersPerStep': 2 # } }, \"ResourceLimit\": { \"MaxNumberOfTests\": 10, \"MaxParallelOfTests\": 3 }, \"EndpointConfigurations\" : [ { \"InstanceType\": \"ml.c5.xlarge\" }, { \"InstanceType\": \"ml.m5.xlarge\" }, { \"InstanceType\": \"ml.r5.xlarge\" } # Use the ServerlessConfig and leave out the InstanceType fields if you want recommendations for a serverless endpoint # \"ServerlessConfig\": { # \"MaxConcurrency\":value, # \"MemorySizeInMB\":value# } ] }\" --stopping-conditions \"{ \"MaxInvocations\": 1000, \"ModelLatencyThresholds\":[ { \"Percentile\": \"P95\", \"ValueInMilliseconds\": 100 } ], # Change 'Stop' to 'Continue' to let the load test continue if invocations flatten \"FlatInvocations\": \"Stop\" }\" -
- Amazon SageMaker Studio Classic
-
Buat uji beban dengan Studio Classic.
-
Di aplikasi Studio Classic Anda, pilih ikon beranda (
 ).
-
Di sidebar kiri Studio Classic, pilih Deployments.
-
Pilih Inference Recommender dari daftar dropdown.
-
Pilih Buat pekerjaan rekomendasi inferensi. Tab baru berjudul Buat pekerjaan rekomendasi inferensi terbuka.
-
Pilih nama grup model Anda dari bidang Grup model dropdown. Daftar ini mencakup semua grup model yang terdaftar dengan registri model di akun Anda, termasuk model yang terdaftar di luar Studio Classic.
-
Pilih versi model dari bidang versi model dropdown.
-
Pilih Lanjutkan.
-
Berikan nama untuk pekerjaan di bidang Nama.
-
(Opsional) Berikan deskripsi pekerjaan Anda di bidang Deskripsi.
-
Pilih peran IAM yang memberikan izin Inferensi Rekomendasi untuk mengakses layanan. AWS Anda dapat membuat peran dan melampirkan kebijakan yang dikelola
AmazonSageMakerFullAccessIAM untuk menyelesaikan ini, atau Anda dapat membiarkan Studio Classic membuat peran untuk Anda. -
Pilih Kondisi Ber henti untuk memperluas bidang input yang tersedia. Berikan serangkaian kondisi untuk menghentikan rekomendasi penerapan.
-
Tentukan jumlah maksimum permintaan per menit yang diharapkan untuk titik akhir di bidang Pemang gilan Maks Per Menit.
-
Tentukan ambang latensi model dalam mikrodetik di bidang Model Latency Threshold. Ambang Latensi Model menggambarkan interval waktu yang dibutuhkan oleh model untuk merespons seperti yang dilihat dari Inference Recommender. Interval termasuk waktu komunikasi lokal yang diperlukan untuk mengirim permintaan dan untuk mengambil respons dari wadah model dan waktu yang dibutuhkan untuk menyelesaikan inferensi dalam wadah.
-
-
Pilih P ola Lalu Lintas untuk memperluas bidang input yang tersedia.
-
Tetapkan jumlah awal pengguna virtual dengan menentukan bilangan bulat di bidang Jumlah Pengguna Awal.
-
Berikan bilangan bulat untuk bidang Spawn Rate. Tingkat spawn menetapkan jumlah pengguna yang dibuat per detik.
-
Tetapkan durasi fase dalam detik dengan menentukan bilangan bulat di bidang Durasi.
-
(Opsional) Tambahkan pola lalu lintas tambahan. Untuk melakukannya, pilih Tam bah.
-
-
Pilih pengaturan Tambahan untuk menampilkan bidang Durasi uji maksimum. Tentukan, dalam hitungan detik, waktu maksimum yang dapat dilakukan tes selama pekerjaan. Pekerjaan baru tidak dijadwalkan setelah durasi yang ditentukan. Ini membantu memastikan pekerjaan yang sedang berlangsung tidak dihentikan dan bahwa Anda hanya melihat pekerjaan yang telah selesai.
-
Pilih Lanjutkan.
-
Pilih Instans yang Dipilih.
-
Di bidang Instans untuk pembandingan, pilih Tambahkan instance untuk diuji. Pilih hingga 10 instans untuk Inference Recommender untuk digunakan untuk pengujian beban.
-
Pilih Pengaturan tambahan.
-
Berikan bilangan bulat yang menetapkan batas atas jumlah pengujian yang dapat dilakukan pekerjaan untuk bidang Jumlah pengujian maksimum. Perhatikan bahwa setiap konfigurasi titik akhir menghasilkan uji beban baru.
-
Berikan bilangan bulat untuk bidang uji paralel Max. Pengaturan ini mendefinisikan batas atas jumlah tes beban yang dapat berjalan secara paralel.
-
-
Pilih Kirim.
Tes beban bisa memakan waktu hingga 2 jam.
Awas
Jangan tutup tab ini. Jika Anda menutup tab ini, Anda membatalkan pekerjaan uji beban Inferensi Recommender.
-
- SageMaker AI console
-
Buat uji beban khusus melalui konsol SageMaker AI dengan melakukan hal berikut:
-
Buka konsol SageMaker AI di https://console.aws.amazon.com/sagemaker/
. -
Di panel navigasi kiri, pilih Inferensi, lalu pilih Inferensi rekomendator.
-
Pada halaman pekerjaan rekomendasi inferensi, pilih Buat pekerjaan.
-
Untuk Langkah 1: Konfigurasi model, lakukan hal berikut:
-
Untuk Jenis pekerjaan, pilih Pekerjaan rekomendasi lanjutan.
-
Jika Anda menggunakan model yang terdaftar di registri model SageMaker AI, maka aktifkan sak elar Pilih model dari registri model dan lakukan hal berikut:
-
Untuk daftar dropdown grup model, pilih grup model di registri model SageMaker AI tempat model Anda berada.
-
Untuk daftar dropdown versi Model, pilih versi model yang diinginkan.
-
-
Jika Anda menggunakan model yang telah Anda buat di SageMaker AI, matikan tombol Pilih model dari registri model dan lakukan hal berikut:
-
Untuk bidang Nama model, masukkan nama model SageMaker AI Anda.
-
-
Untuk peran IAM, Anda dapat memilih peran AWS IAM yang ada yang memiliki izin yang diperlukan untuk membuat pekerjaan rekomendasi instans. Atau, jika Anda tidak memiliki peran yang sudah ada, Anda dapat memilih Buat peran baru untuk membuka pop-up pembuatan peran, dan SageMaker AI menambahkan izin yang diperlukan ke peran baru yang Anda buat.
-
Untuk bucket S3 untuk pembandingan payload, masukkan jalur Amazon S3 ke arsip payload sampel Anda, yang harus berisi file muatan sampel yang digunakan Inference Recommender untuk membandingkan model Anda pada jenis instans yang berbeda.
-
Untuk jenis konten payload, masukkan jenis MIME dari data payload sampel Anda.
-
Untuk pola lalu lintas, konfigurasikan fase untuk uji beban dengan melakukan hal berikut:
-
Untuk Jumlah pengguna awal, tentukan berapa banyak pengguna bersamaan yang ingin Anda mulai dengan (dengan minimal 1 dan maksimum 3).
-
Untuk tingkat Spawn, tentukan jumlah pengguna yang akan muncul dalam satu menit untuk fase tersebut (dengan minimum 0 dan maksimum 3).
-
Untuk Durasi (detik), tentukan seberapa rendah fase lalu lintas harus dalam detik (dengan minimal 120 dan maksimum 3600).
-
-
(Opsional) Jika Anda menonaktifkan sakelar Pilih model dari registri model dan menentukan model SageMaker AI, maka untuk konfigurasi Kontainer, lakukan hal berikut:
-
Untuk daftar dropdown Domain, pilih domain pembelajaran mesin model, seperti visi komputer, pemrosesan bahasa alami, atau pembelajaran mesin.
-
Untuk daftar dropdown Framework, pilih kerangka wadah Anda, seperti TensorFlow atau XGBoost.
-
Untuk versi Framework, masukkan versi kerangka kerja dari image kontainer Anda.
-
Untuk daftar tar ik-turun nama model terdekat, pilih model pra-terlatih yang sebagian besar cocok dengan model Anda sendiri.
-
Untuk daftar drop-down Tugas, pilih tugas pembelajaran mesin yang diselesaikan model, seperti klasifikasi gambar atau regresi.
-
-
(Opsional) Untuk kompilasi Model menggunakan SageMaker Neo, Anda dapat mengonfigurasi pekerjaan rekomendasi untuk model yang telah Anda kompilasi menggunakan SageMaker Neo. Untuk Konfigurasi input data, masukkan bentuk data input yang benar untuk model Anda dalam format yang mirip dengan
{'input':[1,1024,1024,3]}. -
Pilih Berikutnya.
-
-
Untuk Langkah 2: Instans dan parameter lingkungan, lakukan hal berikut:
-
Untuk Pilih instans untuk pembandingan, pilih hingga 8 jenis instans yang ingin Anda tolok ukur.
-
(Opsional) Untuk rentang parameter Lingkungan, Anda dapat menentukan parameter lingkungan yang membantu mengoptimalkan model Anda. Tentukan parameter sebagai pasangan Kunci dan Nilai.
-
Pilih Berikutnya.
-
-
Untuk Langkah 3: Parameter pekerjaan, lakukan hal berikut:
-
(Opsional) Untuk bidang Nama pekerjaan, masukkan nama untuk pekerjaan rekomendasi instans Anda. Saat Anda membuat pekerjaan, SageMaker AI menambahkan stempel waktu ke akhir nama ini.
-
(Opsional) Untuk bidang Deskripsi pekerjaan, masukkan deskripsi untuk pekerjaan.
-
(Opsional) Untuk daftar dropdown kunci enkripsi, pilih AWS KMS kunci berdasarkan nama atau masukkan ARN-nya untuk mengenkripsi data Anda.
-
(Opsional) Untuk Jumlah pengujian maksimum, masukkan jumlah pengujian yang ingin Anda jalankan selama pekerjaan rekomendasi.
-
(Opsional) Untuk pengujian paralel Max, masukkan jumlah maksimum pengujian paralel yang ingin Anda jalankan selama pekerjaan rekomendasi.
-
Untuk Durasi pengujian Maks, masukkan jumlah detik maksimum yang Anda inginkan untuk dijalankan setiap pengujian.
-
Untuk Pemanggilan maksimum per menit, masukkan jumlah maksimum permintaan per menit yang dapat dicapai titik akhir sebelum menghentikan pekerjaan rekomendasi. Setelah mencapai batas ini, SageMaker AI mengakhiri pekerjaan.
-
Untuk ambang latensi model P99 (ms), masukkan persentil latensi model dalam milidetik.
-
Pilih Berikutnya.
-
-
Untuk Langkah 4: Tinjau pekerjaan, tinjau konfigurasi Anda, lalu pilih K irim.
-
Dapatkan hasil uji beban Anda
Anda dapat mengumpulkan metrik secara terprogram di semua pengujian beban setelah pengujian beban dilakukan dengan AWS SDK untuk Python (Boto3) AWS CLI, Studio Classic, atau konsol SageMaker AI.
- AWS SDK untuk Python (Boto3)
-
Kumpulkan metrik dengan
DescribeInferenceRecommendationsJobAPI. Tentukan nama pekerjaan uji beban untukJobNamebidang:load_test_response = sagemaker_client.describe_inference_recommendations_job( JobName=load_test_job_name )Cetak objek respons.
load_test_response['Status']Ini mengembalikan respons JSON yang mirip dengan contoh berikut. Perhatikan bahwa contoh ini menunjukkan jenis instance yang direkomendasikan untuk inferensi real-time (untuk contoh yang menunjukkan rekomendasi inferensi tanpa server, lihat contoh setelah ini).
{ 'JobName':'job-name', 'JobDescription':'job-description', 'JobType': 'Advanced', 'JobArn': 'arn:aws:sagemaker:region:account-id:inference-recommendations-job/resource-id', 'Status': 'COMPLETED', 'CreationTime': datetime.datetime(2021, 10, 26, 19, 38, 30, 957000, tzinfo=tzlocal()), 'LastModifiedTime': datetime.datetime(2021, 10, 26, 19, 46, 31, 399000, tzinfo=tzlocal()), 'InputConfig': { 'ModelPackageVersionArn': 'arn:aws:sagemaker:region:account-id:model-package/resource-id', 'JobDurationInSeconds': 7200, 'TrafficPattern': { 'TrafficType': 'PHASES' }, 'ResourceLimit': { 'MaxNumberOfTests': 100, 'MaxParallelOfTests': 100 }, 'EndpointConfigurations': [{ 'InstanceType': 'ml.c5d.xlarge' }] }, 'StoppingConditions': { 'MaxInvocations': 1000, 'ModelLatencyThresholds': [{ 'Percentile': 'P95', 'ValueInMilliseconds': 100} ]}, 'InferenceRecommendations': [{ 'Metrics': { 'CostPerHour': 0.6899999976158142, 'CostPerInference': 1.0332434612791985e-05, 'MaximumInvocations': 1113, 'ModelLatency': 100000 }, 'EndpointConfiguration': { 'EndpointName':'endpoint-name', 'VariantName':'variant-name', 'InstanceType': 'ml.c5d.xlarge', 'InitialInstanceCount': 3 }, 'ModelConfiguration': { 'Compiled': False, 'EnvironmentParameters': [] } }], 'ResponseMetadata': { 'RequestId':'request-id', 'HTTPStatusCode': 200, 'HTTPHeaders': { 'x-amzn-requestid':'x-amzn-requestid', 'content-type':'content-type', 'content-length': '1199', 'date': 'Tue, 26 Oct 2021 19:57:42 GMT' }, 'RetryAttempts': 0} }Beberapa baris pertama memberikan informasi tentang pekerjaan uji beban itu sendiri. Ini termasuk nama pekerjaan, peran ARN, pembuatan, dan waktu penghapusan.
Kam
InferenceRecommendationsus berisi daftar rekomendasi inferensi Inferensi Recommender.Kam
EndpointConfigurationus bersarang berisi rekomendasi instance type (InstanceType) bersama dengan titik akhir dan nama varian (model pembelajaran AWS mesin yang digunakan) yang digunakan selama pekerjaan rekomendasi. Anda dapat menggunakan titik akhir dan nama varian untuk pemantauan di Amazon Ev CloudWatch ents. Untuk informasi selengkapnya, lihat Metrik SageMaker AI Amazon di Amazon CloudWatch.Kam
EndpointConfigurationus bersarang juga berisi rekomendasi instance count (InitialInstanceCount). Ini adalah jumlah instance yang harus Anda sediakan di titik akhir untuk memenuhi yangMaxInvocationsditentukan dalamStoppingConditions. Misalnya, jika isml.m5.largedanInstanceTypeInitialInstanceCountis2, maka Anda harus menyediakan 2ml.m5.largeinstance untuk titik akhir Anda sehingga dapat menangani TPS yang ditentukan dalam kondisiMaxInvocationsberhenti.Kam
Metricsus bersarang berisi informasi tentang perkiraan biaya per jam (CostPerHour) untuk titik akhir real-time Anda dalam dolar AS, perkiraan biaya per inferensi (CostPerInference) untuk titik akhir waktu nyata Anda, jumlah maksimumInvokeEndpointpermintaan yang dikirim ke titik akhir, dan latensi model (ModelLatency), yang merupakan interval waktu (dalam mikrodetik) yang diambil model Anda untuk merespons AI. SageMaker Latensi model mencakup waktu komunikasi lokal yang diperlukan untuk mengirim permintaan dan mengambil respons dari wadah model dan waktu yang dibutuhkan untuk menyelesaikan inferensi dalam wadah.Contoh berikut menunjukkan
InferenceRecommendationsbagian respons untuk pekerjaan uji beban yang dikonfigurasi untuk mengembalikan rekomendasi inferensi tanpa server:"InferenceRecommendations": [ { "EndpointConfiguration": { "EndpointName": "value", "InitialInstanceCount":value, "InstanceType": "value", "VariantName": "value", "ServerlessConfig": { "MaxConcurrency":value, "MemorySizeInMb":value} }, "InvocationEndTime":value, "InvocationStartTime":value, "Metrics": { "CostPerHour":value, "CostPerInference":value, "CpuUtilization":value, "MaxInvocations":value, "MemoryUtilization":value, "ModelLatency":value, "ModelSetupTime":value}, "ModelConfiguration": { "Compiled": "False", "EnvironmentParameters": [], "InferenceSpecificationName": "value" }, "RecommendationId": "value" } ]Anda dapat menafsirkan rekomendasi untuk inferensi tanpa server mirip dengan hasil untuk inferensi real-time, dengan pengecualian
ServerlessConfig, yang memberi tahu Anda nilai yang Anda tentukan untukMaxConcurrencydanMemorySizeInMBsaat menyiapkan uji beban. Rekomendasi tanpa server juga mengukur metrikModelSetupTime, yang mengukur (dalam mikrodetik) waktu yang dibutuhkan untuk meluncurkan sumber daya komputasi pada titik akhir tanpa server. Untuk informasi selengkapnya tentang menyiapkan titik akhir tanpa server, lihat dokumentasi Serverless Inference. - AWS CLI
-
Kumpulkan metrik dengan
describe-inference-recommendations-jobAPI. Tentukan nama pekerjaan uji beban untuk benjob-namedera:aws sagemaker describe-inference-recommendations-job --job-name<job-name>Ini mengembalikan respons yang mirip dengan contoh berikut. Perhatikan bahwa contoh ini menunjukkan jenis instance yang direkomendasikan untuk inferensi real-time (untuk contoh yang menunjukkan rekomendasi Inferensi Tanpa Server, lihat contoh setelah ini).
{ 'JobName':'job-name', 'JobDescription':'job-description', 'JobType': 'Advanced', 'JobArn': 'arn:aws:sagemaker:region:account-id:inference-recommendations-job/resource-id', 'Status': 'COMPLETED', 'CreationTime': datetime.datetime(2021, 10, 26, 19, 38, 30, 957000, tzinfo=tzlocal()), 'LastModifiedTime': datetime.datetime(2021, 10, 26, 19, 46, 31, 399000, tzinfo=tzlocal()), 'InputConfig': { 'ModelPackageVersionArn': 'arn:aws:sagemaker:region:account-id:model-package/resource-id', 'JobDurationInSeconds': 7200, 'TrafficPattern': { 'TrafficType': 'PHASES' }, 'ResourceLimit': { 'MaxNumberOfTests': 100, 'MaxParallelOfTests': 100 }, 'EndpointConfigurations': [{ 'InstanceType': 'ml.c5d.xlarge' }] }, 'StoppingConditions': { 'MaxInvocations': 1000, 'ModelLatencyThresholds': [{ 'Percentile': 'P95', 'ValueInMilliseconds': 100 }] }, 'InferenceRecommendations': [{ 'Metrics': { 'CostPerHour': 0.6899999976158142, 'CostPerInference': 1.0332434612791985e-05, 'MaximumInvocations': 1113, 'ModelLatency': 100000 }, 'EndpointConfiguration': { 'EndpointName':'endpoint-name', 'VariantName':'variant-name', 'InstanceType': 'ml.c5d.xlarge', 'InitialInstanceCount': 3 }, 'ModelConfiguration': { 'Compiled': False, 'EnvironmentParameters': [] } }], 'ResponseMetadata': { 'RequestId':'request-id', 'HTTPStatusCode': 200, 'HTTPHeaders': { 'x-amzn-requestid':'x-amzn-requestid', 'content-type':'content-type', 'content-length': '1199', 'date': 'Tue, 26 Oct 2021 19:57:42 GMT' }, 'RetryAttempts': 0 } }Beberapa baris pertama memberikan informasi tentang pekerjaan uji beban itu sendiri. Ini termasuk nama pekerjaan, peran ARN, pembuatan, dan waktu penghapusan.
Kam
InferenceRecommendationsus berisi daftar rekomendasi inferensi Inferensi Recommender.Kam
EndpointConfigurationus bersarang berisi rekomendasi instance type (InstanceType) bersama dengan titik akhir dan nama varian (model pembelajaran AWS mesin yang digunakan) yang digunakan selama pekerjaan rekomendasi. Anda dapat menggunakan titik akhir dan nama varian untuk pemantauan di Amazon Ev CloudWatch ents. Untuk informasi selengkapnya, lihat Metrik SageMaker AI Amazon di Amazon CloudWatch.Kam
Metricsus bersarang berisi informasi tentang perkiraan biaya per jam (CostPerHour) untuk titik akhir real-time Anda dalam dolar AS, perkiraan biaya per inferensi (CostPerInference) untuk titik akhir waktu nyata Anda, jumlah maksimumInvokeEndpointpermintaan yang dikirim ke titik akhir, dan latensi model (ModelLatency), yang merupakan interval waktu (dalam mikrodetik) yang diambil model Anda untuk merespons AI. SageMaker Latensi model mencakup waktu komunikasi lokal yang diperlukan untuk mengirim permintaan dan mengambil respons dari wadah model dan waktu yang dibutuhkan untuk menyelesaikan inferensi dalam wadah.Contoh berikut menunjukkan
InferenceRecommendationsbagian respons untuk pekerjaan uji beban yang dikonfigurasi untuk mengembalikan rekomendasi inferensi tanpa server:"InferenceRecommendations": [ { "EndpointConfiguration": { "EndpointName": "value", "InitialInstanceCount":value, "InstanceType": "value", "VariantName": "value", "ServerlessConfig": { "MaxConcurrency":value, "MemorySizeInMb":value} }, "InvocationEndTime":value, "InvocationStartTime":value, "Metrics": { "CostPerHour":value, "CostPerInference":value, "CpuUtilization":value, "MaxInvocations":value, "MemoryUtilization":value, "ModelLatency":value, "ModelSetupTime":value}, "ModelConfiguration": { "Compiled": "False", "EnvironmentParameters": [], "InferenceSpecificationName": "value" }, "RecommendationId": "value" } ]Anda dapat menafsirkan rekomendasi untuk inferensi tanpa server mirip dengan hasil untuk inferensi real-time, dengan pengecualian
ServerlessConfig, yang memberi tahu Anda nilai yang Anda tentukan untukMaxConcurrencydanMemorySizeInMBsaat menyiapkan uji beban. Rekomendasi tanpa server juga mengukur metrikModelSetupTime, yang mengukur (dalam mikrodetik) waktu yang dibutuhkan untuk meluncurkan sumber daya komputer pada titik akhir tanpa server. Untuk informasi selengkapnya tentang menyiapkan titik akhir tanpa server, lihat dokumentasi Serverless Inference. - Amazon SageMaker Studio Classic
-
Rekomendasi diisi di tab baru yang disebut Rekomendasi inferensi dalam Studio Classic. Diperlukan waktu hingga 2 jam agar hasilnya muncul. Tab ini berisi kolom Hasil dan Detail.
Kolom Detail menyediakan informasi tentang pekerjaan uji beban, seperti nama yang diberikan untuk pekerjaan uji beban, saat pekerjaan dibuat (Waktu pembuatan), dan banyak lagi. Ini juga berisi informasi Peng aturan, seperti jumlah maksimum pemanggilan yang terjadi per menit dan informasi tentang Nama Sumber Daya Amazon yang digunakan.
Kolom Hasil menyediakan jendela tujuan Deployment dan rekomendasi SageMaker AI di mana Anda dapat menyesuaikan urutan tampilan hasil berdasarkan kepentingan penerapan. Ada tiga menu dropdown di mana Anda dapat memberikan tingkat kepentingan Biaya, Latensi, dan Th roughput untuk kasus penggunaan Anda. Untuk setiap sasaran (biaya, latensi, dan throughput), Anda dapat mengatur tingkat kepentingan: Kepentingan Ter endah, Kepentingan R endah, Kepent ingan sedang, Kepent ingan tinggi, atau Kep entingan tertinggi.
Berdasarkan pilihan penting Anda untuk setiap tujuan, Inference Recommender menampilkan rekomendasi utamanya di bidang SageMaker rekomendasi di sebelah kanan panel, bersama dengan perkiraan biaya per jam dan permintaan inferensi. Ini juga menyediakan Informasi tentang latensi model yang diharapkan, jumlah maksimum pemanggilan, dan jumlah instance.
Selain rekomendasi teratas yang ditampilkan, Anda juga dapat melihat informasi yang sama ditampilkan untuk semua contoh yang diuji Inferensi Recommender di bagian Semua proses.
- SageMaker AI console
-
Anda dapat melihat hasil pekerjaan uji beban kustom Anda di konsol SageMaker AI dengan melakukan hal berikut:
-
Buka konsol SageMaker AI di https://console.aws.amazon.com/sagemaker/
. -
Di panel navigasi kiri, pilih Inferensi, lalu pilih Inferensi rekomendator.
-
Pada halaman pekerjaan rekomendasi inferensi, pilih nama pekerjaan rekomendasi inferensi Anda.
Pada halaman detail untuk pekerjaan Anda, Anda dapat melihat rekomendasi inferensi, yang merupakan jenis instans yang direkomendasikan SageMaker AI untuk model Anda, seperti yang ditunjukkan pada tangkapan layar berikut.
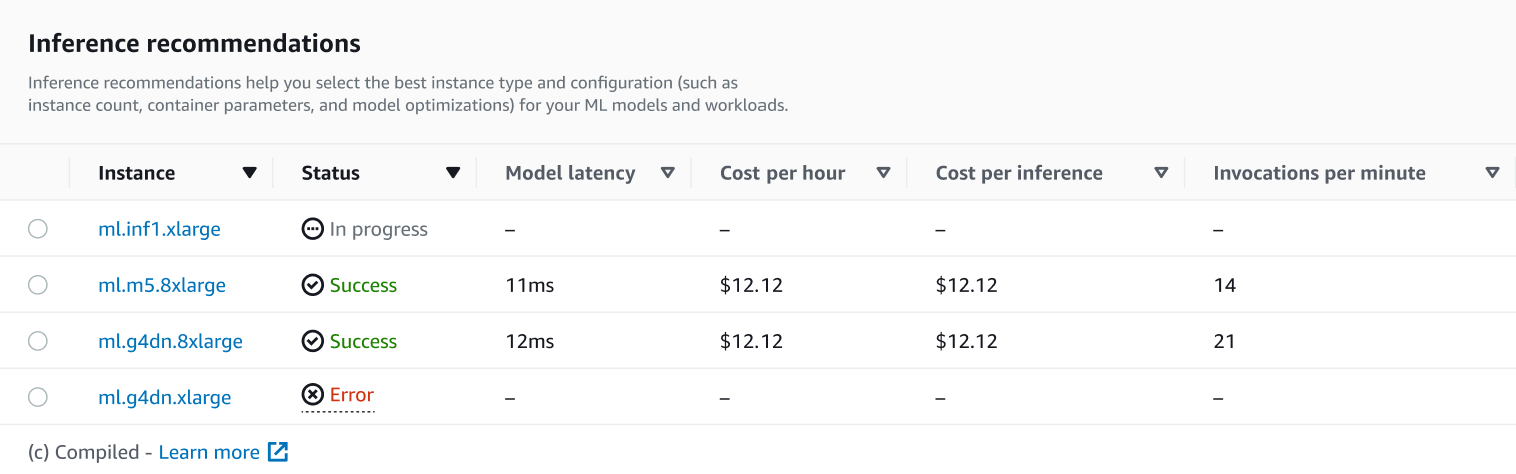
Di bagian ini, Anda dapat membandingkan jenis instans berdasarkan berbagai faktor seperti latensi Model, Biaya per jam, Biaya per inferensi, dan Pemanggilan per menit.
Di halaman ini, Anda juga dapat melihat konfigurasi yang Anda tentukan untuk pekerjaan Anda. Di bagian Monitor, Anda dapat melihat CloudWatch metrik Amazon yang dicatat untuk setiap jenis instans. Untuk mempelajari lebih lanjut tentang menafsirkan metrik ini, lihat Men afsirkan hasil.
-
