Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
HBase pada Amazon S3 (mode penyimpanan Amazon S3)
Ketika Anda menjalankan HBase di Amazon EMR versi 5.2.0 atau yang lebih baru, Anda dapat mengaktifkan HBase di Amazon S3 dengan keuntungan sebagai berikut:
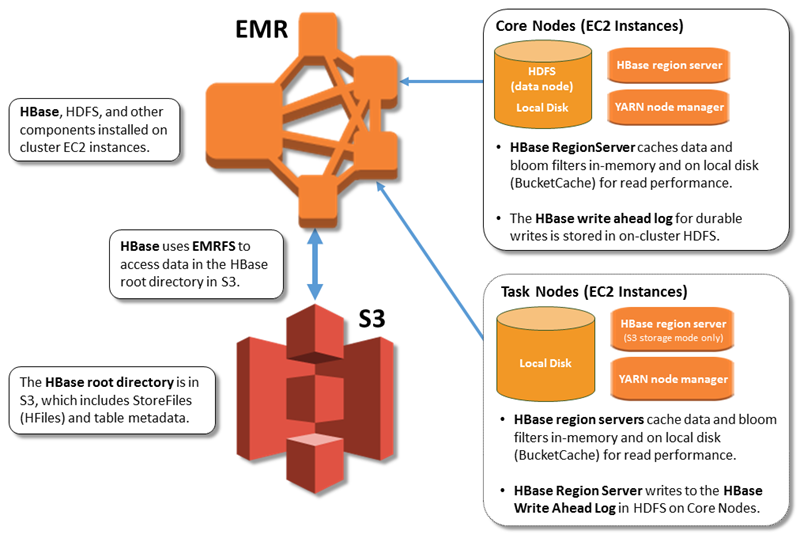
Direktori root HBase disimpan di Amazon S3, termasuk file penyimpanan HBase dan metadata tabel. Data ini persisten di luar klaster, tersedia di seluruh Amazon EC2 Availability Zone, dan Anda tidak perlu memulihkan menggunakan snapshot atau metode lainnya.
Dengan file penyimpanan di Amazon S3, Anda dapat mengukur klaster Amazon EMR Anda untuk kebutuhan komputasi Anda alih-alih persyaratan data, dengan replikasi 3x di HDFS.
Menggunakan Amazon EMR versi 5.7.0 atau yang lebih baru, Anda dapat mengatur sebuah klaster replika baca, yang memungkinkan Anda untuk mempertahankan salinan data baca-saja di Amazon S3. Anda dapat mengakses data dari klaster replika baca untuk melakukan operasi baca secara bersamaan, dan dalam hal klaster utama menjadi tidak tersedia.
Di Amazon EMR versi 6.2.0 hingga 7.3.0, Pelacakan HFile persisten menggunakan tabel sistem HBase yang dipanggil
hbase:storefileuntuk secara langsung melacak jalur HFile yang digunakan untuk operasi baca. Fitur ini diaktifkan secara default dan tidak memerlukan migrasi manual. Dalam versi yang lebih tinggi dari 7.3.0, jalur HFile dilacak menggunakan pelacak file, menyimpan jalur HFile langsung di file meta, di dalam direktori toko.
catatan
Pengguna yang menggunakan versi Amazon EMR sebelum 7.4.0 dan bermigrasi ke EMR-7.4.0 dan yang lebih baru, lihat Migrasi dari versi HB ase sebelumnya dan ikuti dokumentasi peningkatan yang tersedia untuk memastikan transisi yang lancar.
Ilustrasi berikut menunjukkan komponen HBase yang relevan dengan HBase di Amazon S3.
Mengaktifkan HBase di Amazon S3
Anda dapat mengaktifkan HBase di Amazon S3 menggunakan konsol Amazon EMR AWS CLI, atau Amazon EMR API. Konfigurasi adalah pilihan selama pembuatan klaster. Saat menggunakan konsol, Anda memilih pengaturan menggunakan Opsi lanjutan. Bila Anda menggunakan AWS CLI, gunakan pilihan --configurations untuk menyediakan objek konfigurasi JSON. Properti objek konfigurasi menentukan mode penyimpanan dan lokasi direktori root di Amazon S3. Lokasi Amazon S3 yang Anda tentukan harus berada di wilayah yang sama dengan klaster Amazon EMR. Hanya satu klaster aktif pada satu waktu dapat menggunakan direktori root HBase yang sama di Amazon S3. Untuk langkah-langkah konsol dan contoh create-cluster terperinci menggunakan AWS CLI, lihat. Membuat klaster dengan HBase Objek konfigurasi contoh ditunjukkan dalam potongan JSON berikut.
{
  "Classification": "hbase-site",
  "Properties": {
    "hbase.rootdir": "s3://amzn-s3-demo-bucket/my-hbase-rootdir"}
},
{
  "Classification": "hbase",
  "Properties": {
  "hbase.emr.storageMode":"s3"
  }
}
catatan
Jika Anda menggunakan bucket Amazon S3 sebagai rootdir untuk HBase, Anda harus menambahkan garis miring pada akhir URl Amazon S3. Misalnya, Anda harus menggunakan "hbase.rootdir: s3://amzn-s3-demo-bucket/", alih-alih "hbase.rootdir: s3://amzn-s3-demo-bucket", untuk menghindari masalah.
Menggunakan klaster replika baca.
Setelah Anda mengatur klaster utama menggunakan HBase di Amazon S3, Anda dapat membuat dan mengonfigurasi klaster replika baca yang menyediakan akses baca-saja ke data yang sama sebagai klaster utama. Hal ini berguna ketika Anda membutuhkan akses simultan ke data kueri atau akses terganggu jika klaster utama tidak tersedia. Fitur replika baca tersedia dengan Amazon EMR versi 5.7.0 dan yang lebih baru.
Klaster utama dan klaster replika baca diatur dengan cara yang sama dengan satu perbedaan penting. Kedua titik memiliki lokasi hbase.rootdir yang sama. Namun, klasifikasi hbase untuk klaster replika baca mencakup "hbase.emr.readreplica.enabled":"true" properti.
Cluster baca-replika dirancang untuk operasi read-only, dan tidak ada tindakan pemadatan atau penulisan manual yang harus dilakukan di atasnya. Untuk versi Amazon EMR yang lebih awal dari 7.4.0, disarankan untuk menonaktifkan pemadatan pada cluster baca-replika saat Anda mengaktifkan fitur baca-replika. Tindakan pencegahan ini diperlukan karena, dengan fitur pelacakan HFile persisten diaktifkan pada cluster utama, klaster baca-replika mungkin memadatkan tabel sistem, yang berpotensi menyebabkan sebuah FileNotFoundException pada cluster utama. Menonaktifkan pemadatan pada cluster baca-replika mencegah inkonsistensi data antara cluster primer dan baca-replika.
Misalnya, mengingat klasifikasi JSON untuk cluster utama seperti yang ditunjukkan sebelumnya dalam topik, konfigurasi untuk cluster baca-replika untuk versi EMR lebih awal dari 7.4.0 adalah sebagai berikut:
{
  "Classification": "hbase-site",
  "Properties": {
    "hbase.rootdir": "s3://amzn-s3-demo-bucket/my-hbase-rootdir",
    "hbase.regionserver.compaction.enabled": "false"
  }
},
{
  "Classification": "hbase",
  "Properties": {
  "hbase.emr.storageMode":"s3",
  "hbase.emr.readreplica.enabled":"true"
  }
}
Untuk versi Amazon EMR yang lebih baru dari 7.3.0, kami sekarang menggunakan Pelacakan File Toko fitur ini, oleh karena itu tidak perlu menonaktifkan pemadatan.
catatan
Saat menggunakan Amazon EMR versi 7.12.0 atau yang lebih baru, gunakan konfigurasi sampel berikut:
{
  "Classification": "hbase-site",
  "Properties": {
    "hbase.rootdir": "s3://{S3_LOCATION}"
  }
},
{
  "Classification": "hbase",
  "Properties": {
    "hbase.emr.storageMode": "s3",
    "hbase.emr.readreplica.enabled.v2": "true"
  }
}
Menyinkronkan replika baca ketika Anda menambahkan data
Karena replika baca menggunakan HBase StoreFiles dan metadata yang ditulis oleh cluster utama ke Amazon S3, replika baca hanya terkini seperti penyimpanan data Amazon S3. Panduan berikut dapat membantu meminimalkan jeda waktu antara klaster utama dan replika baca ketika Anda menulis data.
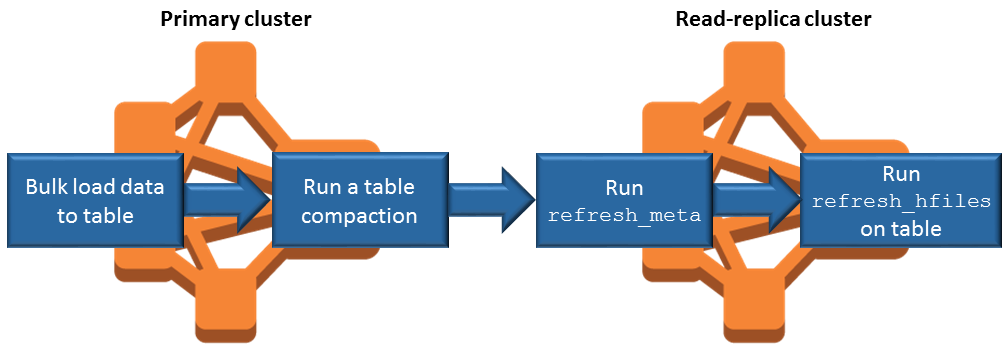
Muat data secara masal pada klaster utama bila memungkinkan. Untuk informasi lebih lanjut, lihat Muatan massal
dalam dokumentasi Apache HBase. Sebuah flush yang menulis file penyimpanan ke Amazon S3 harus terjadi sesegera mungkin setelah data ditambahkan. Flush manual atau yang disesuaikan dengan pengaturan untuk meminimalkan waktu jeda.
Jika pemadatan dapat berjalan secara otomatis, jalankan pemadatan manual untuk menghindari inkonsistensi ketika pemadatan dipicu.
Di cluster replika baca, ketika metadata telah berubah - misalnya, ketika terjadi pemisahan atau pemadatan wilayah HBase, atau ketika tabel ditambahkan atau dihapus - jalankan
refresh_metaperintah.Pada klaster replika baca, jalankan
refresh_hfilesperintah ketika catatan ditambahkan ke atau diubah dalam tabel.
Pelacakan HFile persisten
Elacakan HFile persisten menggunakan tabel sistem HBase yang disebut hbase:storefile untuk melacak jalur HFile secara langsung yang digunakan untuk operasi membaca. Jalur HFile baru ditambahkan ke tabel sebagai data yang ditambahkan ke HBase. Ini akan menghapus operasi penggantian nama sebagai mekanisme komit dalam operasi HBase jalur tulis kritis dan meningkatkan waktu pemulihan ketika membuka wilayah HBase dengan membaca dari hbase:storefile tabel sistem, alih-alih daftar direktori sistem berkas. Fitur ini diaktifkan secara default pada Amazon EMR versi 6.2.0 hingga 7.3.0 dan tidak memerlukan langkah migrasi manual apa pun.
catatan
Pelacakan HFile persisten menggunakan tabel sistem penyimpanan file HBase tidak mendukung fitur replikasi wilayah HBase. Untuk informasi selengkapnya tentang replikasi wilayah HBase, lihat pembacaan Timeline-consistent yang tersedia tinggi.
Menonaktifkan Pelacakan HFile Persisten
Pelacakan HFile persisten diaktifkan secara default dimulai dengan rilis Amazon EMR 6.2.0. Untuk menonaktifkan pelacakan HFile persisten, tentukan penggantian konfigurasi berikut saat meluncurkan sebuah klaster:
{
  "Classification": "hbase-site",
  "Properties": {
    "hbase.storefile.tracking.persist.enabled":"false",
    "hbase.hstore.engine.class":"org.apache.hadoop.hbase.regionserver.DefaultStoreEngine"
  }
}
catatan
Ketika mengonfigurasi klaster Amazon EMR, semua grup instans harus diperbarui.
Menyinkronkan Tabel Storefile secara Manual
Tabel storefile selalu diperbarui saat instance HFile baru dibuat. Namun, jika tabel storefile menjadi tidak sinkron dengan file data karena alasan apa pun, perintah berikut dapat digunakan untuk menyinkronkan data secara manual:
Sinkronkan tabel storefile di wilayah online:
hbase org.apache.hadoop.hbase.client.example.RefreshHFilesClient <table>
Sinkronkan tabel storefile di wilayah offline:
Hapus znode tabel penyimpanan file.
echo "ls /hbase/storefile/loaded" | sudo -u hbase hbase zkcli
[<tableName>, hbase:namespace]
# The TableName exists in the list
echo "delete /hbase/storefile/loaded/<tableName>" | sudo -u hbase hbase zkcli
# Delete the Table ZNode
echo "ls /hbase/storefile/loaded" | sudo -u hbase hbase zkcli
[hbase:namespace]
Tetapkan wilayah (jalankan di 'Hbase shell').
hbase cli> assign '<region name>'Jika tugas gagal.
hbase cli> disable '<table name>'
hbase cli> enable '<table name>'
Menskalakan Tabel Storefile
Tabel penyimpanan file dibagi menjadi empat wilayah secara default. Jika tabel penyimpanan file masih di bawah beban menulis berat, tabel dapat dibagi secara manual.
Untuk membagi wilayah panas tertentu, gunakan perintah berikut (jalankan di 'Hbase shell').
hbase cli> split '<region name>'
Untuk membagi tabel, gunakan perintah berikut (jalankan di 'Hbase shell').
hbase cli> split 'hbase:storefile'
Pelacakan File Toko
Secara default, kami menggunakan FileBasedStoreFileTracker implementasi. Implementasi ini membuat file baru langsung di direktori toko, menghindari kebutuhan untuk operasi ganti nama. Itu menyimpan daftar instance hfile berkomitmen dalam memori, didukung oleh file meta di setiap direktori toko. Setiap kali hfile baru dikomit, daftar file yang dilacak di toko yang diberikan diperbarui dan file meta baru ditulis dengan konten daftar dan membuang file meta sebelumnya, yang berisi daftar usang. Informasi lebih lanjut tentang Pelacakan File Store dapat ditemukan di Pelacakan File Store
Impl FileBasedStoreFile ementasi pelacak diaktifkan secara default, dimulai dengan rilis Amazon EMR 7.4.0:
{
  "Classification": "hbase-site",
  "Properties": {
    hbase.store.file-tracker.impl: "org.apache.hadoop.hbase.regionserver.storefiletracker.FileBasedStoreFileTracker"
   }
}
Untuk menonaktifkan FileBasedStoreFileTracker implementasi, tentukan penggantian konfigurasi berikut saat meluncurkan cluster:
{
  "Classification": "hbase-site",
  "Properties": {
    hbase.store.file-tracker.impl: "org.apache.hadoop.hbase.regionserver.storefiletracker.DefaultStoreFileTracker"
   }
}
catatan
Ketika mengonfigurasi klaster Amazon EMR, semua grup instans harus diperbarui.
Mengkonfigurasi kebijakan baca S3A untuk HBase
Dimulai dengan Amazon EMR versi 7.10, HBase di Amazon S3 menggunakan klien sistem file S3A. Secara default, fs.s3a.experimental.input.fadvise properti disetel kenormal. Dalam mode ini, S3A secara otomatis menyesuaikan antara kebijakan pembacaan berurutan dan acak berdasarkan pola akses yang diamati dari aliran input.
HBase di Amazon S3 mengandalkan pembacaan berurutan untuk pemadatan, pemindaian, dan beban massal. Dalam beberapa kasus, mode normal mungkin beralih ke kebijakan baca acak. Ini dapat terjadi meskipun pembacaan berikutnya tetap berurutan. Ketika ini terjadi, kinerja baca untuk pemadatan, pemindaian, dan beban massal dapat menurun secara signifikan.
Versi yang terpengaruh
Masalah ini berlaku untuk Amazon EMR versi 7.10, 7.11, 7.12, dan 7.13 dengan HBase.
Jika Anda mengalami salah satu gejala berikut, setel kebijakan baca S3A ke: sequential
Pemadatan lambat
Meningkatnya jumlah HFiles
Operasi flush yang diblokir mengakibatkan
RegionTooBusyExceptionkesalahanOperasi pemindaian dan pemuatan massal lebih lambat dibandingkan dengan versi Amazon EMR sebelumnya
Tentukan konfigurasi berikut saat Anda membuat cluster Anda:
[
  {
    "Classification": "hbase-site",
    "Properties": {
      "fs.s3a.experimental.input.fadvise": "sequential"
    }
  }
]
Terapkan properti ini hbase-site.xml pada semua node. Perubahan ini berlaku setelah Anda memulai ulang proses server primer dan wilayah HBase.
Cluster-wide konfigurasi direkomendasikan
Sebaiknya atur ke seluruh sequential cluster fs.s3a.experimental.input.fadvise untuk semua beban kerja HBase pada versi yang terpengaruh. Jika Anda menerapkan pengaturan hanya untuk perintah individual, penurunan kinerja untuk pemadatan dan pemindaian tetap ada.
Mengkonfigurasi kebijakan baca untuk operasi pemuatan massal
Jika Anda hanya perlu meningkatkan kinerja beban massal tanpa mengubah konfigurasi seluruh cluster, Anda dapat meneruskan properti langsung ke perintah. completebulkload
Untuk menggunakan kebijakan baca berurutan untuk operasi pemuatan massal tunggal:
sudo -u hbase hbase completebulkload \
  -Dfs.s3a.experimental.input.fadvise=sequential \
  s3://amzn-s3-demo-bucket/path/to/hfiles table_name
Atau, Anda dapat menggunakan EMRFS untuk operasi beban massal:
sudo -u hbase hbase completebulkload \
  -Dfs.s3.impl=com.amazon.ws.emr.hadoop.fs.EmrFileSystem \
  s3://amzn-s3-demo-bucket/path/to/hfiles table_name
Pertimbangan operasional
Server wilayah HBase digunakan BlockCache untuk menyimpan data yang dibaca dalam memori dan BucketCache untuk menyimpan data yang dibaca pada disk lokal. Selain itu, server wilayah digunakan MemStore untuk menyimpan data penulisan dalam memori, dan menggunakan log penulisan ke depan untuk menyimpan penulisan data di HDFS sebelum data ditulis ke HB StoreFiles ase di Amazon S3. Performa baca klaster Anda berhubungan dengan seberapa sering catatan dapat diambil dari di-memori atau di-disk cache. Kehilangan cache mengakibatkan catatan dibaca dari StoreFile di Amazon S3, yang memiliki latensi yang jauh lebih tinggi dan standar deviasi yang lebih tinggi daripada membaca dari HDFS. Selain itu, tingkat permintaan maksimum untuk Amazon S3 lebih rendah dari yang dapat dicapai dari cache lokal, jadi data caching mungkin penting untuk beban kerja baca-berat. Untuk informasi selengkapnya tentang kinerja Amazon S3, lihat Pengoptimalan kinerja di Panduan Pengguna Layanan Penyimpanan Sederhana Amazon.
Untuk meningkatkan performa, kami sarankan Anda mencache sebanyak mungkin set data dalam penyimpanan instans EC2. Karena BucketCache menggunakan penyimpanan instans EC2 server wilayah, Anda dapat memilih jenis instans EC2 dengan penyimpanan instans yang memadai dan menambahkan penyimpanan Amazon EBS untuk mengakomodasi ukuran cache yang diperlukan. Anda juga dapat menambah BucketCache ukuran pada penyimpanan instans terlampir dan volume EBS menggunakan hbase.bucketcache.size properti. Pengaturan default adalah 8.192 MB.
Untuk penulisan, frekuensi MemStore pembilasan dan jumlah kehadiran StoreFiles selama pemadatan kecil dan besar dapat berkontribusi secara signifikan terhadap peningkatan waktu respons server wilayah. Untuk kinerja optimal, pertimbangkan untuk meningkatkan ukuran pengganda blok MemStore flush dan HRegion, yang meningkatkan waktu yang berlalu antara pemadatan utama, tetapi juga meningkatkan jeda dalam konsistensi jika Anda menggunakan replika baca. Dalam beberapa kasus, Anda mungkin mendapatkan performa yang lebih baik menggunakan ukuran blok file yang lebih besar (tetapi kurang dari 5 GB) untuk memicu fungsi unggahan multipart Amazon S3 di EMRFS. Ukuran blok Amazon EMR default 128 MB. Untuk informasi selengkapnya, lihat Konfigurasi HDFS. Kami jarang melihat pelanggan yang melebihi ukuran blok 1 GB saat membandingkan performa dengan flushes dan pemadatan. Selain itu, pemadatan HBase dan server wilayah bekerja secara optimal ketika lebih sedikit yang StoreFiles perlu dipadatkan.
Tabel dapat memakan banyak waktu untuk diletakkan di Amazon S3 karena direktori besar perlu diganti namanya. Pertimbangkan menonaktifkan tabel, alih-alih menjatuhkannya.
Ada proses pembersih HBase yang membersihkan file WAL tua dan menyimpan file. Dengan rilis Amazon EMR versi 5.17.0 dan yang lebih baru, pembersih diaktifkan secara global, dan properti konfigurasi berikut dapat digunakan untuk mengontrol perilaku bersih.
| Properti konfigurasi | Nilai default | Deskripsi |
|---|---|---|
|
|
1 |
Jumlah benang dialokasikan untuk membersihkan HFiles besar yang telah kedaluwarsa. |
|
|
1 |
Jumlah benang yang untuk membersihkan HFiles besar yang telah kedaluwarsa. |
|
|
Atur ke seperempat dari semua core yang tersedia. |
Jumlah benang untuk memindai direktori oldWALs. |
|
|
2 |
Jumlah benang untuk membersihkan WALs di bawah direktori oldWALs. |
Dengan Amazon EMR 5.17.0 dan sebelumnya, operasi yang lebih bersih dapat mempengaruhi performa permintaan saat menjalankan beban kerja yang berat, jadi kami sarankan agar Anda mengaktifkan pembersih hanya selama waktu off-peak. Pembersih memiliki perintah HBase shell berikut:
cleaner_chore_enabledpertanyaan apakah pembersih diaktifkan.cleaner_chore_runmenjalankan pembersih secara manual untuk menghapus file.cleaner_chore_switchmengaktifkan atau menonaktifkan pembersih dan mengembalikan keadaan pembersih sebelumnya. Misalnya,cleaner_chore_switch truemengaktifkan pembersih.
Properti untuk HBase di penyetelan performa Amazon S3
Parameter berikut dapat disesuaikan untuk menyetel performa beban kerja Anda ketika menggunakan HBase di Amazon S3.
| Properti konfigurasi | Nilai default | Deskripsi |
|---|---|---|
|
|
8.192 |
Jumlah ruang disk, dalam MB, yang dicadangkan pada server wilayah penyimpanan instans Amazon EC2 dan volume EBS untuk BucketCache penyimpanan. Pengaturan ini berlaku untuk semua instans server wilayah. BucketCache Ukuran yang lebih besar umumnya sesuai dengan peningkatan kinerja |
|
|
134217728 |
Batas data, dalam byte, di mana memstore flush ke Amazon S3 dipicu. |
|
|
4 |
Pengganda yang menentukan batas MemStore atas di mana pembaruan diblokir. Jika MemStore melebihi di |
|
|
10 |
Jumlah maksimum StoreFiles yang dapat ada di toko sebelum pembaruan diblokir. |
|
|
10737418240 |
Ukuran maksimum wilayah sebelum dibagi. |
Mematikan dan memulihkan klaster tanpa kehilangan data
Untuk mematikan cluster Amazon EMR tanpa kehilangan data yang belum ditulis ke Amazon S3, Anda harus membersihkan MemStore cache Anda ke Amazon S3 untuk menulis file toko baru. Pertama, Anda harus menonaktifkan semua tabel. Konfigurasi langkah berikut dapat digunakan saat Anda menambahkan langkah ke klaster. Untuk informasi selengkapnya, lihat Bek erja dengan langkah-langkah menggunakan AWS CLI dan konsol di Panduan Manajemen Amazon EMR.
Name="Disable all tables",Jar="command-runner.jar",Args=["/bin/bash","/usr/lib/hbase/bin/disable_all_tables.sh"]
Atau, Anda dapat menjalankan perintah bash berikut secara langsung.
bash /usr/lib/hbase/bin/disable_all_tables.sh
Setelah menonaktifkan semua tabel, si hbase:meta ram tabel menggunakan shell HBase dan perintah berikut.
flush 'hbase:meta'
Kemudian, Anda dapat menjalankan skrip shell yang disediakan di cluster Amazon EMR untuk membersihkan MemStore cache. Anda dapat menambahkannya sebagai langkah atau menjalankannya langsung menggunakan on-cluster AWS CLI. Skrip menonaktifkan semua tabel HBase, yang menyebabkan server MemStore di setiap wilayah mengalir ke Amazon S3. Jika skrip sudah selesai, data akan tetap ada di Amazon S3 dan klaster dapat dihentikan.
Untuk memulai ulang cluster dengan data HBase yang sama, tentukan lokasi Amazon S3 yang sama dengan cluster sebelumnya baik di Konsol Manajemen AWS atau menggunakan properti hbase.rootdir konfigurasi.
