Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
Mengintegrasikan DynamoDB dengan Amazon Managed Streaming untuk Apache Kafka
Amazon Managed Streaming untuk Apache Kafka (Amazon MSK) memudahkan untuk menyerap dan memproses data streaming secara real time dengan layanan Apache Kafka yang dikelola sepenuhnya dan sangat tersedia.
Apache Kafka
Karena fitur-fitur ini, Apache Kafka sering digunakan untuk membangun pipeline data streaming real-time. Pipeline data secara andal memproses dan memindahkan data dari satu sistem ke sistem lain dan dapat menjadi bagian penting dari mengadopsi strategi database yang dibangun khusus dengan memfasilitasi penggunaan beberapa database yang masing-masing mendukung kasus penggunaan yang berbeda.
Amazon DynamoDB adalah target umum dalam pipeline data ini untuk mendukung aplikasi yang menggunakan nilai kunci atau model data dokumen dan menginginkan skalabilitas tanpa batas dengan kinerja milidetik satu digit yang konsisten.
Cara kerjanya
Integrasi antara Amazon MSK dan DynamoDB menggunakan fungsi Lambda untuk mengkonsumsi catatan dari Amazon MSK dan menuliskannya ke DynamoDB.

Lambda secara internal melakukan polling untuk pesan baru dari Amazon MSK dan kemudian secara serempak memanggil fungsi target Lambda. Muatan peristiwa fungsi Lambda berisi kumpulan pesan dari Amazon MSK. Untuk integrasi antara Amazon MSK dan DynamoDB, fungsi Lambda menulis pesan ini ke DynamoDB.
Menyiapkan integrasi antara Amazon MSK dan DynamoDB
catatan
Anda dapat mengunduh sumber daya yang digunakan dalam contoh ini di GitHub repositori berikut
Langkah-langkah di bawah ini menunjukkan cara mengatur integrasi sampel antara Amazon MSK dan Amazon DynamoDB. Contoh ini mewakili data yang dihasilkan oleh perangkat Internet of Things (IoT) dan dicerna ke Amazon MSK. Saat data dicerna ke Amazon MSK, data tersebut dapat diintegrasikan dengan layanan analitik atau alat pihak ketiga yang kompatibel dengan Apache Kafka, memungkinkan berbagai kasus penggunaan analitik. Mengintegrasikan DynamoDB juga menyediakan pencarian nilai kunci dari catatan perangkat individual.
Contoh ini akan menunjukkan bagaimana skrip Python menulis data sensor IoT ke Amazon MSK. Kemudian, fungsi Lambda menulis item dengan kunci partisi "deviceid" ke DynamoDB.
CloudFormation Template yang disediakan akan membuat sumber daya berikut: Bucket Amazon S3, Amazon VPC, cluster Amazon MSK, dan AWS CloudShell untuk pengujian operasi data.
Untuk menghasilkan data pengujian, buat topik Amazon MSK dan kemudian buat tabel DynamoDB. Anda dapat menggunakan Session Manager dari konsol manajemen untuk masuk ke CloudShell sistem operasi dan menjalankan skrip Python.
Setelah menjalankan CloudFormation template, Anda dapat menyelesaikan membangun arsitektur ini dengan melakukan operasi berikut.
-
Jalan CloudFormation kan template
S3bucket.yamluntuk membuat bucket S3. Untuk skrip atau operasi berikutnya, jalankan di Wilayah yang sama. MasukkanForMSKTestS3sebagai nama CloudFormation tumpukan.
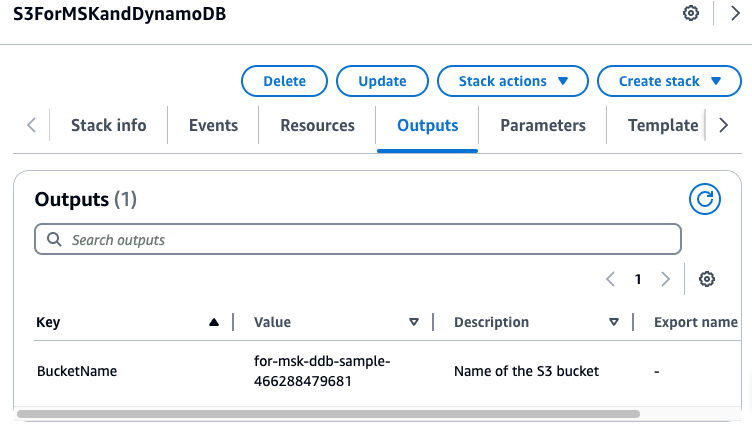
Setelah ini selesai, catat output nama bucket S3 di bawah Out put. Anda akan membutuhkan nama di Langkah 3.
-
Unggah file ZIP yang diunduh
fromMSK.zipke bucket S3 yang baru saja Anda buat.
-
Jalankan CloudFormation template
VPC.yamluntuk membuat VPC, cluster Amazon MSK, dan fungsi Lambda. Pada layar input parameter, masukkan nama bucket S3 yang Anda buat di Langkah 1 di mana ia meminta bucket S3. Atur nama CloudFormation tumpukan keForMSKTestVPC.
-
Siapkan lingkungan untuk menjalankan skrip Python di CloudShell. Anda dapat menggunakan CloudShell pada Konsol Manajemen AWS. Untuk informasi selengkapnya tentang penggunaan CloudShell, lihat Memulai dengan AWS CloudShell. Setelah memulai CloudShell, buat milik VPC CloudShell yang baru saja Anda buat untuk terhubung ke Amazon MSK Cluster. Buat CloudShell di subnet pribadi. Isi kolom berikut:
-
Nama - dapat diatur ke nama apa pun. Contohnya MSK-VPC
-
VPC - pilih MSKTest
-
Subnet - pilih Subnet Pri badi MSKTest (AZ1)
-
SecurityGroup- pilih ForMSKSecurityGroup


Setelah CloudShell milik Subnet Pribadi dimulai, jalankan perintah berikut:
pip install boto3 kafka-python aws-msk-iam-sasl-signer-python -
-
Unduh skrip Python dari bucket S3.
aws s3 cp s3://[YOUR-BUCKET-NAME]/pythonScripts.zip ./ unzip pythonScripts.zip -
Periksa konsol manajemen dan atur variabel lingkungan untuk URL broker dan nilai Wilayah dalam skrip Python. Periksa titik akhir broker cluster Amazon MSK di konsol manajemen.


-
Atur variabel lingkungan pada CloudShell. Jika Anda menggunakan AS Barat (Oregon):
export AWS_REGION="us-west-2" export MSK_BROKER="boot-YOURMSKCLUSTER.c3.kafka-serverless.ap-southeast-1.amazonaws.com:9098" -
Jalankan skrip Python berikut.
Buat topik Amazon MSK:
python ./createTopic.pyBuat tabel DynamoDB:
python ./createTable.pyTulis data tes ke topik Amazon MSK:
python ./kafkaDataGen.py -
Periksa CloudWatch metrik untuk sumber daya Amazon MSK, Lambda, dan DynamoDB yang dibuat, dan verifikasi data yang disimpan dalam
device_statustabel menggunakan DynamoDB Data Explorer untuk memastikan semua proses berjalan dengan benar. Jika setiap proses dijalankan tanpa kesalahan, Anda dapat memeriksa apakah data pengujian yang ditulis dari CloudShell Amazon MSK juga ditulis ke DynamoDB.
-
Setelah selesai dengan contoh ini, hapus sumber daya yang dibuat dalam tutorial ini. Hapus dua tum CloudFormation pukan:
ForMSKTestS3danForMSKTestVPC. Jika penghapusan tumpukan berhasil diselesaikan, semua sumber daya akan dihapus.
Langkah selanjutnya
catatan
Jika Anda membuat sumber daya sambil mengikuti contoh ini, harap ingat untuk menghapusnya untuk menghindari biaya tak terduga.
Integrasi mengidentifikasi arsitektur yang menghubungkan Amazon MSK dan DynamoDB untuk mengaktifkan data aliran untuk mendukung beban kerja OLTP. Dari sini, pencarian yang lebih kompleks dapat direalisasikan dengan menghubungkan DynamoDB dengan OpenSearch Layanan. Pertimbangkan EventBridge untuk mengintegrasikan dengan kebutuhan berbasis peristiwa yang lebih kompleks, dan ekstensi seperti Amazon Managed Service for Apache Flink untuk throughput yang lebih tinggi dan persyaratan latensi yang lebih rendah.
