Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Pages
Un document se compose d'une ou de plusieurs pages. Un objet de type Block PAGE existe pour chaque page du document. Un objet de PAGE bloc contient une liste des identifiants enfants pour les lignes de texte, les paires clé-valeur, les tables, les requêtes et les résultats des requêtes détectés sur la page du document.
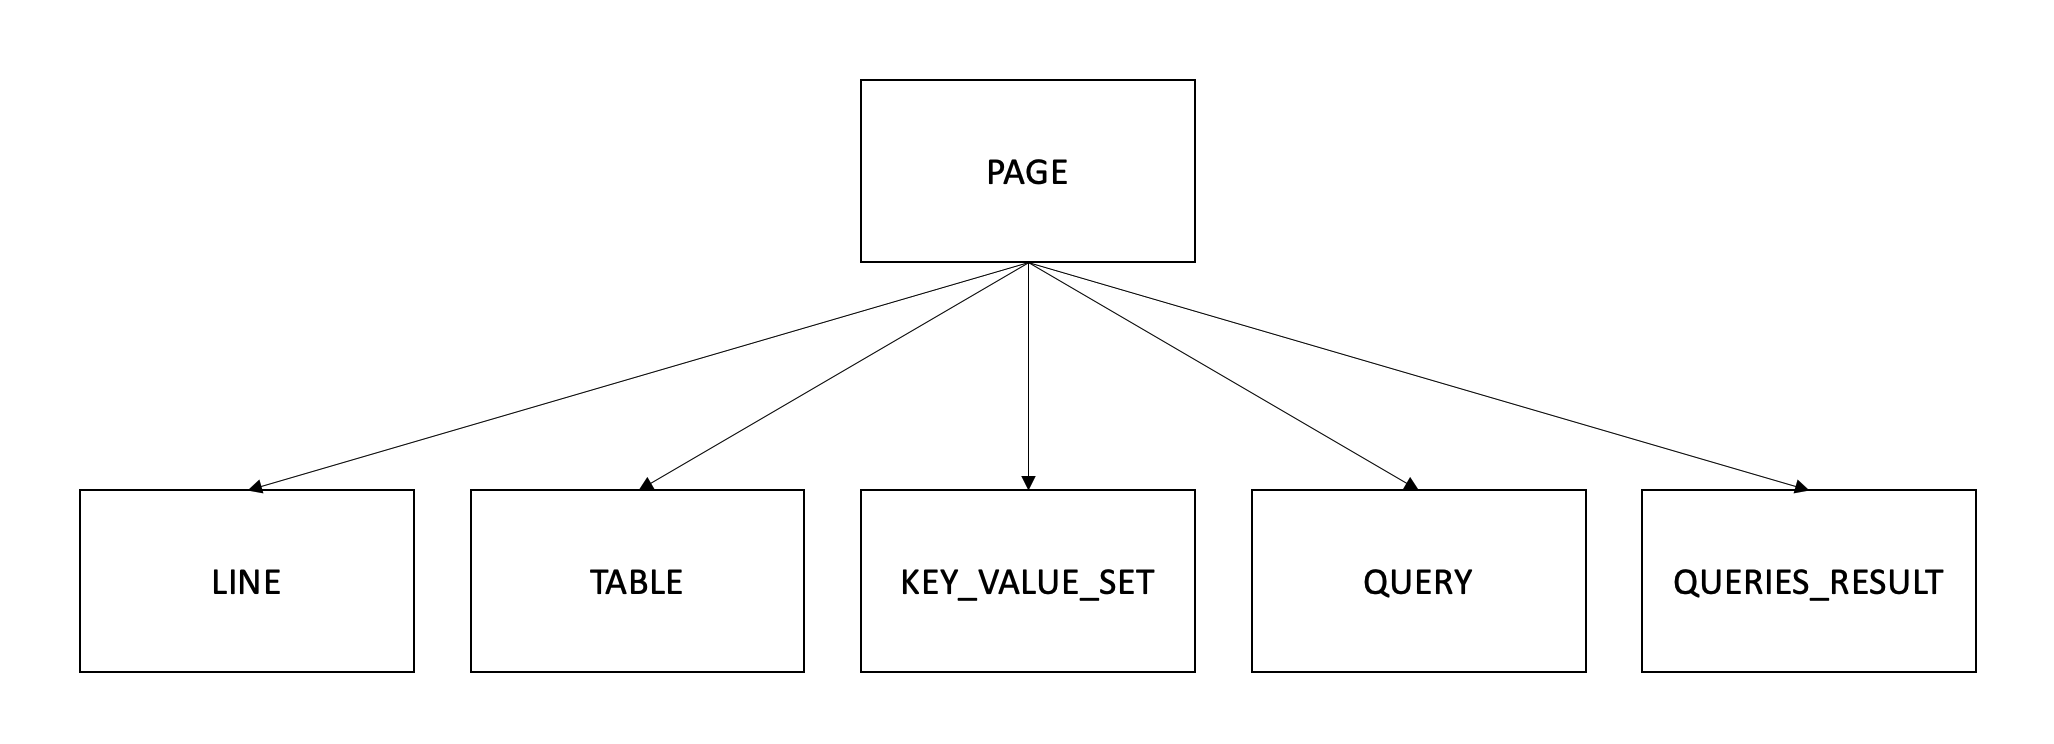
Le JSON d'un PAGE bloc ressemble à ce qui suit.
{

    "Geometry": ....
    "Relationships": [
        {
            "Type": "CHILD",
            "Ids": [
                "2602b0a6-20e3-4e6e-9e46-3be57fd0844b", // Line - Hello, world.
                "82aedd57-187f-43dd-9eb1-4f312ca30042", // Line - How are you?
                "52be1777-53f7-42f6-a7cf-6d09bdc15a30",
                "7ca7caa6-00ef-4cda-b1aa-5571dfed1a7c"
            ]
        }
    ],
    "BlockType": "PAGE",
    "Id": "8136b2dc-37c1-4300-a9da-6ed8b276ea97"  // Page identifier
},
Si vous utilisez des opérations asynchrones avec un document de plusieurs pages au format PDF, vous pouvez déterminer la page sur laquelle se trouve un bloc en inspectant le Page champ de l'objet. Block Une image numérisée (image au format JPEG, PNG, PDF ou TIFF) est considérée comme un document d'une seule page, même si l'image comporte plusieurs pages de document. Les opérations asynchrones renvoient toujours une Page valeur de 1 pour les images numérisées.
Le nombre total de pages est renvoyé dans le Pages champ deDocumentMetadata. DocumentMetadataest renvoyé avec chaque liste d'Blockobjets renvoyée par une opération Amazon Textract.
