Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Tableaux de streaming et diffusion S3 pour Amazon Kinesis Data Streams
Avec Amazon Kinesis Data Streams, vous pouvez diffuser des données en streaming depuis vos flux de données Kinesis vers deux types de destination : des tables de streaming sur Apache Iceberg (tables Amazon S3) ou des compartiments Amazon S3 à usage général. Vous n'avez pas besoin de gérer d'infrastructure et vous pouvez commencer à livrer en quelques minutes. Amazon Kinesis Data Streams lit les données de votre flux, met en mémoire tampon et agrège les enregistrements, puis les transmet à la destination que vous avez configurée. La livraison est entièrement gérée : il n'y a pas de connecteurs, d'applications grand public ou de ressources de calcul à provisionner.
Ces fonctionnalités sont prises en charge pour les flux s'exécutant en mode de capacité On-Demand Advantage ou On-Demand Standard. Vous configurez la diffusion depuis votre flux et vous spécifiez une destination. Amazon Kinesis Data Streams gère ensuite automatiquement la mise à l'échelle, les nouvelles tentatives et la fiabilité de la diffusion. La diffusion ne consomme pas le débit de lecture de votre flux et n'a aucun impact sur les consommateurs existants.
Rubriques
Comment fonctionne la diffusion des données
La diffusion de données connecte votre flux de données Kinesis à une destination de diffusion via un pipeline géré :
Vous publiez des données dans un flux de données Kinesis en On-Demand mode.
Vous appelez
CreateChannelle stream et vous spécifiez une destination (tables de streaming sur Apache Iceberg ou compartiment Amazon S3 à usage général).La diffusion lit le flux, met les enregistrements en mémoire tampon et les regroupe dans des fichiers de taille optimale.
La livraison écrit les fichiers vers la destination que vous avez configurée dans la fenêtre d'actualisation des données que vous spécifiez.
Destinations de livraison
La diffusion de données prend en charge deux types de destinations :
- Tableaux de streaming sur Apache Iceberg
-
Les tables de streaming transmettent en continu votre flux de données Kinesis dans les tables Apache Iceberg stockées dans Amazon S3 Tables. À mesure que les données arrivent, elles sont automatiquement converties au format optimisé Apache Parquet grâce à un compactage intelligent en ligne qui élimine le problème des petits fichiers et réduit les coûts des requêtes en aval. Quelques minutes après leur publication dans votre flux, les données peuvent être interrogées via Amazon Athena, Amazon EMR, Amazon Managed Service for Apache Flink ou tout autre moteur prenant en charge Apache Iceberg.
- Compartiments Amazon S3 à usage général
-
Amazon S3 Delivery écrit les données de streaming de votre flux de données Kinesis directement dans un compartiment S3. Les enregistrements sont fournis dans leur format source d'origine sans aucune transformation. Plusieurs enregistrements sont mis en mémoire tampon et regroupés en objets de taille optimale, avec une compression configurable et une structure de clé S3 que vous définissez via le modèle de clé de sortie. C'est la solution idéale pour les cas d'utilisation tels que l'archivage des journaux bruts, la rediffusion d'événements et le traitement par lots en aval, où vous avez besoin d'un stockage durable et peu coûteux de vos données de streaming sans les frais liés à la gestion d'un pipeline de diffusion.
Flux de données
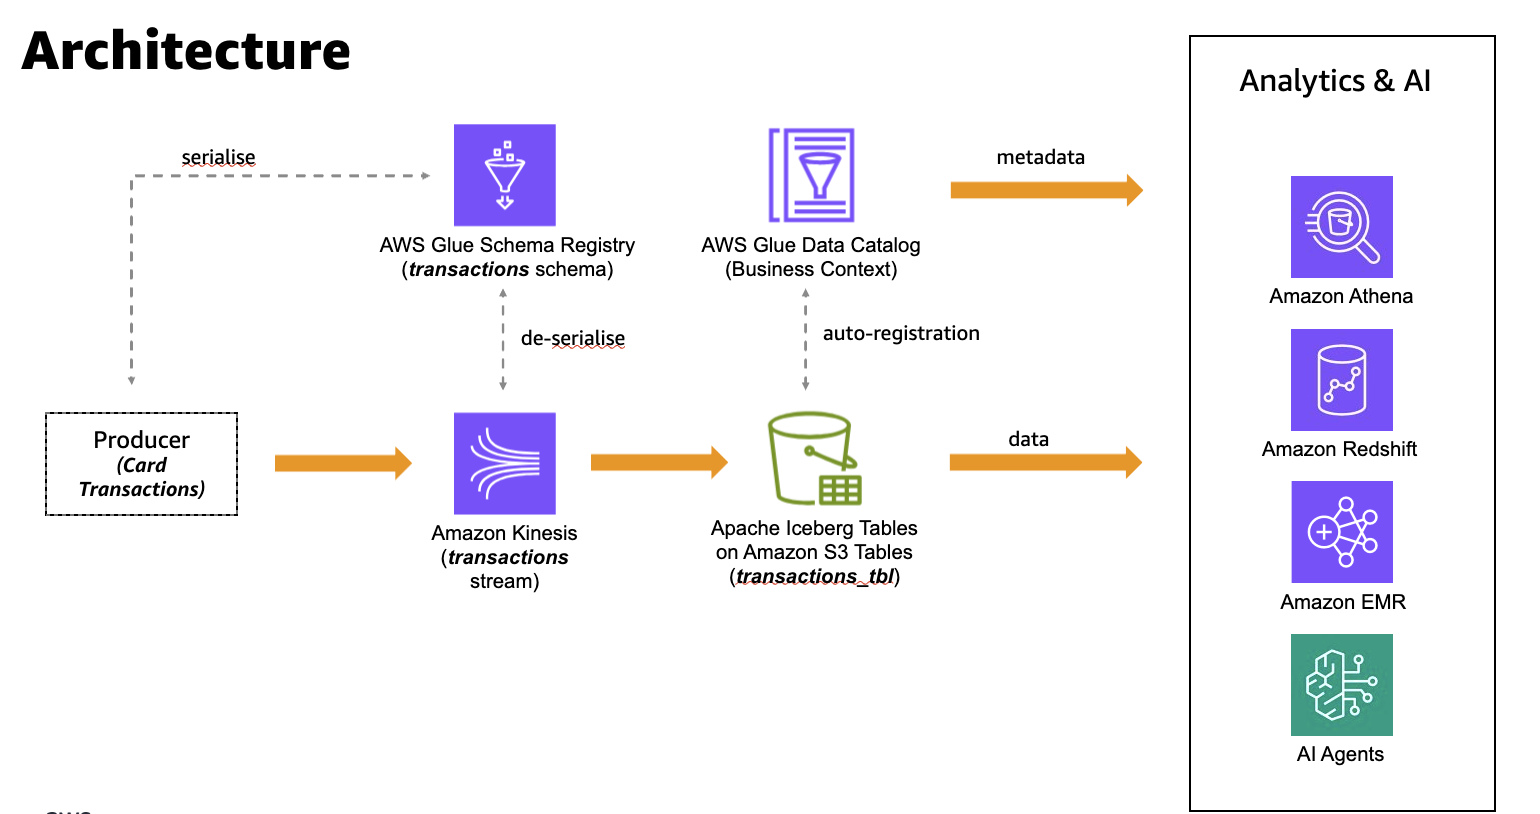
Le schéma suivant montre un flux de données de bout en bout à diffuser vers des tables de streaming sur Apache Iceberg. Le diagramme utilise un cas d'utilisation de transactions par carte à titre d'exemple. Un producteur sérialise les enregistrements en fonction d'un AWS Glue schéma dans Schema Registry et les écrit dans un flux de données Kinesis. Amazon Kinesis Data Streams transmet les enregistrements aux tables Apache Iceberg sur Amazon S3 Tables. Si vous activez l'intégration analytique dans les tables S3, les métadonnées des tables sont également enregistrées dans le catalogue de AWS Glue données ; cela ne se produit pas par défaut. Les données fournies et leurs métadonnées sont ensuite disponibles pour les moteurs d'analyse et d'IA tels qu'Amazon Athena, Amazon Redshift et Amazon EMR.
La livraison vers des compartiments Amazon S3 à usage général suit un flux similaire, à deux différences près. Un producteur écrit des enregistrements dans un flux de données Kinesis et Amazon Kinesis Data Streams les transmet à votre compartiment S3. Les enregistrements sont fournis dans leur format source d'origine sans conversion. Le registre des AWS Glue schémas n'est donc pas requis et aucune métadonnée de table n'est enregistrée dans le catalogue de AWS Glue données. Amazon Kinesis Data Streams met en mémoire tampon et regroupe les enregistrements dans des objets de taille optimale et les écrit à l'aide de la structure de clé S3 que vous définissez via le modèle de clé de sortie. Les objets livrés sont ensuite disponibles pour le traitement par lots et l'analyse en aval.
Capacités clés
Mise à l'échelle automatique sans serveur : évolue automatiquement en fonction du débit de votre flux, jusqu'à la capacité de débit du flux. Aucune ressource de calcul à provisionner.
Exactly-once livraison par fragment — Les enregistrements d'un fragment sont livrés à la destination une seule fois, sans doublons ni omissions dans le fragment.
Diffusion en temps quasi réel — Actualisation des données configurable de 5 à 15 minutes (300 à 900 secondes).
Conversion automatique de Parquet : pour les tableaux de streaming sur Apache Iceberg, convertit les enregistrements de streaming au format Apache Parquet optimisé pour des requêtes analytiques efficaces.
Compactage en ligne : regroupe les enregistrements dans des fichiers de taille optimale pour les performances des requêtes d'analyse.
Chiffrement : prend en charge AWS KMS les clés gérées par le client pour le chiffrement côté serveur sur le lieu de destination. Clé gérée par AWS (l'
aws/kinesisalias) n'est pas pris en charge pour le chiffrement de destination.Dead-letter file d'attente : les métadonnées d'échec pour les enregistrements qui ne peuvent pas être livrés, notamment l'ARN du flux, l'ID de partition, le numéro de séquence et le contexte de l'erreur, sont écrites dans une file d'attente de S3-based lettres mortes.
CloudWatch métriques et journaux : surveillez le nombre d'octets transmis, le nombre d'enregistrements et la fraîcheur des données grâce à Amazon CloudWatch Metrics. Activez la journalisation des livraisons dans Amazon CloudWatch Logs pour saisir les détails des lots de livraison, les échecs et le contexte des erreurs à des fins de dépannage.
Aucun impact sur les autres consommateurs — Ne consomme pas de créneaux de diffusion améliorés ni de débit partagé.
Exigences
Votre flux de données Kinesis doit utiliser le mode de capacité On-Demand Standard ou On-Demand Advantage.
Vous devez créer un rôle d'exécution de service IAM qui accorde les autorisations de diffusion nécessaires pour écrire vers votre destination.
Votre compartiment de destination ou votre compartiment de table doit se trouver dans la même région que votre flux de données Kinesis. La diffusion des données ne prend pas en charge la diffusion interrégionale pour les deux types de destination.
Pour les tables de streaming sur Apache Iceberg, la diffusion entre comptes n'est pas prise en charge. Le flux source, le compartiment de table S3 de destination et le AWS Glue Schema Registry doivent tous se Compte AWS trouver dans la même région.
Pour les compartiments Amazon S3 à usage général, la livraison entre comptes est prise en charge uniquement pour le compartiment de destination. Le canal et son flux source doivent être dans le même compte Compte AWS ; seul le compartiment de destination peut se trouver dans un compte différent.
Pour les tables de streaming sur Apache Iceberg, vous devez configurer une file d'attente de lettres mortes dans Amazon S3.
