Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Configuration d'une cible pour une intégration Zéro-ETL
Plusieurs options sont proposées AWS Glue lors de la configuration d'une cible pour une intégration Zéro-ETL. La cible peut être un entrepôt de Amazon Redshift données chiffré ou une architecture Lakehouse d'Amazon. SageMaker
Avant de sélectionner la cible pour l’intégration zéro ETL, vous devez configurer l’une des ressources cible suivantes. Les options de configuration pour une cible dans une intégration zéro ETL sont les suivantes :
Un compartiment Amazon S3 à usage général utilisant l'architecture Lakehouse d'Amazon. SageMaker Consultez Configuration d'une cible de compartiment S3 à usage général.
Un compartiment Amazon S3 Tables utilisant l'architecture Lakehouse d'Amazon. SageMaker Consultez Configuration d'une cible de compartiment Amazon S3 Tables.
Un stockage Amazon Redshift géré utilisant l'architecture Lakehouse d'Amazon. SageMaker Consultez Configuration d'un Amazon Redshift Cible de stockage géré.
Un entrepôt Amazon Redshift de données identifié par un espace de noms Redshift. Consultez Configuration d'un Amazon Redshift cible de l'entrepôt de données.
Note
Vous ne pouvez pas modifier la cible d’une intégration zéro ETL après sa création.
Configuration d'une cible de compartiment S3 à usage général
Cette section décrit les prérequis et les étapes de configuration pour configurer un compartiment S3 à usage général comme espace de stockage pour votre cible dans le cadre d'une intégration Zero-ETL, en utilisant l'architecture Lakehouse d'Amazon. SageMaker
Avant de créer une intégration Zero-ETL avec l'architecture Lakehouse d'Amazon à l' SageMaker aide d'un stockage S3 à usage général, vous devez effectuer les tâches de configuration suivantes :
Configuration d'une AWS Glue base de données
Fournir une politique RBAC du catalogue
Créer un rôle IAM cible
Associer le rôle cible, KMS (facultatif) et Connection (facultatif) à la ressource cible
(Facultatif) Configurer les propriétés de la table cible
Configuration d'un AWS Glue database
Pour configurer une base de données cible dans le catalogue de données avec un emplacement de compartiment à usage général Amazon S3 :
Sur la page d'accueil de la AWS Glue console, sélectionnez Base de données sous Catalogue de données.
Choisissez Ajouter une base de données en haut à droite. Si vous avez déjà créé une base de données, assurez-vous que l’emplacement avec l’URI Amazon S3 est défini pour la base de données.
Saisissez un nom et un emplacement (URI Amazon S3). Notez que l’emplacement est requis pour l’intégration zéro ETL. Cliquez sur Créer une base de données lorsque vous avez terminé.
Note
Le compartiment Amazon S3 à usage général doit se trouver dans la même région que la AWS Glue base de données.
Pour plus d'informations sur la création d'une nouvelle base de données dans AWS Glue, voir Démarrage avec le catalogue de données.
Vous pouvez également utiliser la commande CLI create-database pour créer la base de données dans AWS Glue. Notez que le LocationUri dans --database-input est obligatoire.
Optimisation des tables Iceberg
Une fois qu'une table est créée AWS Glue dans la base de données cible, vous pouvez activer le compactage pour accélérer les requêtes dans Amazon Athena. Pour plus d’informations sur la configuration des ressources (rôle IAM) pour le compactage, consultez Conditions préalables requises pour l’optimisation des tables.
Pour plus d'informations sur la configuration du compactage sur la AWS Glue table créée par l'intégration, consultez Optimisation des tables Iceberg.
Fourniture d’une politique d’accès basée sur les ressources (RBAC) du catalogue
Pour les intégrations qui utilisent une AWS Glue base de données, ajoutez les autorisations suivantes à la politique RBAC du catalogue afin de permettre les intégrations entre la source et la cible.
Note
Pour les intégrations entre comptes, l'utilisateur qui crée la politique de rôle d'intégration et la politique de ressources du catalogue doivent autoriser l'accès à glue:CreateInboundIntegration la ressource. Pour un même compte, une politique de ressources ou une politique de rôle autorisant glue:CreateInboundIntegration sur la ressource est suffisante. Les deux scénarios doivent toujours autoriser glue.amazonaws.com pour glue:AuthorizeInboundIntegration.
Vous pouvez accéder aux paramètres du catalogue sous Catalogue de données. Indiquez ensuite les autorisations suivantes et complétez les informations manquantes.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Principal": {
        "AWS": [
            "arn:aws:iam::123456789012:user/Alice"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:CreateInboundIntegration"
      ],
      "Resource": [
          "arn:aws:glue:us-east-1:111122223333:catalog",
          "arn:aws:glue:us-east-1:111122223333:database/database-name"
      ],
      "Condition": {
        "StringLike": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    },
    {
      "Principal": {
        "Service": [
          "glue.amazonaws.com"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:AuthorizeInboundIntegration"
      ],
      "Resource": [
          "arn:aws:glue:us-east-1:111122223333:catalog",
          "arn:aws:glue:us-east-1:111122223333:database/database-name"
      ],
      "Condition": {
        "StringEquals": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    }
  ]
}
Création d’un rôle IAM cible
Créez un rôle IAM cible avec les autorisations et les relations d’approbation suivantes :
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Action": "s3:ListBucket",
            "Resource": "arn:aws:s3:::amzn-s3-bucket",
            "Effect": "Allow"
        },
        {
            "Action": [
                "s3:GetObject",
                "s3:PutObject",
                "s3:DeleteObject"
            ],
            "Resource": "arn:aws:s3:::amzn-s3-demo-bucket/prefix/*",
            "Effect": "Allow"
        },
        {
            "Action": [
                "glue:GetDatabase"
            ],
            "Resource": [
                "arn:aws:glue:us-east-1:111122223333:catalog",
                "arn:aws:glue:us-east-1:111122223333:database/database-name"
            ],
            "Effect": "Allow"
        },
        {
            "Action": [
                "glue:CreateTable",
                "glue:GetTable",
                "glue:GetTables",
                "glue:DeleteTable",
                "glue:UpdateTable",
                "glue:GetTableVersion",
                "glue:GetTableVersions",
                "glue:GetResourcePolicy"
            ],
            "Resource": [
                "arn:aws:glue:us-east-1:111122223333:catalog",
                "arn:aws:glue:us-east-1:111122223333:database/database-name",
                "arn:aws:glue:us-east-1:111122223333:table/database-name/*"
            ],
            "Effect": "Allow"
        },
        {
            "Action": [
                "cloudwatch:PutMetricData"
            ],
            "Resource": "*",
            "Condition": {
                "StringEquals": {
                    "cloudwatch:namespace": "AWS/Glue/ZeroETL"
                }
            },
            "Effect": "Allow"
        },
        {
            "Action": [
                "logs:CreateLogGroup",
                "logs:CreateLogStream",
                "logs:PutLogEvents"
            ],
            "Resource": "*",
            "Effect": "Allow"
        }
    ]
}
Ajoutez la politique de confiance suivante pour permettre au AWS Glue service d'assumer ce rôle :
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "glue.amazonaws.com"
      },
      "Action": "sts:AssumeRole"
    }
  ]
}
Associer le rôle cible, KMS (facultatif) et Connection (facultatif) à la ressource cible
Associez le rôle cible ci-dessus à la ressource cible, c'est-à-dire à la AWS Glue base de données. Facultativement, le KMS pour chiffrer les données avant de les stocker dans la table iceberg cible et l'ARN de connexion pour accéder au compartiment S3 peuvent être configurés pour la base de données cible AWS Glue . Cela permettra d'accéder AWS Glue aux données de l'emplacement S3 cible à l'aide du rôle fourni et de les chiffrer éventuellement à l'aide de la clé KMS fournie. Si le compartiment S3 cible est configuré pour être accessible via un certain VPC, l'ARN de connexion peut être associé pour permettre d'exécuter le traitement AWS Glue au sein de ce VPC. Pour plus d'informations sur la configuration d'un VPC, consultez Créer un VPC.
Ou à l'aide de la AWS Glue CLI/API :
aws glue create-integration-resource-property \ --resource-arn arn:aws:glue:us-east-1:123456789012:database/database-name\ --target-processing-properties '{"RoleArn": "arn:aws:iam::123456789012:role/gmi_target_role"}' \ --region us-east-1
(Facultatif) Configurer les propriétés de la table cible
Facultativement, les propriétés de la table cible peuvent être configurées pour les tables cibles qui vont être synchronisées avec la cible.
Vous pouvez configurer ces paramètres dans la section Paramètres de sortie du flux de création d'intégration de la AWS Glue console :

Lorsque vous sélectionnez Spécifier les clés de partition personnalisées, vous pouvez configurer les clés de partition ainsi que leur fonction et leurs spécifications de conversion :

Si la source et la cible se trouvent dans le même compte, cette configuration peut être effectuée dans le cadre du flux de création d'intégration depuis l'interface utilisateur de la AWS Glue console. Mais si la cible se trouve dans un compte différent, cette configuration doit être complète avant de créer l'intégration. Lorsque vous utilisez la CLI ou l'API, cela doit être fait avant d'appeler l' Create-Integration API, même lorsque la source et la cible se trouvent dans le même compte. AWS Glue L'interface utilisateur de la console encapsule simplement cet appel d'API pour le même scénario de compte.
Si cela n'est pas configuré, les valeurs par défaut seront utilisées lors de la synchronisation de la table. Cette configuration peut également être modifiée à tout moment après la création de l'intégration.
Note
Si cette propriété est mise à jour après la création de l'intégration, elle peut déclencher une resynchronisation complète de la table lorsque la configuration mise à jour entre en conflit avec la configuration existante. Par exemple, mettre à jour la table « Unnesting » de « No-Unnest » à « Full-Unnest », ou modifier la colonne de partition.
Conflits de propriétés de la table cible
Deux éléments permettent d'identifier un ensemble de propriétés de table cible : l'ARN de la ressource cible et le nom de la table source. La ressource cible est la AWS Glue base de données d'une cible Amazon S3 à usage général. Pour une cible Amazon S3 Tables, il s'agit du catalogue Amazon S3 Tables. Chaque combinaison de ressource cible et de table source ne peut être associée qu'à une seule intégration à la fois. Par conséquent, deux intégrations ne peuvent pas écrire la même table source sur la même ressource cible. Si vous créez une deuxième intégration pour la même combinaison, AWS Glue identifiez le conflit et évitez-le. Cela empêche une intégration de remplacer les données d'une autre intégration.
AWS Glue applique cette règle que vous utilisiez la console, la CLI ou l'API. Dans la console, l'étape Paramètres de sortie détecte les conflits avant de continuer, afin que vous puissiez les résoudre avant de créer l'intégration. Cela s'applique aux sources à table unique telles qu'Amazon DynamoDB et aux sources à tables multiples telles que les applications SaaS. Les propriétés cibles d'une table source ne peuvent appartenir qu'à une seule intégration. Ainsi, une table source déjà revendiquée par une autre intégration ne sera pas répliquée par la vôtre tant que vous n'aurez pas résolu le conflit.
La manière dont la console affiche un conflit dépend du nombre de tables sources :
Pour les sources multitables, la console affiche l'état de chaque table source dans deux colonnes : Action requise et Remarques. Ces colonnes indiquent les tableaux qui nécessitent une attention particulière.
Pour les sources à table unique, la console affiche les mêmes informations dans une alerte intégrée. Il n'existe qu'une seule table source.
La capture d'écran suivante montre le tableau des paramètres de sortie multi-tables (SaaS) avec les colonnes Action requise et Notes.

La console affiche le message dans la colonne Notes pour les sources à tables multiples, ou dans l'alerte en ligne pour les sources à table unique. Il signale une table source lorsque l'une des conditions suivantes s'applique :
Une autre intégration écrit déjà la table source dans la ressource cible sélectionnée. Choisissez une autre ressource cible ou supprimez la table source de l'autre intégration.
Le nom de la table de sortie est déjà enregistré sur la ressource cible sélectionnée pour une autre table source. Entrez un autre nom de table de sortie.
Au moins deux tables sources correspondent au même nom de table en sortie. Cela s'applique aux sources SaaS multitables. Donnez à chaque table source son propre nom de table de sortie.
Le nom de la table de sortie n'est pas valide. Entrez un nom valide contenant uniquement des lettres minuscules, des chiffres et des traits de soulignement, et contenant 255 caractères ou moins. Pour les cibles du catalogue Amazon S3 Tables, le nom ne peut pas commencer par un trait de soulignement.
AWS Glue détecte une modification simultanée des paramètres de sortie.
Les modifications simultanées ne sont pas bloquantes
Une modification simultanée signifie qu'un autre utilisateur a mis à jour les mêmes paramètres de sortie pendant que vous travailliez. Contrairement aux autres conditions de cette liste, une modification simultanée ne vous bloque pas. Actualisez pour obtenir les derniers paramètres, ou continuez avec les paramètres actuels.
En utilisant la CLI ou l'API :
aws glue create-integration-table-properties \ --resource-arn arn:aws:glue:us-east-1:123456789012:database/database-name\ --table-nametable-name\ --target-table-config '{ "UnnestSpec":"TOPLEVEL"|"FULL"|"NOUNNEST", "PartitionSpec": [ { "FieldName":"string", "FunctionSpec":"string", "ConversionSpec":"string"} ... ], "TargetTableName":"string" }' \ --region us-east-1
Après avoir configuré l'architecture Lakehouse d'Amazon SageMaker avec le stockage par compartiments Amazon S3 à usage général, vous pouvez terminer la configuration Configuration de l’intégration avec votre cible de l'intégration.
Configuration d'une cible de compartiment Amazon S3 Tables
Cette section décrit les prérequis et les étapes de configuration pour configurer Amazon S3 Tables en tant que cible pour votre intégration Zero-ETL, en utilisant l'architecture Lakehouse d'Amazon. SageMaker
Avant de créer une intégration zéro ETL avec des tableaux Amazon S3 comme cibles, vous devez effectuer les tâches de configuration suivantes :
Configuration du compartiment de tables Amazon S3 (et intégration des services d'analyse)
Fournir une politique RBAC du catalogue
Créer un rôle IAM cible
Associer le rôle cible, KMS (facultatif) et Connection (facultatif) à la ressource cible
(Facultatif) Configurer les propriétés de la table cible
Configuration du compartiment de tables Amazon S3 (avec intégration des services d'analyse)
Créez un compartiment de tableaux S3 dans votre compte en suivant les instructions de la section Getting started with Amazon S3 Tables.
Activez les intégrations d'Analytics avec votre S3-Table compartiment en suivant ces instructions : Intégration de AWS services à Amazon S3 Tables.
Cela créera un nouveau S3-Table catalogue dans AWS Lake Formation.
Fourniture d’une politique RBAC du catalogue
Les autorisations suivantes doivent être ajoutées à la politique RBAC du catalogue pour permettre les intégrations entre la source et la cible du catalogue des tableaux Amazon S3.
La politique relative aux ressources du AWS Glue catalogue cible doit inclure les autorisations de AWS Glue service pourAuthorizeInboundIntegration. En outre, une CreateInboundIntegration autorisation est requise soit sur le principal source qui crée l'intégration, soit dans la politique de AWS Glue ressource cible.
Note
Dans le cas d'un scénario multicompte, la politique de ressources du AWS Glue catalogue source principale et cible doit inclure des glue:CreateInboundIntegration autorisations sur la ressource.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Principal": {
        "AWS": [
            "arn:aws:iam::123456789012:user/Alice"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:CreateInboundIntegration"
      ],
      "Resource": [
          "arn:aws:glue:us-east-1:111122223333:catalog/s3tablescatalog/*"
      ],
      "Condition": {
        "StringLike": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    },
    {
      "Principal": {
        "Service": [
          "glue.amazonaws.com"
        ]
      },
      "Effect": "Allow",
      "Action": [
        "glue:AuthorizeInboundIntegration"
      ],
      "Resource": [
      "arn:aws:glue:us-east-1:111122223333:catalog/s3tablescatalog/*"
      ],
      "Condition": {
        "StringEquals": {
        "aws:SourceArn": "arn:aws:dynamodb:us-east-1:444455556666:table/table-name"
        }
      }
    }
  ]
}
Note
Remplacez-le s3tablescatalogs3tablescatalog.
Création d’un rôle IAM cible
Créez un rôle IAM cible avec les autorisations et les relations d’approbation suivantes :
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Action": [
        "s3tables:ListTableBuckets",
        "s3tables:GetTableBucket",
        "s3tables:GetTableBucketEncryption",
        "s3tables:GetNamespace",
        "s3tables:CreateNamespace",
        "s3tables:ListNamespaces",
        "s3tables:CreateTable",
        "s3tables:DeleteTable",
        "s3tables:GetTable",
        "s3tables:GetTableEncryption",
        "s3tables:ListTables",
        "s3tables:GetTableMetadataLocation",
        "s3tables:UpdateTableMetadataLocation",
        "s3tables:GetTableData",
        "s3tables:PutTableData"
      ],
      "Resource": "arn:aws:s3tables:us-east-1:111122223333:bucket/s3-table-bucket",
      "Effect": "Allow"
    },
    {
      "Action": [
        "cloudwatch:PutMetricData"
      ],
      "Resource": "*",
      "Condition": {
        "StringEquals": {
          "cloudwatch:namespace": "AWS/Glue/ZeroETL"
        }
      },
      "Effect": "Allow"
    },
    {
      "Action": [
        "logs:CreateLogGroup",
        "logs:CreateLogStream",
        "logs:PutLogEvents"
      ],
      "Resource": "*",
      "Effect": "Allow"
    }
  ]
}
Ajoutez la politique de confiance suivante au rôle IAM cible pour permettre au AWS Glue Service de l'assumer :
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "glue.amazonaws.com"
      },
      "Action": "sts:AssumeRole"
    }
  ]
}
Note
Assurez-vous qu'il n'existe aucune instruction DENY explicite pour ce rôle IAM cible dans la politique de ressources du S3-Tables bucket. Une instruction DENY explicite remplacerait toutes les autorisations ALLOW et empêcherait l’intégration de fonctionner correctement.
Associer le rôle cible, KMS (facultatif) et Connection (facultatif) à la ressource cible
Associez le rôle cible ci-dessus à la ressource cible. Facultativement, le KMS pour chiffrer les données avant de les stocker dans la table iceberg cible et l'ARN de connexion pour accéder au compartiment S3 cible peuvent être configurés. Si le compartiment S3 cible est configuré pour être accessible via un certain VPC, l'ARN de connexion peut être associé pour permettre d'exécuter le traitement AWS Glue au sein de ce VPC. Pour plus d'informations sur la configuration d'un VPC, consultez Créer un VPC.
À l'aide de la AWS Glue CLI/de l'API :
aws glue create-integration-resource-property \ --resource-arn arn:aws:glue:us-east-1:123456789012:catalog/s3tablescatalog/S3 table bucket name\ --target-processing-properties '{ "RoleArn": "arn:aws:iam::123456789012:role/target_role" }' \ --region us-east-1
(Facultatif) Configurer les propriétés de la table cible
Facultativement, les propriétés de la table cible peuvent être configurées pour les tables cibles qui vont être synchronisées avec la cible. Les mêmes règles s'appliquent que celles décrites dans la section cible S3 à usage général. Pour la liste complète des situations de conflit, voirConflits de propriétés de la table cible.
En utilisant la CLI ou l'API :
aws glue create-integration-table-properties \ --resource-arn arn:aws:glue:us-east-1:123456789012:catalog/s3tablescatalog/S3 table bucket name\ --table-nametable-name\ --target-table-config '' \ --region us-east-1
Après avoir configuré le S3-Tables stockage Amazon à l'aide de l'architecture Lakehouse d'Amazon SageMaker, vous pouvez terminer la configuration Configuration de l’intégration avec votre cible de l'intégration.
Configuration d'un Amazon Redshift Cible de stockage géré
Cette section décrit les prérequis et les étapes de configuration pour configurer un stockage Amazon Redshift géré (RMS) en tant que cible pour votre intégration Zero-ETL, à l'aide de l'architecture Lakehouse d'Amazon. SageMaker
Avant de créer une intégration Zero-ETL avec une architecture Lakehouse d'Amazon à l' SageMaker aide du stockage géré Redshift, vous devez effectuer les tâches de configuration suivantes :
Configurer un Amazon Redshift cluster ou un groupe de travail sans serveur
Enregistrez l' Amazon Redshift intégration avec Lake Formation
Créer un catalogue géré dans Lake Formation
Configuration des autorisations IAM
Configuration Amazon Redshift stockage géré
Pour configurer le stockage Amazon Redshift géré pour votre intégration Zero-ETL, procédez comme suit :
Créez ou utilisez un Amazon Redshift cluster ou un groupe de travail sans serveur existant. Assurez-vous que le
enable_case_sensitive_identifierparamètre du Amazon Redshift groupe de travail ou du cluster cible est activé pour que l'intégration soit réussie. Pour plus d'informations sur l'activation de la sensibilité majuscules/minuscules, voir Activer la sensibilité majuscules/minuscules pour votre entrepôt de données dans le guide Amazon Redshift de gestion.Enregistrez une intégration de Redshift dans le catalogue dans AWS Lake Formation. Consultez la section Enregistrement de Amazon Redshift clusters et d'espaces de noms dans le catalogue de données.
Créez un catalogue fédéré ou géré dans. AWS Lake Formation Pour en savoir plus, consultez :
Configurez les autorisations IAM pour le rôle cible. Le rôle a besoin d’autorisations pour accéder aux ressources Redshift et Lake Formation. Au minimum, le rôle doit disposer des éléments suivants :
Autorisations d’accès au cluster Redshift ou au groupe de travail
Autorisations d’accès au catalogue Lake Formation
Autorisations de création et de gestion de tableaux dans le catalogue
CloudWatch et CloudWatch enregistre les autorisations pour la surveillance
Après avoir configuré le catalogue Amazon SageMaker Lakehouse avec le stockage Amazon Redshift géré, vous pouvez terminer la configuration Configuration de l’intégration avec votre cible de l'intégration.
Configuration d'un Amazon Redshift cible de l'entrepôt de données
Cette section décrit les prérequis et les étapes de configuration pour configurer un entrepôt de Amazon Redshift données en tant que cible pour votre intégration Zero-ETL.
Avant de créer une intégration Zero-ETL avec une cible d'entrepôt de Amazon Redshift données, vous devez effectuer les tâches de configuration suivantes :
Configurer un Amazon Redshift cluster ou un groupe de travail sans serveur
Configurer la sensibilité à la casse
Configuration des autorisations IAM
Configuration du Amazon Redshift entrepôt des données
Pour configurer un entrepôt de Amazon Redshift données pour votre intégration Zero-ETL, procédez comme suit :
Accédez à la console Amazon Redshift
et cliquez sur Créer un cluster ou utilisez un cluster existant. Pour créer un Amazon Redshift cluster, voir Création d'un cluster. Pour Amazon Redshift sans serveur, cliquez sur Créer un groupe de travail. Pour créer un groupe de travail Amazon Redshift sans serveur, voir Création d’un groupe de travail avec un espace de noms. Si vous créez un cluster, choisissez une taille de cluster appropriée et assurez-vous que votre cluster est chiffré. Pour le sans serveur, configurez les paramètres de groupe de travail en fonction de vos besoins.
Assurez-vous que le
enable_case_sensitive_identifierparamètre du Amazon Redshift groupe de travail ou du cluster cible est activé pour que l'intégration soit réussie. Pour plus d’informations sur l’activation de la sensibilité à la casse, consultez Activation de la sensibilité à la casse pour votre entrepôt de données dans le Guide de la gestion Amazon Redshift.Configurez les autorisations IAM pour permettre à l'intégration Zero-ETL d'accéder à votre entrepôt de Amazon Redshift données. Vous devrez créer un rôle IAM avec les autorisations suivantes :
Autorisations d'accès au Amazon Redshift cluster ou au groupe de travail
Autorisations pour créer et gérer des bases de données et des tables dans Amazon Redshift
CloudWatch et CloudWatch enregistre les autorisations pour la surveillance
Une fois la configuration du Amazon Redshift groupe de travail ou du cluster terminée, vous devez configurer votre entrepôt de données pour des intégrations sans ETL. Pour plus d’informations, reportez-vous à Démarrer avec les intégrations zéro ETL dans le Guide de gestion Amazon Redshift.
Note
Lorsque vous utilisez un entrepôt de Amazon Redshift données comme cible, l'intégration crée un schéma dans la base de données spécifiée pour stocker les données répliquées. Le nom du schéma provient du nom de l’intégration.
Note
Le enable_case_sensitive_identifier paramètre du Amazon Redshift groupe de travail ou du cluster cible doit être activé pour que l'intégration soit réussie.
Après avoir configuré l'entrepôt de Amazon Redshift données, vous pouvez Configuration de l’intégration avec votre cible terminer la configuration de l'intégration.
Configuration de l’intégration avec votre cible
Après avoir configuré les ressources source et cible, procédez comme suit pour terminer la configuration de l'intégration :
Accédez à la page « Zero-ETL intégrations » et lancez le flux de création d'intégration.
Sélectionnez la ressource source configurée lors des étapes précédentes.
Sélectionnez ou spécifiez la ressource cible (même compte ou compte croisé) configurée lors des étapes précédentes.
Sélectionnez le rôle IAM cible configuré précédemment.
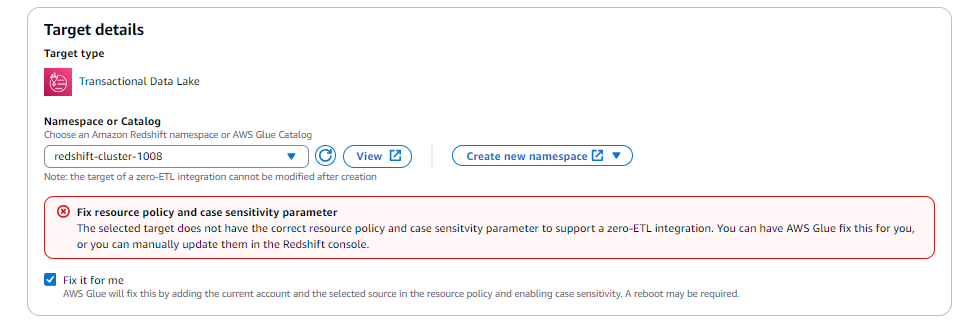
Sélectionnez l'option Réparer le problème pour moi (disponible uniquement lorsque la cible possède le même compte).
Pour la cible Amazon S3 (AWS Glue base de données) et S3-Table (catalogue) standard, cela permettra de :
Appliquez un principal de service autorisé à la politique de ressources du catalogue cible.
Appliquez un ARN principal AWS Glue source autorisé à la politique de ressources du catalogue cible.
Pour la Amazon Redshift cible, cela permettra de :
Appliquez un principal de service autorisé sur le Amazon Redshift cluster ou le groupe de travail sans serveur.
Appliquez un ARN AWS Glue source autorisé au Amazon Redshift cluster ou au groupe de travail sans serveur.
Associer un nouveau groupe de paramètres à
enable_case_sensitive_identifier = true.
Pour créer l'intégration via une API ou une interface de ligne de commande, procédez comme suit : CreateIntegration API.
