Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Optimisation des coûts - Mise en réseau
L'architecture des systèmes pour une haute disponibilité (HA) est une bonne pratique pour atteindre la résilience et la tolérance aux pannes. En pratique, cela signifie répartir vos charges de travail et l'infrastructure sous-jacente sur plusieurs zones de disponibilité (AZ) au sein d'une région AWS donnée. La mise en place de ces caractéristiques dans votre environnement Amazon EKS améliorera la fiabilité globale de votre système. Parallèlement, vos environnements EKS seront probablement également composés d'une variété de constructions (c'est-à-dire des VPC), de composants (c'est-à-dire des ELB) et d'intégrations (c'est-à-dire des ECR et d'autres registres de conteneurs).
La combinaison de systèmes hautement disponibles et d'autres composants spécifiques aux cas d'utilisation peut jouer un rôle important dans la manière dont les données sont transférées et traitées. Cela aura à son tour un impact sur les coûts liés au transfert et au traitement des données.
Les pratiques détaillées ci-dessous vous aideront à concevoir et à optimiser vos environnements EKS afin d'atteindre la rentabilité dans différents domaines et cas d'utilisation.
Communication d'un module à l'autre
Selon votre configuration, la communication réseau et le transfert de données entre Pods peuvent avoir un impact significatif sur le coût global de l'exécution des charges de travail Amazon EKS. Cette section abordera différents concepts et approches visant à atténuer les coûts liés à la communication entre les pods, tout en tenant compte des architectures à haute disponibilité (HA), des performances des applications et de la résilience.
Restreindre le trafic vers une zone de disponibilité
Le projet Kubernetes a commencé très tôt à développer des constructions tenant compte de la topologie, notamment des étiquettes telles que kubernetes. io/hostname, topologie.kubernetes. io/regionet topology.kubernetes. io/zone attribué aux nœuds pour activer des fonctionnalités telles que la répartition de la charge de travail entre les domaines de défaillance et les provisionneurs de volumes sensibles à la topologie. Après avoir obtenu mon diplôme en Kubernetes 1.17, les étiquettes ont également été exploitées pour permettre des fonctionnalités de routage tenant compte de la topologie pour les communications de pod à pod.
Vous trouverez ci-dessous quelques stratégies permettant de contrôler la quantité de trafic cross-AZ entre les pods de votre cluster EKS afin de réduire les coûts et de minimiser la latence.
Si vous souhaitez une visibilité granulaire de la quantité de trafic cross-AZ entre les pods de votre cluster (comme la quantité de données transférées en octets), consultez cet article.

Comme le montre le schéma précédent, les services constituent la couche d'abstraction réseau stable qui reçoit le trafic destiné à vos Pods. Lorsqu'un service est créé, plusieurs EndpointSlices sont créés. Chacun EndpointSlice possède une liste de points de terminaison contenant un sous-ensemble d'adresses de pod ainsi que les nœuds sur lesquels ils s'exécutent et toute information topologique supplémentaire. Lorsque vous utilisez Amazon VPC CNI, kube-proxy s'exécute en tant que daemonset sur chaque nœud. Il gère les règles du réseau pour permettre la communication entre les pods et la découverte de services. Alternative : les BPF-based CNI peuvent ne pas utiliser kube-proxy mais fournir un comportement équivalent. Il joue le rôle de routage interne, mais il le fait en fonction de ce qu'il consomme de la création EndpointSlices.
Sur Amazon EKS, kube-proxy utilise principalement les règles NAT iptables (ou nftables, IPVS
Utilisation du routage tenant compte de la topologie (anciennement connu sous le nom d'indices tenant compte de la topologie)
Lorsque le routage tenant compte de la topologie kube-proxyacheminera ensuite le trafic d'une zone vers un point final en fonction des conseils appliqués.
Le schéma ci-dessous montre comment EndpointSlices les indices sont organisés de manière à kube-proxy pouvoir savoir vers quelle destination ils doivent se rendre en fonction de leur point d'origine zonal. Sans indices, une telle allocation ou organisation n'existe pas et le trafic sera acheminé par proxy vers différentes destinations zonales, quelle que soit sa provenance.

Dans certains cas, le EndpointSlice contrôleur peut appliquer un indice pour une zone différente, ce qui signifie que le terminal peut finir par servir du trafic provenant d'une zone différente. La raison en est d'essayer de maintenir une répartition uniforme du trafic entre les terminaux des différentes zones.
Vous trouverez ci-dessous un extrait de code expliquant comment activer le routage tenant compte de la topologie pour un service.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
  annotations:
    service.kubernetes.io/topology-mode: Auto
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
La capture d'écran ci-dessous montre le résultat d'une application réussie par le EndpointSlice contrôleur d'un indice à un point de terminaison pour une réplique de pod exécutée dans l'AZeu-west-1a.

Note
Il est important de noter que le routage tenant compte de la topologie est toujours en version bêta. Cette fonctionnalité fonctionne de manière plus prévisible avec des charges de travail uniformément réparties sur la topologie du cluster, car le contrôleur alloue les points de terminaison proportionnellement entre les zones, mais peut ignorer les attributions d'indices lorsque les ressources des nœuds d'une zone sont trop déséquilibrées pour éviter une surcharge excessive. Par conséquent, il est fortement recommandé de l'utiliser conjointement avec des contraintes de planification qui augmentent la disponibilité d'une application, telles que les contraintes d'étalement de la topologie des https://kubernetes.io/docs/concepts/scheduling-eviction/topology-spread-constraints/
Utilisation de la distribution du trafic
Introduite dans Kubernetes 1.30 et mise à disposition générale dans la version 1.33, la distribution du trafic
Vous trouverez ci-dessous un extrait de code expliquant comment activer la distribution du trafic pour un service.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  trafficDistribution: PreferClose
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
Lors de l'activation de la distribution du trafic, un défi commun se pose : les points de terminaison d'une seule zone de disponibilité peuvent être surchargés si la majeure partie du trafic provient de cette même zone. Cette surcharge peut créer des problèmes importants :
-
Un seul HPA (Horizontal Pod Autoscaler) gérant un déploiement multi-AZ peut réagir en répartissant les pods sur différentes zones de zone de disponibilité. Cependant, cette action ne permet pas de remédier efficacement à l'augmentation de la charge dans la zone affectée.
-
Cette situation peut à son tour entraîner une inefficacité des ressources. Lorsque des autoscalers de cluster tels que Karpenter détectent la mise à l'échelle des pods sur différentes zones de zone de zone de zone de zone, ils peuvent provisionner des nœuds supplémentaires dans les zones de zone de zone de zone non affectées, ce qui entraîne une allocation de ressources inutile.
Pour surmonter ce défi :
-
Créez des déploiements distincts par zone qui disposeraient de leurs propres HPA pouvant évoluer indépendamment les uns des autres.
-
Tirez parti des contraintes de répartition de la topologie pour garantir la répartition de la charge de travail sur l'ensemble du cluster, ce qui permet d'éviter les surcharges des terminaux dans les zones à fort trafic.
Utilisation d'autoscalers : provisionner des nœuds vers une zone de disponibilité spécifique
Nous vous recommandons vivement d'exécuter vos charges de travail dans des environnements hautement disponibles sur plusieurs zones de disponibilité. Cela améliore la fiabilité de vos applications, en particulier en cas d'incident ou de problème avec un AZ. Si vous êtes prêt à sacrifier la fiabilité pour réduire les coûts liés au réseau, vous pouvez limiter vos nœuds à une seule zone de disponibilité.
Pour exécuter tous vos Pods dans la même zone de disponibilité, provisionnez les nœuds de travail dans la même zone de disponibilité ou planifiez les Pods sur les nœuds de travail exécutés sur la même zone de disponibilité. Pour approvisionner des nœuds au sein d'une seule zone de disponibilité, définissez un groupe de nœuds avec des sous-réseaux appartenant à la même zone de disponibilité avec Cluster Autoscaler (CA). topology.kubernetes.io/zone et spécifiez l'AZ où vous souhaitez créer les nœuds de travail. Par exemple, l'extrait de code d'approvisionnement Karpenter ci-dessous provisionne les nœuds de la zone de zone de zone de zone de zone us-west-2a.
Charpentier
apiVersion: karpenter.sh/v1
kind: Provisioner
metadata:
name: single-az
spec:
  requirements:

* key: "topology.kubernetes.io/zone"`
operator: In
values: ["us-west-2a"]
Cluster Autoscaler (CA)
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-ca-cluster
  region: us-east-1
  version: "1.21"
availabilityZones:

* us-east-1a
managedNodeGroups:
* name: managed-nodes
labels:
  role: managed-nodes
instanceType: t3.medium
minSize: 1
maxSize: 10
desiredCapacity: 1
...
Utilisation de l'affectation des pods et de l'affinité des nœuds
Sinon, si vous avez des nœuds de travail exécutés dans plusieurs zones de disponibilité, chaque nœud portera l'étiquette topology.kubernetes. io/zonenodeSelector ou nodeAffinity programmer des Pods pour les nœuds d'une seule zone de disponibilité. Par exemple, le fichier manifeste suivant planifiera le Pod à l'intérieur d'un nœud s'exécutant dans AZ us-west-2a.
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    env: test
spec:
  nodeSelector:
    topology.kubernetes.io/zone: us-west-2a
  containers:

* name: nginx
image: nginx
imagePullPolicy: IfNotPresent
Restreindre le trafic vers un nœud
Dans certains cas, la restriction du trafic au niveau de la zone n'est pas suffisante. Outre la réduction des coûts, vous pouvez avoir l'obligation supplémentaire de réduire la latence du réseau entre certaines applications qui ont des intercommunications fréquentes. Afin d'obtenir des performances réseau optimales et de réduire les coûts, vous devez trouver un moyen de limiter le trafic à un nœud spécifique. Par exemple, le microservice A doit toujours communiquer avec le microservice B sur le nœud 1, même dans les configurations à haute disponibilité (HA). Le fait que le microservice A sur le nœud 1 communique avec le microservice B sur le nœud 2 peut avoir un impact négatif sur les performances souhaitées pour les applications de cette nature, en particulier si le nœud 2 se trouve dans une zone de zone de disponibilité distincte.
Utilisation de la politique de trafic interne du service
Afin de limiter le trafic réseau du Pod à un nœud, vous pouvez utiliser la politique de trafic interne du service Local, le trafic sera limité aux points de terminaison du nœud d'où provient le trafic. Cette politique impose l'utilisation exclusive des points de terminaison locaux des nœuds. Par conséquent, les coûts liés au trafic réseau pour cette charge de travail seront inférieurs à ceux associés à une distribution à l'échelle du cluster. De plus, la latence sera plus faible, ce qui rendra votre application plus performante.
Note
Il est important de noter que cette fonctionnalité ne peut pas être combinée avec le routage tenant compte de la topologie dans Kubernetes.
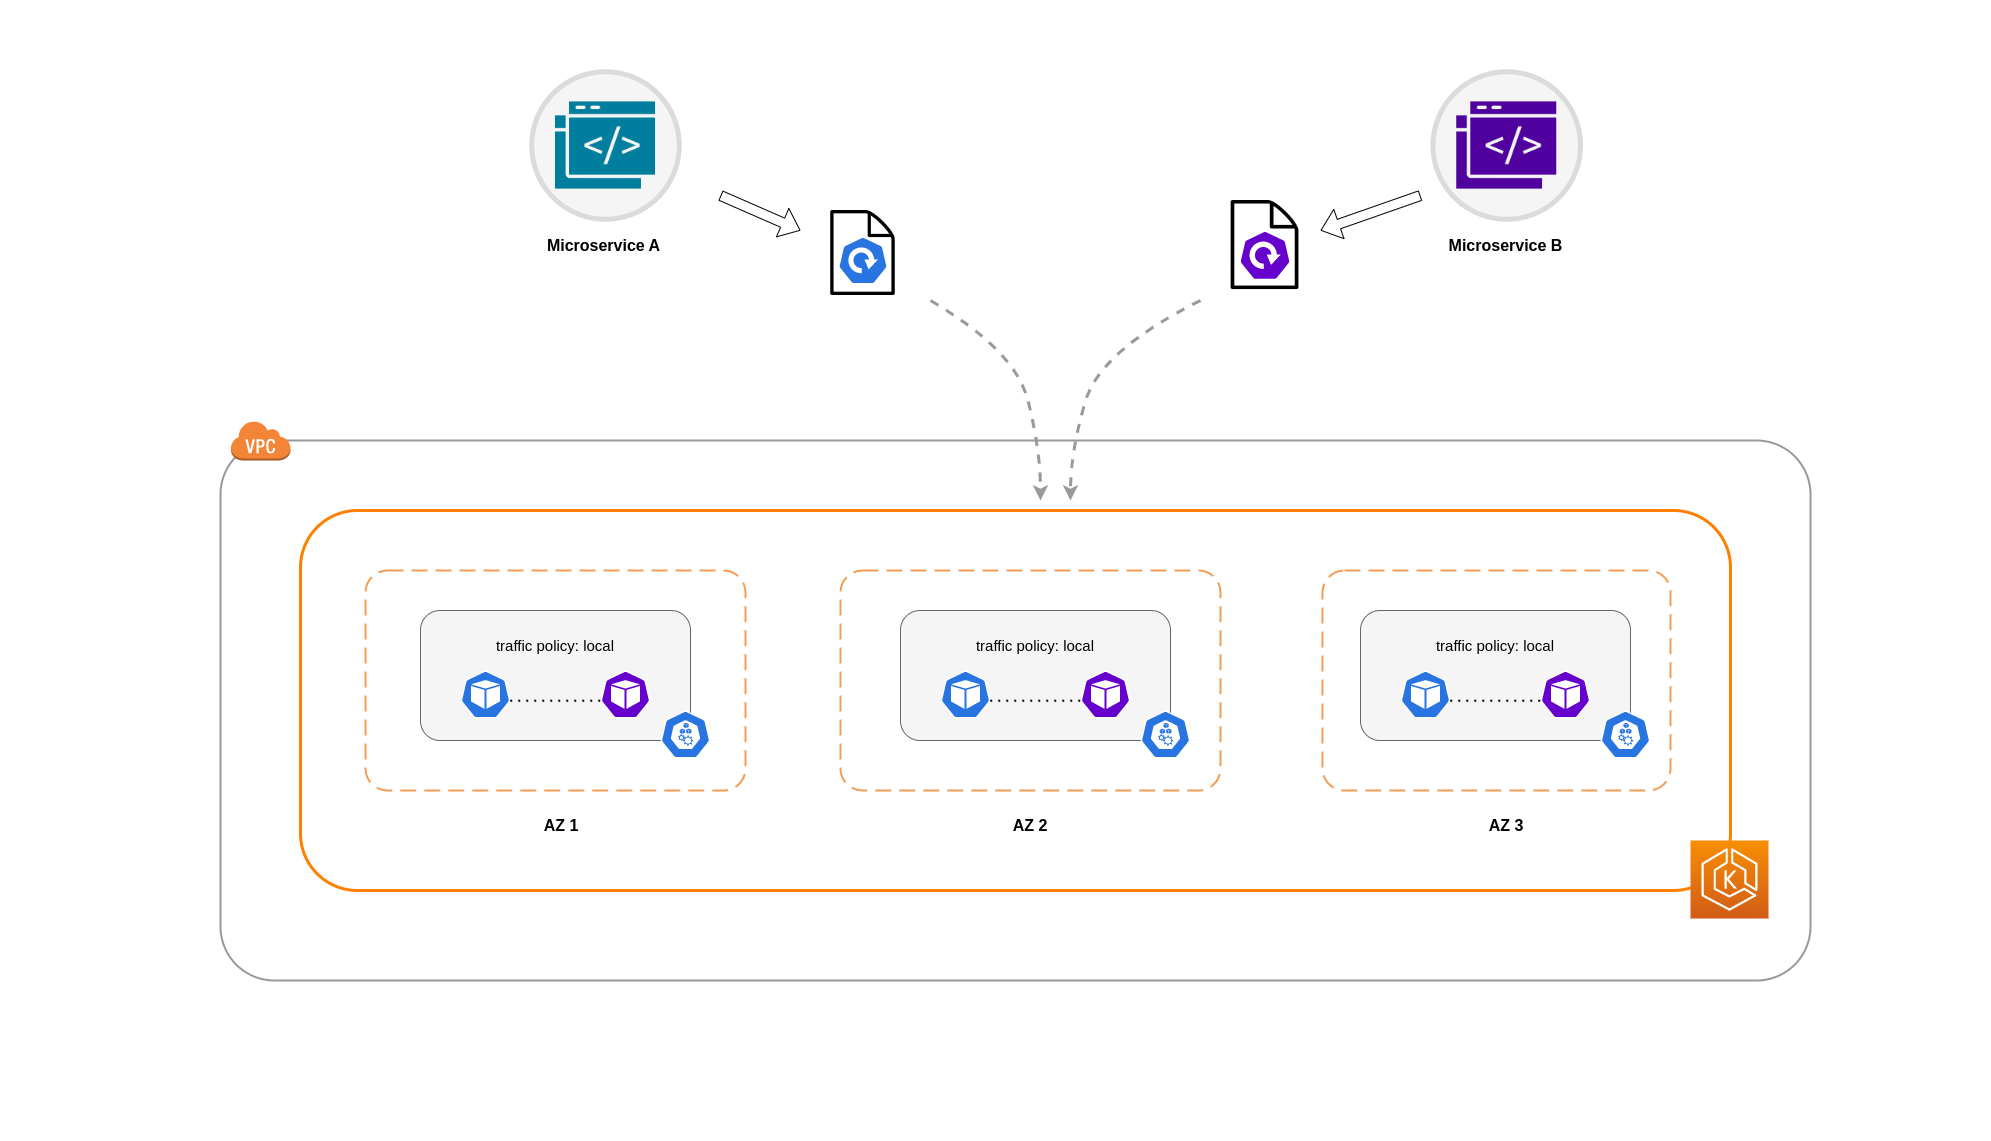
Vous trouverez ci-dessous un extrait de code expliquant comment définir la politique de trafic interne d'un service.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
  internalTrafficPolicy: Local
Pour éviter tout comportement inattendu de la part de votre application en raison de baisses de trafic, vous devez envisager les approches suivantes :
-
Exécutez suffisamment de répliques pour chacun des Pods communicants
-
Disposez d'une répartition relativement uniforme des Pods en utilisant les contraintes d'étalement de la topologie
-
Utilisez les règles d'affinité des pods
pour la co-localisation des pods communicants
Dans cet exemple, vous disposez de deux répliques du microservice A et de trois répliques du microservice B. Si les répliques du microservice A sont réparties entre les nœuds 1 et 2 et que les 3 répliques du microservice B se trouvent sur le nœud 3, ils ne pourront pas communiquer en raison de la politique de trafic interne. Local Lorsqu'aucun point de terminaison local au nœud n'est disponible, le trafic est interrompu.

Si le Microservice B possède 2 de ses 3 répliques sur les nœuds 1 et 2, il y aura une communication entre les applications homologues. Mais vous auriez toujours une réplique isolée du Microservice B sans aucune réplique homologue avec laquelle communiquer.

Note
Dans certains scénarios, une réplique isolée telle que celle illustrée dans le schéma ci-dessus peut ne pas être préoccupante si elle remplit toujours une fonction (par exemple, répondre à des demandes provenant de trafic entrant externe).
Utilisation de la politique de trafic interne du service avec des contraintes de répartition de la topologie
L'utilisation de la politique de trafic interne en conjonction avec les contraintes d'étalement de la topologie peut s'avérer utile pour garantir que vous disposez du nombre approprié de répliques pour communiquer des microservices sur différents nœuds.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: express-test
spec:
  replicas: 6
  selector:
    matchLabels:
      app: express-test
  template:
    metadata:
      labels:
        app: express-test
        tier: backend
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: "topology.kubernetes.io/zone"
        whenUnsatisfiable: ScheduleAnyway
        labelSelector:
          matchLabels:
            app: express-test
Utilisation de la politique de trafic interne du service avec les règles d'affinité des pods
Une autre approche consiste à utiliser les règles d'affinité des pods lors de l'utilisation de la politique de trafic interne du service. Grâce à Pod Affinity, vous pouvez influencer le planificateur pour qu'il colocalise certains Pods en raison de leurs communications fréquentes. En appliquant des contraintes de planification strictes (requiredDuringSchedulingIgnoredDuringExecution) à certains pods, vous obtiendrez de meilleurs résultats en matière de colocalisation des pods lorsque le planificateur place des pods sur des nœuds.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: graphql
  namespace: ecommerce
  labels:
    app.kubernetes.io/version: "0.1.6"
    ...
    spec:
      serviceAccountName: graphql-service-account
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
Communication entre l'équilibreur de charge et le pod
Les charges de travail EKS sont généralement gérées par un équilibreur de charge qui distribue le trafic aux pods concernés de votre cluster EKS. Votre architecture peut comprendre des équilibreurs de charge internes orientés vers l' and/or extérieur. En fonction de votre architecture et de la configuration de votre trafic réseau, la communication entre les équilibreurs de charge et les Pods peut contribuer de manière significative aux frais de transfert de données.
Vous pouvez utiliser le contrôleur AWS Load Balancer
Lorsque vous utilisez le mode instance, un NodePort sera ouvert sur chaque nœud de votre cluster EKS. L'équilibreur de charge transmettra ensuite le trafic de manière uniforme sur les nœuds. Si le Pod de destination est en cours d'exécution sur un nœud, aucun coût de transfert de données ne sera facturé. Toutefois, si le pod de destination se trouve sur un nœud distinct et dans une zone de zone de disponibilité différente de celle où le trafic NodePort reçoit, il y aura un saut réseau supplémentaire entre le kube-proxy et le pod de destination. Dans un tel scénario, des frais de transfert de données inter-AZ seront facturés. En raison de la répartition uniforme du trafic entre les nœuds, il est fort probable que des frais de transfert de données supplémentaires soient associés aux sauts de trafic réseau interzones entre les proxys kube et les pods de destination concernés.
Le schéma ci-dessous illustre un chemin réseau pour le trafic circulant de l'équilibreur de charge vers le pod de destination NodePort, puis du kube-proxy pod de destination sur un nœud distinct dans une zone de disponibilité différente. Voici un exemple de réglage du mode d'instance.

Lorsque vous utilisez le mode IP, le trafic réseau est transmis par proxy depuis l'équilibreur de charge directement vers le pod de destination. Par conséquent, cette approche n'entraîne aucun frais de transfert de données.
Note
Il est recommandé de configurer votre équilibreur de charge en mode trafic IP afin de réduire les frais de transfert de données. Pour cette configuration, il est également important de vous assurer que votre équilibreur de charge est déployé sur tous les sous-réseaux de votre VPC.
Le schéma ci-dessous illustre les chemins réseau pour le trafic circulant depuis l'équilibreur de charge vers les Pods en mode IP réseau.

Transfert de données depuis le registre des conteneurs
Amazon ECR
Le transfert de données vers le registre privé Amazon ECR est gratuit. In-region le transfert de données est gratuit, mais le transfert de données vers Internet et entre les régions sera facturé aux tarifs de transfert de données Internet des deux côtés du transfert.
Vous devez utiliser la fonction de réplication d'images intégrée à ECR pour répliquer les images de conteneurs pertinentes dans la même région que vos charges de travail. De cette façon, la réplication serait chargée une seule fois et toutes les images extraites de la même région (intra-région) seraient gratuites.
Vous pouvez réduire davantage les coûts de transfert de données associés à l'extraction d'images depuis l'ECR (transfert de données sortantes) en utilisant les points de terminaison Interface VPC pour vous connecter aux référentiels ECR régionaux. L'approche alternative consistant à se connecter au point de terminaison AWS public d'ECR (via une passerelle NAT et une passerelle Internet) entraînera des coûts de traitement et de transfert de données plus élevés. La section suivante abordera plus en détail la réduction des coûts de transfert de données entre vos charges de travail et les services AWS.
Si vous exécutez des charges de travail contenant des images particulièrement volumineuses, vous pouvez créer vos propres Amazon Machine Images (AMI) personnalisées à l'aide d'images de conteneur pré-mises en cache. Cela peut réduire le temps d'extraction initial de l'image et les coûts potentiels de transfert de données d'un registre de conteneurs vers les nœuds de travail EKS.
Transfert de données vers Internet & AWS Services
Il est courant d'intégrer les charges de travail Kubernetes à d'autres services AWS ou à des outils et plateformes tiers via Internet. L'infrastructure réseau sous-jacente utilisée pour acheminer le trafic vers et depuis la destination concernée peut avoir une incidence sur les coûts liés au processus de transfert de données.
Utilisation des passerelles NAT
Les passerelles NAT sont des composants réseau qui effectuent la traduction d'adresses réseau (NAT). Le schéma ci-dessous illustre les pods d'un cluster EKS communiquant avec d'autres services AWS (Amazon ECR, DynamoDB et S3) et des plateformes tierces. Dans cet exemple, les pods s'exécutent dans des sous-réseaux privés dans des zones de zone de disponibilité distinctes. Pour envoyer et recevoir du trafic depuis Internet, une passerelle NAT est déployée sur le sous-réseau public d'une zone de disponibilité, permettant à toutes les ressources possédant des adresses IP privées de partager une seule adresse IP publique pour accéder à Internet. Cette passerelle NAT communique à son tour avec le composant de passerelle Internet, ce qui permet d'envoyer des paquets vers leur destination finale.

Lorsque vous utilisez des passerelles NAT pour de tels cas d'utilisation, vous pouvez minimiser les coûts de transfert de données en déployant une passerelle NAT dans chaque zone de disponibilité. De cette façon, le trafic acheminé vers Internet passera par la passerelle NAT dans la même zone de disponibilité, évitant ainsi le transfert de données entre les AZ. Cependant, même si vous réalisez des économies sur le coût du transfert de données inter-AZ, cette configuration implique que vous devrez payer le coût d'une passerelle NAT supplémentaire dans votre architecture.
Cette approche recommandée est illustrée dans le schéma ci-dessous.

Utilisation de points de terminaison de VPC
Pour réduire davantage les coûts liés à de telles architectures, vous devez utiliser des points de terminaison VPC pour établir la connectivité entre vos charges de travail et les services AWS. Les points de terminaison VPC vous permettent d'accéder aux services AWS depuis un VPC sans que des data/network paquets ne traversent Internet. Tout le trafic est interne et reste au sein du réseau AWS. Il existe deux types de points de terminaison VPC : les points de terminaison VPC d'interface (pris en charge par de nombreux services AWS) et les points de terminaison VPC de passerelle (uniquement pris en charge par S3 et DynamoDB).
Points de terminaison Gateway VPC
Aucun coût horaire ou de transfert de données n'est associé aux points de terminaison Gateway VPC. Lorsque vous utilisez des points de terminaison Gateway VPC, il est important de noter qu'ils ne sont pas extensibles au-delà des limites du VPC. Ils ne peuvent pas être utilisés pour le peering de VPC, les réseaux VPN ou via Direct Connect.
Points de terminaison VPC d'interface
Les points de terminaison VPC sont facturés à l'heure
Le schéma ci-dessous montre les Pods communiquant avec les services AWS via des points de terminaison VPC.

Transfert de données entre VPC
Dans certains cas, vous pouvez avoir des charges de travail dans des VPC distincts (au sein de la même région AWS) qui doivent communiquer entre eux. Cela peut être accompli en permettant au trafic de traverser l'Internet public via des passerelles Internet connectées aux VPC respectifs. Une telle communication peut être activée en déployant des composants d'infrastructure tels que des instances EC2, des passerelles NAT ou des instances NAT dans des sous-réseaux publics. Cependant, une configuration incluant ces composants entraînera des frais pour les processing/transferring données entrantes et sortantes des VPC. Si le trafic à destination et en provenance des différents VPC passe d'une zone de zone à l'autre, des frais supplémentaires seront facturés pour le transfert de données. Le schéma ci-dessous illustre une configuration qui utilise des passerelles NAT et des passerelles Internet pour établir la communication entre les charges de travail de différents VPC.

Connexions d'appairage de VPC
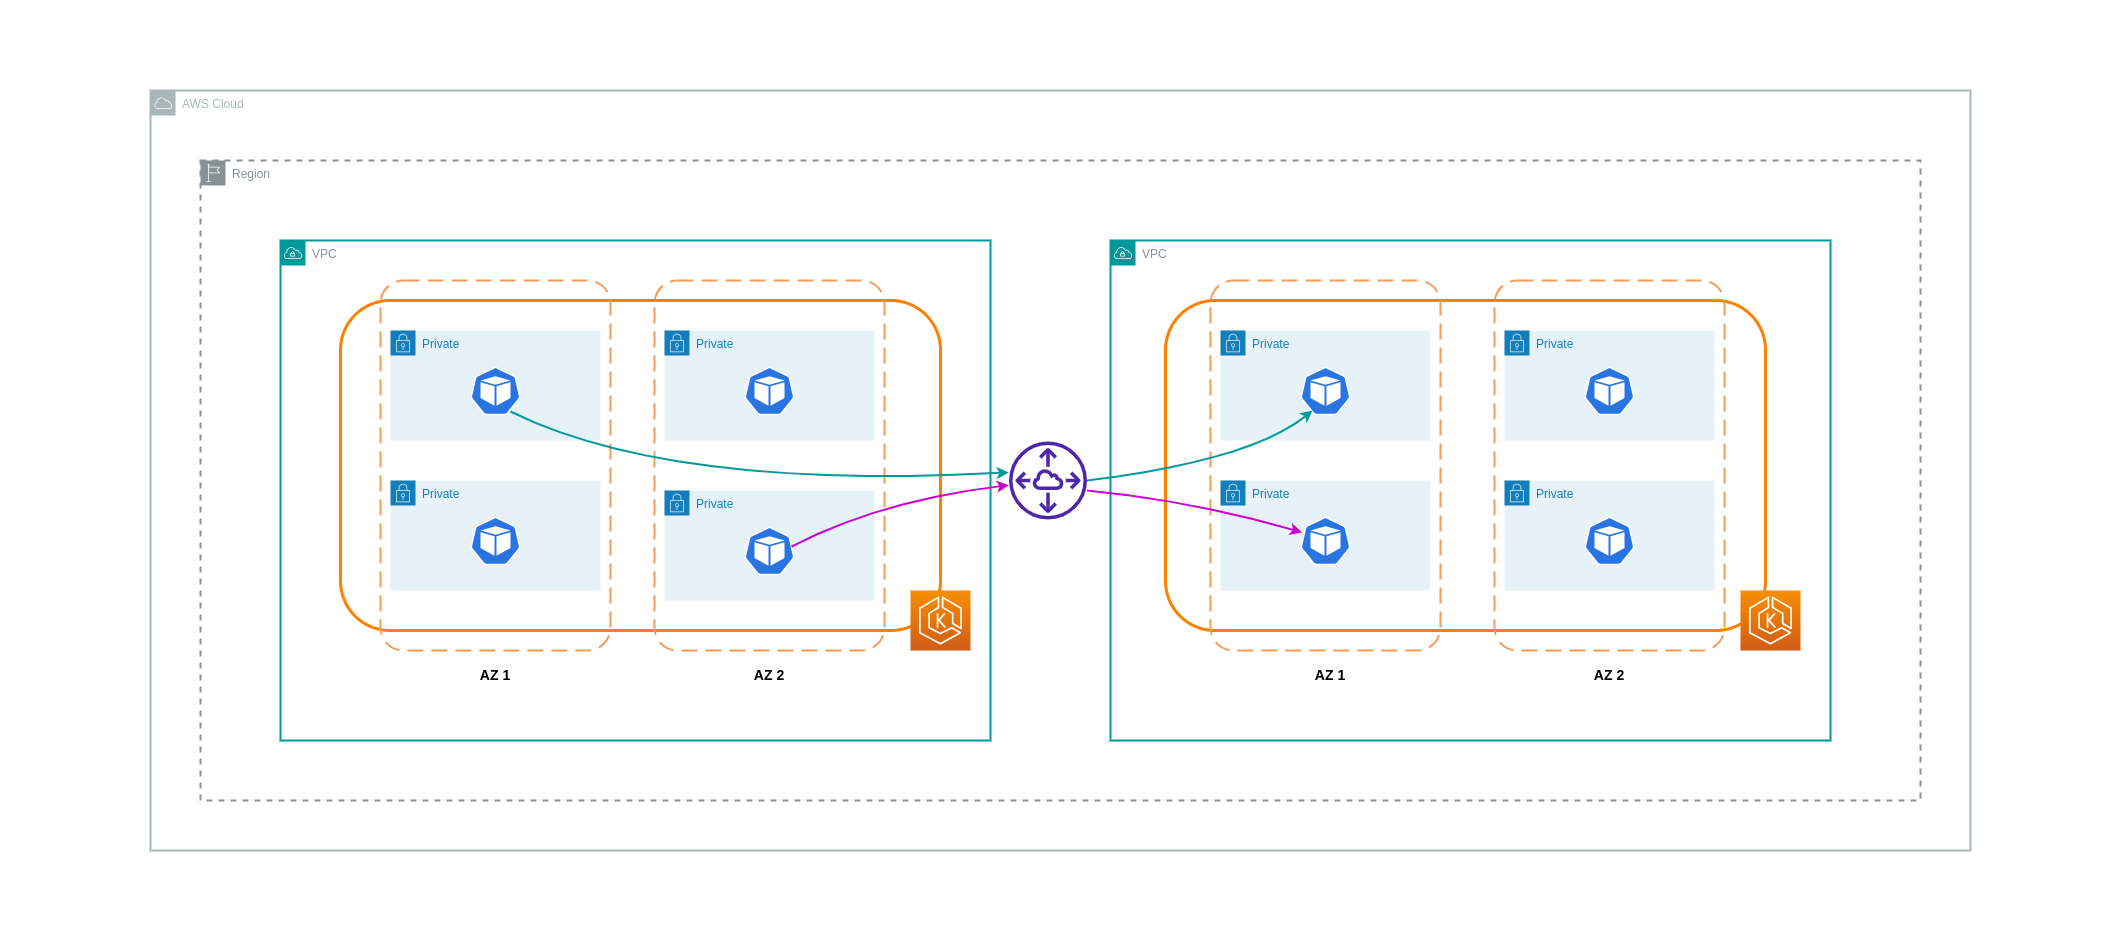
Pour réduire les coûts liés à de tels cas d'utilisation, vous pouvez utiliser VPC Peering. Avec une connexion VPC Peering, aucun frais de transfert de données n'est facturé pour le trafic réseau qui reste dans la même zone de disponibilité. Si le trafic traverse les zones de circulation, des frais seront facturés. Néanmoins, l'approche VPC Peering est recommandée pour une communication rentable entre les charges de travail dans des VPC distincts au sein de la même région AWS. Cependant, il est important de noter que le peering VPC est principalement efficace pour la connectivité VPC 1:1, car il ne permet pas la mise en réseau transitive.
Le schéma ci-dessous est une représentation de haut niveau de la communication des charges de travail via une connexion d'appairage VPC.
Connexions réseau transitives
Comme indiqué dans la section précédente, les connexions VPC Peering ne permettent pas une connectivité réseau transitive. Si vous souhaitez connecter 3 VPC ou plus avec des exigences de réseau transitives, vous devez utiliser une passerelle de transit (TGW). Cela vous permettra de surmonter les limites du peering VPC ou toute surcharge opérationnelle associée à la présence de plusieurs connexions VPC Peering entre plusieurs VPC. Vous êtes facturé sur une base horaire
Le schéma ci-dessous montre le trafic inter-AZ circulant via un TGW entre les charges de travail de différents VPC mais au sein de la même région AWS.

Utilisation d'un Service Mesh
Les maillages de services offrent de puissantes fonctionnalités réseau qui peuvent être utilisées pour réduire les coûts liés au réseau dans vos environnements de clusters EKS. Cependant, vous devez examiner attentivement les tâches opérationnelles et la complexité qu'un maillage de services introduira dans votre environnement si vous en adoptez un.
Restreindre le trafic aux zones de disponibilité
Utilisation de la distribution pondérée par localité d'Istio
Istio vous permet d'appliquer des politiques réseau au trafic une fois le routage effectué. Cela se fait à l'aide de règles de destination
Note
Avant de mettre en œuvre une distribution pondérée par localité, vous devez commencer par comprendre les modèles de trafic de votre réseau et les implications que la politique de règle de destination peut avoir sur le comportement de votre application. Il est donc important de mettre en place des mécanismes de traçage distribués avec des outils tels qu'AWS X-Ray
Les règles de destination Istio détaillées ci-dessus peuvent également être appliquées pour gérer le trafic d'un équilibreur de charge vers les pods de votre cluster EKS. Les règles de distribution pondérées par localité peuvent être appliquées à un service qui reçoit du trafic en provenance d'un équilibreur de charge hautement disponible (en particulier la passerelle d'entrée). Ces règles vous permettent de contrôler la quantité de trafic acheminée en fonction de son origine zonale, en l'occurrence l'équilibreur de charge. S'il est configuré correctement, moins de trafic sortant entre zones sera généré par rapport à un équilibreur de charge qui distribue le trafic de manière uniforme ou aléatoire entre les répliques de pod dans différentes zones de zone de disponibilité.
Vous trouverez ci-dessous un exemple de bloc de code d'une ressource de règle de destination dans Istio. Comme on peut le voir ci-dessous, cette ressource spécifie des configurations pondérées pour le trafic entrant en provenance de 3 zones de zone de couverture différentes de la eu-west-1 région. Ces configurations indiquent que la majorité du trafic entrant (70 % dans ce cas) en provenance d'une zone de disponibilité donnée doit être acheminé par proxy vers une destination située dans la même zone de zone de sécurité d'où il provient.
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: express-test-dr
spec:
  host: express-test.default.svc.cluster.local
  trafficPolicy:
    loadBalancer:                      +
      localityLbSetting:
        distribute:
        - from: eu-west-1/eu-west-1a/  +
          to:
            "eu-west-1/eu-west-1a/_": 70
            "eu-west-1/eu-west-1b/_": 20
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1b/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 70
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1c/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 10
            "eu-west-1/eu-west-1c/*": 70**
    connectionPool:
      http:
        http2MaxRequests: 10
        maxRequestsPerConnection: 10
    outlierDetection:
      consecutiveGatewayErrors: 1
      interval: 1m
      baseEjectionTime: 30s
Note
Le poids minimum pouvant être distribué à destination est de 1 %. La raison en est de conserver les régions et les zones de basculement au cas où les points de terminaison de la destination principale deviendraient défectueux ou indisponibles.
Le diagramme ci-dessous illustre un scénario dans lequel il existe un équilibreur de charge hautement disponible dans la région eu-ouest-1 et une distribution pondérée par localité est appliquée. La politique de règle de destination pour ce diagramme est configurée pour envoyer 60 % du trafic en provenance de eu-west-1a vers des pods situés dans la même zone de disponibilité, tandis que 40 % du trafic en provenance de eu-west-1a doit être dirigé vers des pods situés dans eu-west-1b.

Restreindre le trafic aux zones de disponibilité et aux nœuds
Utilisation de la politique de trafic interne du service avec Istio
Pour réduire les coûts réseau associés au trafic entrant externe et au trafic interne entre les pods, vous pouvez combiner les règles de destination d'Istio et la politique de trafic interne du service Kubernetes. La manière de combiner les règles de destination d'Istio avec la politique de trafic interne du service dépendra en grande partie de trois facteurs :
-
Le rôle des microservices
-
Modèles de trafic réseau sur les microservices
-
Comment les microservices doivent être déployés dans la topologie du cluster Kubernetes
Le schéma ci-dessous montre à quoi ressemblerait le flux réseau dans le cas d'une demande imbriquée et comment les politiques susmentionnées contrôleraient le trafic.

-
L'utilisateur final adresse une demande à l'APP A, qui à son tour envoie une demande imbriquée à l'APP C. Cette demande est d'abord envoyée à un équilibreur de charge hautement disponible, qui possède des instances dans AZ 1 et AZ 2, comme le montre le schéma ci-dessus.
-
La demande entrante externe est ensuite acheminée vers la bonne destination par le service virtuel Istio.
-
Une fois la demande acheminée, la règle de destination Istio contrôle la quantité de trafic destinée aux zones de sécurité respectives en fonction de son origine (AZ 1 ou AZ 2).
-
Le trafic est ensuite dirigé vers le Service pour l'APP A, puis est transmis par proxy aux points de terminaison du Pod respectifs. Comme le montre le schéma, 80 % du trafic entrant est envoyé aux points de terminaison du pod dans l'AZ 1 et 20 % du trafic entrant est envoyé vers l'AZ 2.
-
L'APP A adresse ensuite une demande interne à l'APP C. Le service APP C dispose d'une politique de trafic interne activée (
internalTrafficPolicy`: Local`). -
La demande interne de l'APP A (sur le NŒUD 1) à l'APP C est réussie en raison du point de terminaison local au nœud disponible pour l'APP C.
-
La demande interne de l'APP A (sur le NŒUD 3) à l'APP C échoue car aucun point de terminaison local au nœud n'est disponible pour l'APP C. Comme le montre le schéma, APP C n'a aucune réplique sur NODE 3. * *
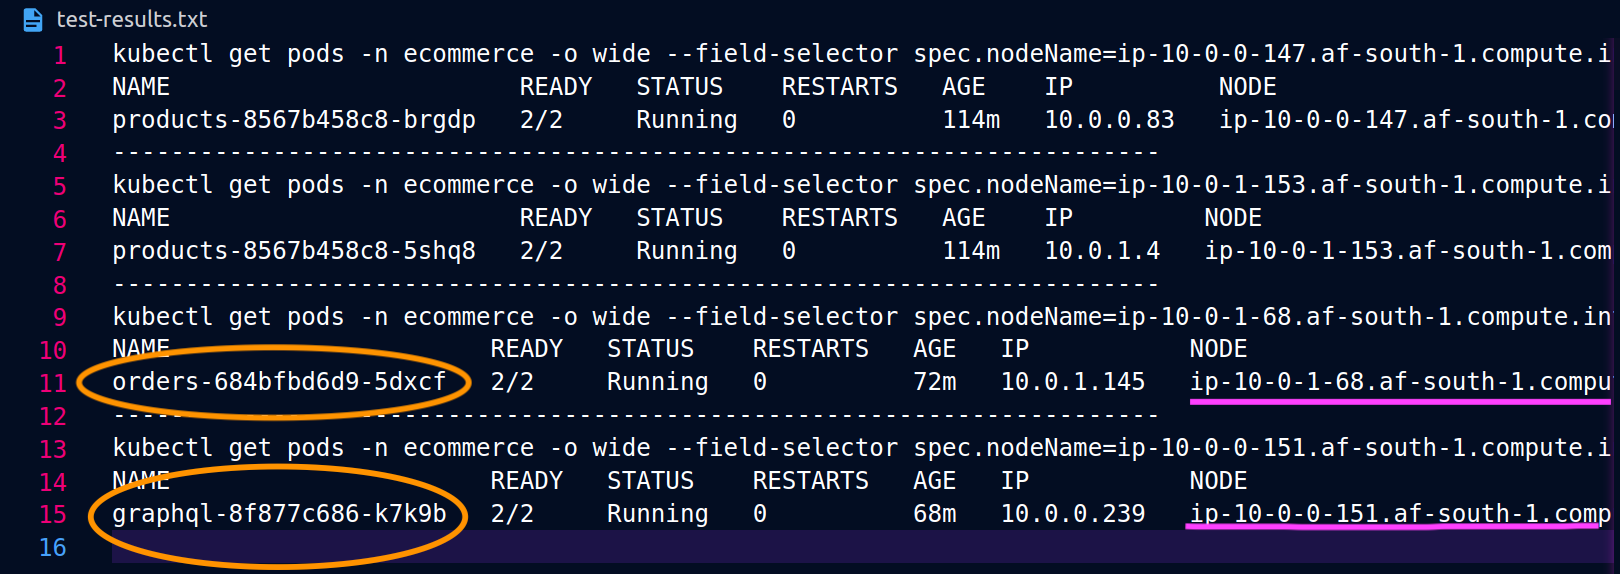
Les captures d'écran ci-dessous sont extraites d'un exemple concret de cette approche. La première série de captures d'écran montre une demande externe réussie adressée à un graphql et une demande imbriquée réussie provenant de celui-ci graphql vers une orders réplique colocalisée sur le nœud. ip-10-0-0-151.af-south-1.compute.internal


Avec Istio, vous pouvez vérifier et exporter les statistiques de tous les clusters et points de terminaison orders points de terminaison connus par le graphql proxy peuvent être obtenus à l'aide de la commande suivante :
kubectl exec -it deploy/graphql -n ecommerce -c istio-proxy -- curl localhost:15000/clusters | grep orders
...
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_error::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_success::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_timeout::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_total::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**health_flags::healthy**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**region::af-south-1**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**zone::af-south-1b**
...
Dans ce cas, le graphql proxy ne connaît que le orders point de terminaison de la réplique avec lequel il partage un nœud. Si vous supprimez le internalTrafficPolicy: Local paramètre du service des commandes et que vous relancez une commande comme celle ci-dessus, les résultats renverront tous les points de terminaison des répliques répartis sur les différents nœuds. De plus, en examinant rq_total les points de terminaison respectifs, vous remarquerez une part relativement uniforme de la distribution du réseau. Par conséquent, si les terminaux sont associés à des services en amont exécutés dans différentes zones de zone de disponibilité, cette distribution du réseau entre les zones entraînera des coûts plus élevés.
Comme mentionné dans la section précédente ci-dessus, vous pouvez co-localiser des Pods qui communiquent fréquemment en utilisant l'affinité entre les pods.
...
spec:
...
  template:
    metadata:
      labels:
        app: graphql
        role: api
        workload: ecommerce
    spec:
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
      nodeSelector:
        managedBy: karpenter
        billing-team: ecommerce
...
Lorsque les orders répliques graphql et ne coexistent pas sur le même nœud (ip-10-0-0-151.af-south-1.compute.internal), la première demande à graphql est réussie, comme indiqué 200 response code dans la capture d'écran de Postman ci-dessous, tandis que la deuxième demande imbriquée de graphql to orders échoue avec un. 503 response code

Ressources supplémentaires
-
Gestion des coûts de latence et de transfert de données sur EKS à l'aide d'Istio
-
Obtenir de la visibilité sur les octets du réseau Cross-AZ de votre espace Amazon EKS
-
Optimisez le trafic AZ grâce au routage tenant compte de la topologie
-
Présentation des coûts de transfert des données pour les architectures courantes
-
Comprendre les coûts de transfert de données pour les services de conteneurs AWS
