Las traducciones son generadas a través de traducción automática. En caso de conflicto entre la traducción y la version original de inglés, prevalecerá la version en inglés.
Optimización de costos: redes
Diseñar sistemas de alta disponibilidad (HA) es una práctica recomendada para lograr la resiliencia y la tolerancia a los fallos. En la práctica, esto significa distribuir las cargas de trabajo y la infraestructura subyacente en varias zonas de disponibilidad (AZ) de una región de AWS determinada. Garantizar la existencia de estas características en su entorno de Amazon EKS mejorará la confiabilidad general de su sistema. Además, es probable que sus entornos de EKS también estén compuestos por una variedad de construcciones (es decir, VPC), componentes (es decir, ELB) e integraciones (es decir, ECR y otros registros de contenedores).
La combinación de sistemas de alta disponibilidad y otros componentes específicos para cada caso de uso puede desempeñar un papel importante en la forma en que se transfieren y procesan los datos. Esto, a su vez, tendrá un impacto en los costos incurridos debido a la transferencia y el procesamiento de datos.
Las prácticas que se detallan a continuación le ayudarán a diseñar y optimizar sus entornos de EKS para lograr la rentabilidad en diferentes dominios y casos de uso.
Comunicación de pod a pod
En función de la configuración, la comunicación de red y la transferencia de datos entre los pods pueden tener un impacto significativo en el coste total de ejecutar las cargas de trabajo de Amazon EKS. En esta sección, se abordarán diferentes conceptos y enfoques para mitigar los costos relacionados con la comunicación entre pods, teniendo en cuenta las arquitecturas de alta disponibilidad (HA), el rendimiento de las aplicaciones y la resiliencia.
Restringir el tráfico a una zona de disponibilidad
Desde el principio, el proyecto Kubernetes comenzó a desarrollar construcciones que tuvieran en cuenta la topología, incluidas etiquetas como las de Kubernetes. io/hostname, topology.kubernetes. io/regiony topology.kubernetes. io/zone se asignan a los nodos para habilitar funciones como la distribución de la carga de trabajo entre los dominios con errores y los aprovisionadores de volúmenes compatibles con la topología. Tras haber adoptado Kubernetes 1.17, las etiquetas también se utilizaron para habilitar capacidades de enrutamiento basadas en la topología para la comunicación de un pod a otro.
A continuación, se muestran algunas estrategias sobre cómo controlar la cantidad de tráfico entre zonas de disponibilidad entre los pods de tu clúster de EKS para reducir los costos y minimizar la latencia.
Si quieres tener una visión detallada de la cantidad de tráfico entre zonas de disponibilidad entre los pods de tu clúster (por ejemplo, la cantidad de datos transferidos en bytes), consulta esta publicación.
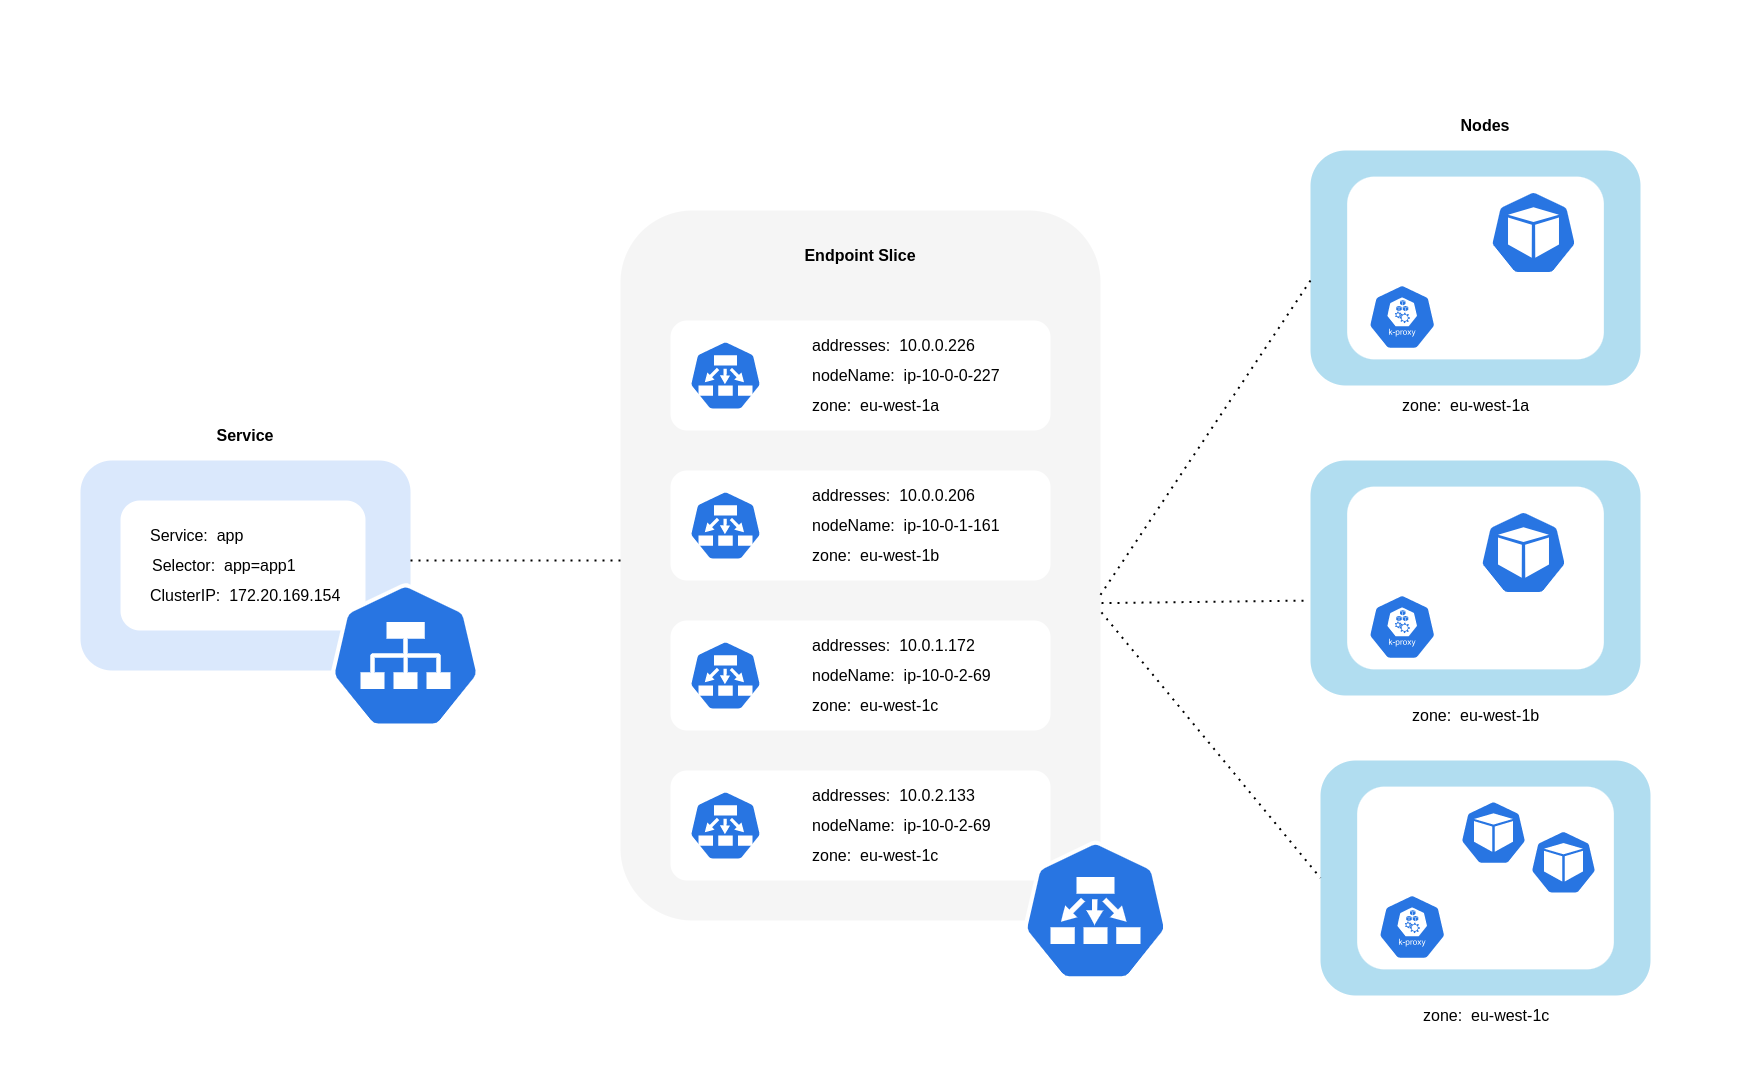
Como se muestra en el diagrama anterior, los servicios son la capa de abstracción de red estable que recibe el tráfico destinado a tus pods. Cuando se crea un servicio, EndpointSlices se crean varios. Cada uno EndpointSlice tiene una lista de puntos finales que contiene un subconjunto de direcciones de pod junto con los nodos en los que se ejecutan y cualquier información de topología adicional. Cuando se usa el CNI de Amazon VPC, kube-proxy se ejecuta como un daemonset en cada nodo. Mantiene las reglas de red para permitir la comunicación con los pods y la detección de servicios. BPF-based Es posible que los CNI alternativos no usen kube-proxy, pero proporcionen un comportamiento equivalente. Cumple la función de enrutamiento interno, pero lo hace en función de lo que consume de lo creado. EndpointSlices
En Amazon EKS, kube-proxy utiliza principalmente las reglas NAT de iptables (o nftables o IPVS
Uso del enrutamiento con reconocimiento de topología (anteriormente conocido como sugerencias con reconocimiento de topología)
Cuando se habilita e implementa el enrutamiento con reconocimiento de kube-proxyA continuación, dirigirá el tráfico de una zona a un punto final en función de las sugerencias que se apliquen.
El siguiente diagrama muestra cómo EndpointSlices se organizan las sugerencias de forma que kube-proxy puedan saber a qué destino deben ir en función de su punto de origen zonal. Sin sugerencias, no existe tal asignación u organización y el tráfico se redirigirá a diferentes destinos zonales independientemente de su procedencia.

En algunos casos, el EndpointSlice controlador puede aplicar una sugerencia para una zona diferente, lo que significa que el punto final podría terminar atendiendo el tráfico que se origina en una zona diferente. El motivo es intentar mantener una distribución uniforme del tráfico entre los puntos finales de las diferentes zonas.
A continuación se muestra un fragmento de código sobre cómo habilitar el enrutamiento con reconocimiento de topología para un servicio.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
  annotations:
    service.kubernetes.io/topology-mode: Auto
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
La captura de pantalla siguiente muestra el resultado de que el EndpointSlice controlador haya aplicado correctamente una pista a un punto final para una réplica de un pod que se está ejecutando en la Arizona. eu-west-1a

nota
Es importante tener en cuenta que el enrutamiento compatible con la topología aún está en fase beta. Esta función funciona de manera más predecible con cargas de trabajo distribuidas de manera uniforme en la topología del clúster, ya que el controlador asigna los puntos finales de forma proporcional entre las zonas, pero puede omitir la asignación de sugerencias cuando los recursos de los nodos de una zona están demasiado desequilibrados para evitar una sobrecarga excesiva. Por lo tanto, es muy recomendable utilizarla junto con restricciones de programación que aumenten la disponibilidad de una aplicación, como las restricciones de distribución de la topología de los pods. https://kubernetes.io/docs/concepts/scheduling-eviction/topology-spread-constraints/
Uso de la distribución del tráfico
Traffic Distribution, que se introdujo en Kubernetes 1.30 y se puso a disposición del público en la versión 1.33,
A continuación se muestra un fragmento de código sobre cómo habilitar la distribución del tráfico en un servicio.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  trafficDistribution: PreferClose
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
Al habilitar la distribución del tráfico, surge un desafío común: los puntos finales de una única zona de disponibilidad pueden sobrecargarse si la mayor parte del tráfico proviene de esa misma zona. Esta sobrecarga puede crear problemas importantes:
-
Un único escalador automático (HPA) de módulos horizontales que gestione una implementación en zonas de disponibilidad múltiples puede responder escalando los módulos entre diferentes zonas de disponibilidad. Sin embargo, esta acción no aborda de manera eficaz el aumento de la carga en la zona afectada.
-
Esta situación, a su vez, puede llevar a la ineficiencia de los recursos. Cuando los escaladores automáticos de clústeres, como Karpenter, detectan el escalado horizontal del pod en diferentes zonas de disponibilidad, pueden aprovisionar nodos adicionales en las zonas de disponibilidad no afectadas, lo que resulta en una asignación innecesaria de recursos.
Para superar este desafío:
-
Cree despliegues independientes por zona que tengan sus propios HPA para escalar de forma independiente unos de otros.
-
Aproveche las restricciones de dispersión de la topología para garantizar la distribución de la carga de trabajo en todo el clúster, lo que ayuda a evitar la sobrecarga de los terminales en las zonas de alto tráfico.
Uso de escaladores automáticos: aprovisione nodos a una zona de disponibilidad específica
Recomendamos encarecidamente ejecutar las cargas de trabajo en entornos de alta disponibilidad en varias zonas de disponibilidad. Esto mejora la confiabilidad de sus aplicaciones, especialmente cuando se produce un incidente relacionado con una zona de disponibilidad. Si está dispuesto a sacrificar la confiabilidad para reducir los costos relacionados con la red, puede restringir sus nodos a una sola zona de disponibilidad.
Para ejecutar todos tus pods en la misma AZ, aprovisiona los nodos de trabajo de la misma AZ o programa los pods de los nodos de trabajo que se ejecutan en la misma AZ. Para aprovisionar nodos en una única zona de disponibilidad, define un grupo de nodos con subredes que pertenezcan a la misma zona de disponibilidad con Cluster Autoscaler (CA). topology.kubernetes.io/zone y especifica la zona de disponibilidad en la que quieres crear los nodos de trabajo. Por ejemplo, el siguiente fragmento del aprovisionador de Karpenter aprovisiona los nodos de la zona de disponibilidad us-west-2a.
Karpenter
apiVersion: karpenter.sh/v1
kind: Provisioner
metadata:
name: single-az
spec:
  requirements:

* key: "topology.kubernetes.io/zone"`
operator: In
values: ["us-west-2a"]
Cluster Autoscaler (CA)
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-ca-cluster
  region: us-east-1
  version: "1.21"
availabilityZones:

* us-east-1a
managedNodeGroups:
* name: managed-nodes
labels:
  role: managed-nodes
instanceType: t3.medium
minSize: 1
maxSize: 10
desiredCapacity: 1
...
Uso de la asignación de pods y la afinidad de nodos
Como alternativa, si tiene nodos de trabajo que se ejecutan en varias zonas de disponibilidad, cada nodo tendría la etiqueta topology.kubernetes. io/zonenodeSelector o programar el envío de Pods nodeAffinity a los nodos de una sola AZ. Por ejemplo, el siguiente archivo de manifiesto programará el pod dentro de un nodo que se ejecute en AZ us-west-2a.
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    env: test
spec:
  nodeSelector:
    topology.kubernetes.io/zone: us-west-2a
  containers:

* name: nginx
image: nginx
imagePullPolicy: IfNotPresent
Restringir el tráfico a un nodo
Hay casos en los que restringir el tráfico a nivel zonal no es suficiente. Además de reducir los costos, es posible que tenga el requisito adicional de reducir la latencia de la red entre ciertas aplicaciones que tienen intercomunicaciones frecuentes. Para lograr un rendimiento óptimo de la red y reducir los costos, necesita una forma de restringir el tráfico a un nodo específico. Por ejemplo, el microservicio A siempre debe comunicarse con el microservicio B en el nodo 1, incluso en configuraciones de alta disponibilidad (HA). Hacer que el Microservicio A en el Nodo 1 se comunique con el Microservicio B en el Nodo 2 puede tener un impacto negativo en el rendimiento deseado para las aplicaciones de esta naturaleza, especialmente si el Nodo 2 se encuentra en una AZ completamente separada.
Uso de la política de tráfico interno del servicio
Para restringir el tráfico de la red de pods a un nodo, puedes usar la política de tráfico interno del Servicio Local, el tráfico se restringirá a los puntos finales del nodo desde el que se originó el tráfico. Esta política establece el uso exclusivo de los puntos finales locales del nodo. Esto implica que los costos relacionados con el tráfico de red para esa carga de trabajo serán más bajos que si la distribución se realizara en todo el clúster. Además, la latencia será menor, lo que aumentará el rendimiento de la aplicación.
nota
Es importante tener en cuenta que esta función no se puede combinar con el enrutamiento compatible con la topología en Kubernetes.
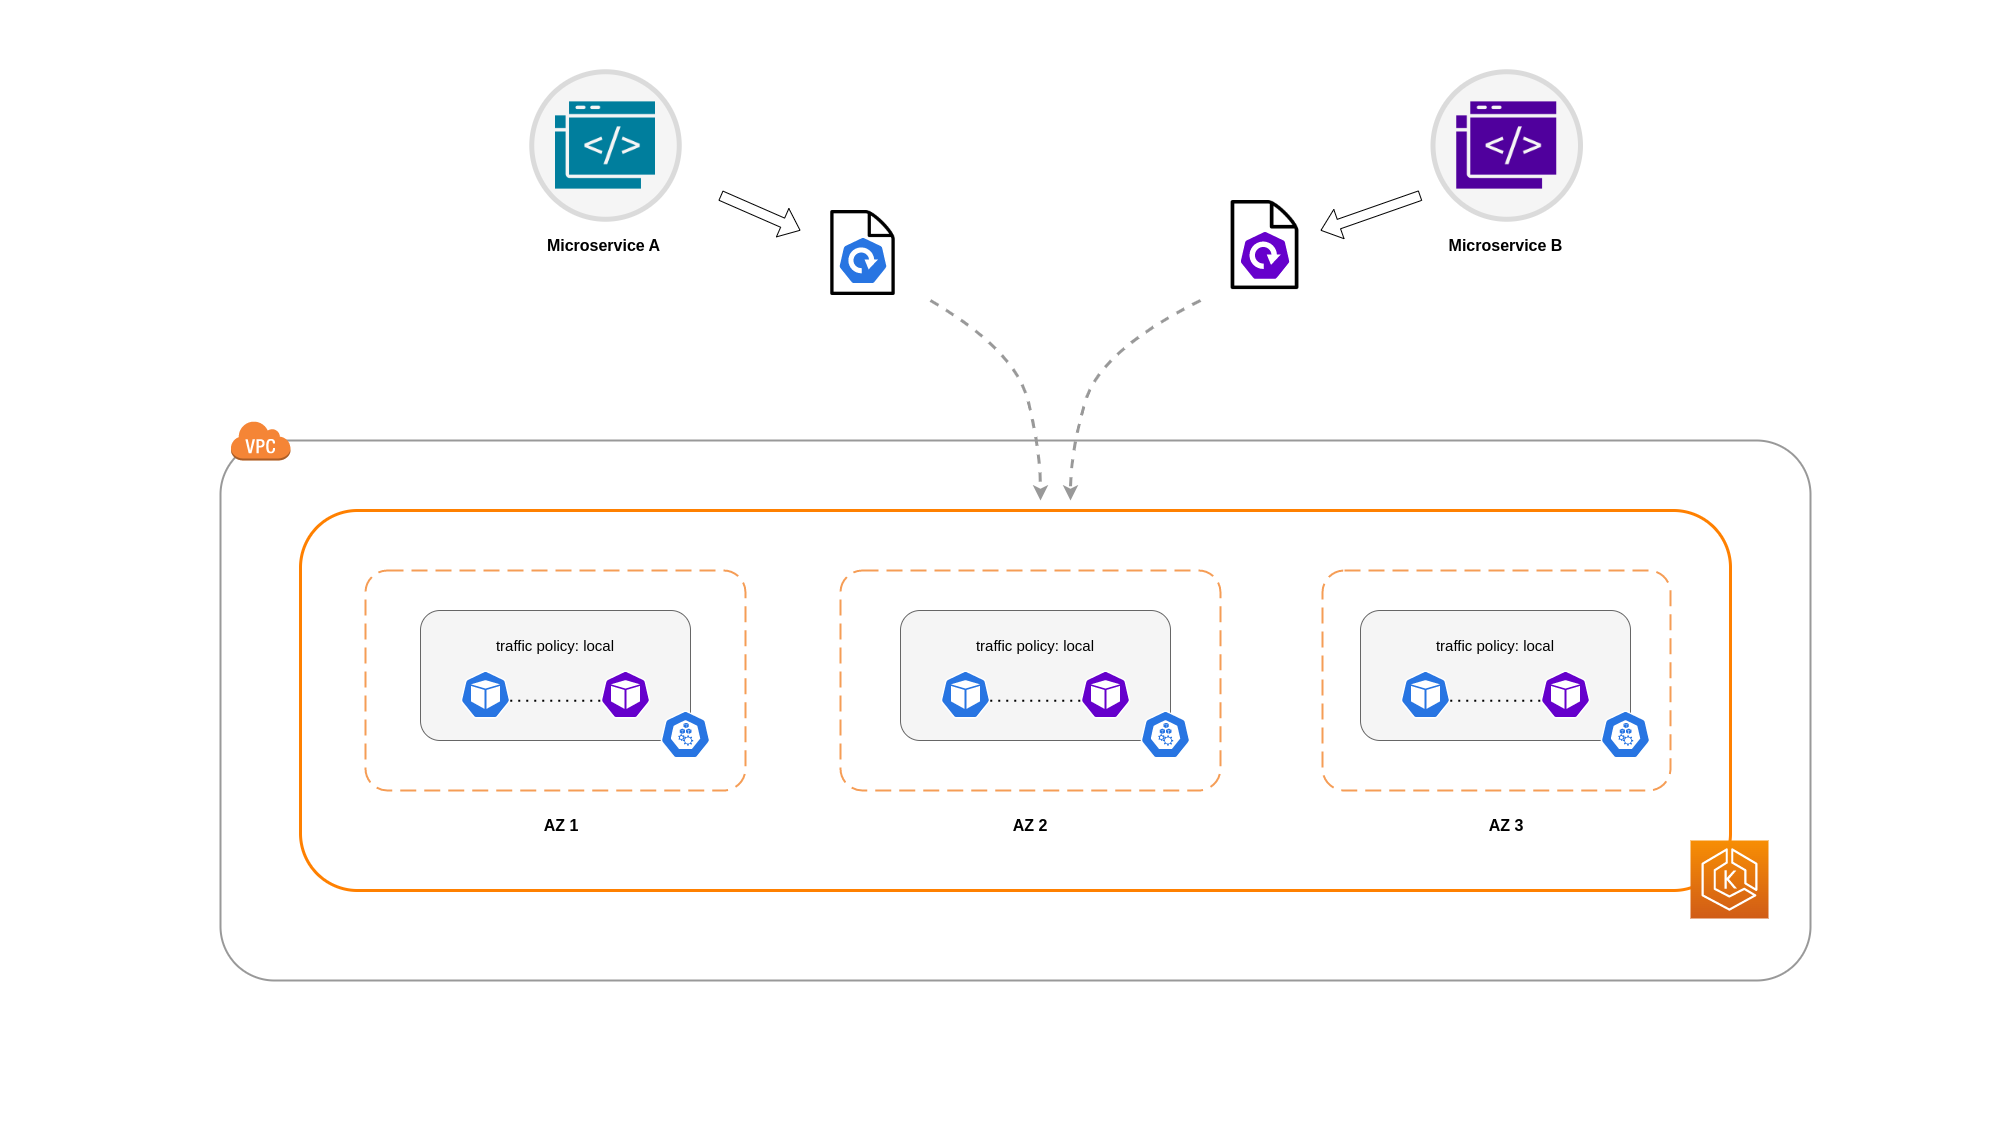
A continuación se muestra un fragmento de código sobre cómo configurar la política de tráfico interno de un servicio.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
  internalTrafficPolicy: Local
Para evitar un comportamiento inesperado por parte de tu aplicación debido a la caída del tráfico, debes tener en cuenta los siguientes enfoques:
-
Ejecuta suficientes réplicas para cada uno de los pods que se comunican
-
Ten una distribución relativamente uniforme de los pods utilizando las restricciones de distribución de la topología
-
Usa las reglas de afinidad de los pods
para la ubicación conjunta de los pods que se comunican
En este ejemplo, tienes 2 réplicas del Microservicio A y 3 réplicas del Microservicio B. Si el Microservicio A tiene sus réplicas distribuidas entre los nodos 1 y 2, y el Microservicio B tiene sus 3 réplicas en el nodo 3, no podrán comunicarse debido a la política de tráfico interno. Local Cuando no hay puntos finales locales en el nodo disponibles, el tráfico se interrumpe.

Si el Microservicio B tiene 2 de sus 3 réplicas en los nodos 1 y 2, habrá comunicación entre las aplicaciones del mismo nivel. Sin embargo, seguiría teniendo una réplica aislada del Microservicio B sin ninguna réplica del mismo nivel con la que comunicarse.

nota
En algunos casos, una réplica aislada como la que se muestra en el diagrama anterior puede no ser motivo de preocupación si aún cumple un propósito (por ejemplo, atender solicitudes del tráfico entrante externo).
Uso de la política de tráfico interno del servicio con restricciones de dispersión de topología
El uso de la política de tráfico interno junto con las restricciones de dispersión de la topología puede resultar útil para garantizar que dispone del número correcto de réplicas para la comunicación de los microservicios en los diferentes nodos.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: express-test
spec:
  replicas: 6
  selector:
    matchLabels:
      app: express-test
  template:
    metadata:
      labels:
        app: express-test
        tier: backend
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: "topology.kubernetes.io/zone"
        whenUnsatisfiable: ScheduleAnyway
        labelSelector:
          matchLabels:
            app: express-test
Uso de la política de tráfico interno del servicio con las reglas de afinidad de los módulos
Otro enfoque consiste en utilizar las reglas de afinidad de los pods al utilizar la política de tráfico interna del Servicio. Gracias a la afinidad de los pods, puedes influir en el programador para que ubique determinados pods en el mismo lugar, ya que se comunican con frecuencia. Si aplicas restricciones de programación estrictas (requiredDuringSchedulingIgnoredDuringExecution) a determinados pods, obtendrás mejores resultados en cuanto a la ubicación conjunta de los pods cuando el planificador coloque los pods en los nodos.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: graphql
  namespace: ecommerce
  labels:
    app.kubernetes.io/version: "0.1.6"
    ...
    spec:
      serviceAccountName: graphql-service-account
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
Comunicación entre el balanceador de cargas y el pod
Las cargas de trabajo de EKS suelen estar dirigidas por un balanceador de cargas que distribuye el tráfico a los pods correspondientes del clúster de EKS. Tu arquitectura puede incluir balanceadores de cargas internos y and/or externos. En función de tu arquitectura y de las configuraciones del tráfico de red, la comunicación entre los balanceadores de cargas y los pods puede contribuir considerablemente a los gastos de transferencia de datos.
Puede usar el controlador AWS Load Balancer
Cuando utilice el modo de instancia, se NodePort abrirá un nodo en cada nodo del clúster de EKS. A continuación, el balanceador de cargas redireccionará el tráfico de manera uniforme entre los nodos. Si un nodo tiene el pod de destino ejecutándose en él, no se incurrirá en costes de transferencia de datos. Sin embargo, si el pod de destino está en un nodo diferente y en una zona de disponibilidad diferente a la que NodePort recibe el tráfico, habrá un salto de red adicional desde el kube-proxy al pod de destino. En tal caso, se cobrarán cargos por transferencia de datos entre zonas de disponibilidad. Debido a la distribución uniforme del tráfico entre los nodos, es muy probable que los saltos de tráfico de red entre zonas desde los proxys kube a los pods de destino correspondientes generen gastos adicionales por transferencia de datos.
El siguiente diagrama muestra una ruta de red para el tráfico que fluye desde el balanceador de cargas hasta el pod de destino y NodePort, posteriormente, desde el kube-proxy pod de destino en un nodo diferente en una AZ diferente. Este es un ejemplo de la configuración del modo de instancia.

Cuando se usa el modo IP, el tráfico de red se redirige desde el balanceador de cargas directamente al pod de destino. Por lo tanto, este enfoque no implica ningún cargo por transferencia de datos.
nota
Se recomienda configurar el balanceador de cargas en el modo de tráfico IP para reducir los cargos por transferencia de datos. Para esta configuración, también es importante asegurarte de que el balanceador de cargas esté implementado en todas las subredes de tu VPC.
En el siguiente diagrama, se muestran las rutas de red para el tráfico que fluye desde el balanceador de cargas a los pods en el modo IP de red.

Transferencia de datos desde Container Registry
Amazon ECR
La transferencia de datos al registro privado de Amazon ECR es gratuita. In-region la transferencia de datos es gratuita, pero la transferencia de datos a Internet y entre regiones se cobrará según las tarifas de transferencia de datos por Internet en ambos lados de la transferencia.
Debe utilizar la función de replicación de imágenes integrada de ECR para replicar las imágenes del contenedor correspondientes en la misma región que sus cargas de trabajo. De esta forma, la replicación se cobraría una vez y todas las extracciones de imágenes de la misma región (intrarregión) serían gratuitas.
Puede reducir aún más los costos de transferencia de datos asociados a la extracción de imágenes del ECR (transferencia de datos salientes) mediante el uso de puntos de conexión de Interface VPC para conectarse a los repositorios de ECR de la región. El enfoque alternativo de conectarse al punto final público de AWS de ECR (a través de una puerta de enlace NAT y una puerta de enlace de Internet) generará mayores costos de procesamiento y transferencia de datos. La siguiente sección abordará con más detalle la reducción de los costos de transferencia de datos entre sus cargas de trabajo y los servicios de AWS.
Si ejecuta cargas de trabajo con imágenes especialmente grandes, puede crear sus propias imágenes de máquina de Amazon (AMI) personalizadas con imágenes de contenedor almacenadas previamente en caché. Esto puede reducir el tiempo de extracción inicial de la imagen y los posibles costos de transferencia de datos desde un registro de contenedores a los nodos de trabajo de EKS.
Transferencia de datos a los servicios de & AWS de Internet
Es una práctica habitual integrar las cargas de trabajo de Kubernetes con otros servicios de AWS o con herramientas y plataformas de terceros a través de Internet. La infraestructura de red subyacente que se utiliza para dirigir el tráfico hacia y desde el destino correspondiente puede afectar a los costes derivados del proceso de transferencia de datos.
Uso de puertas de enlace NAT
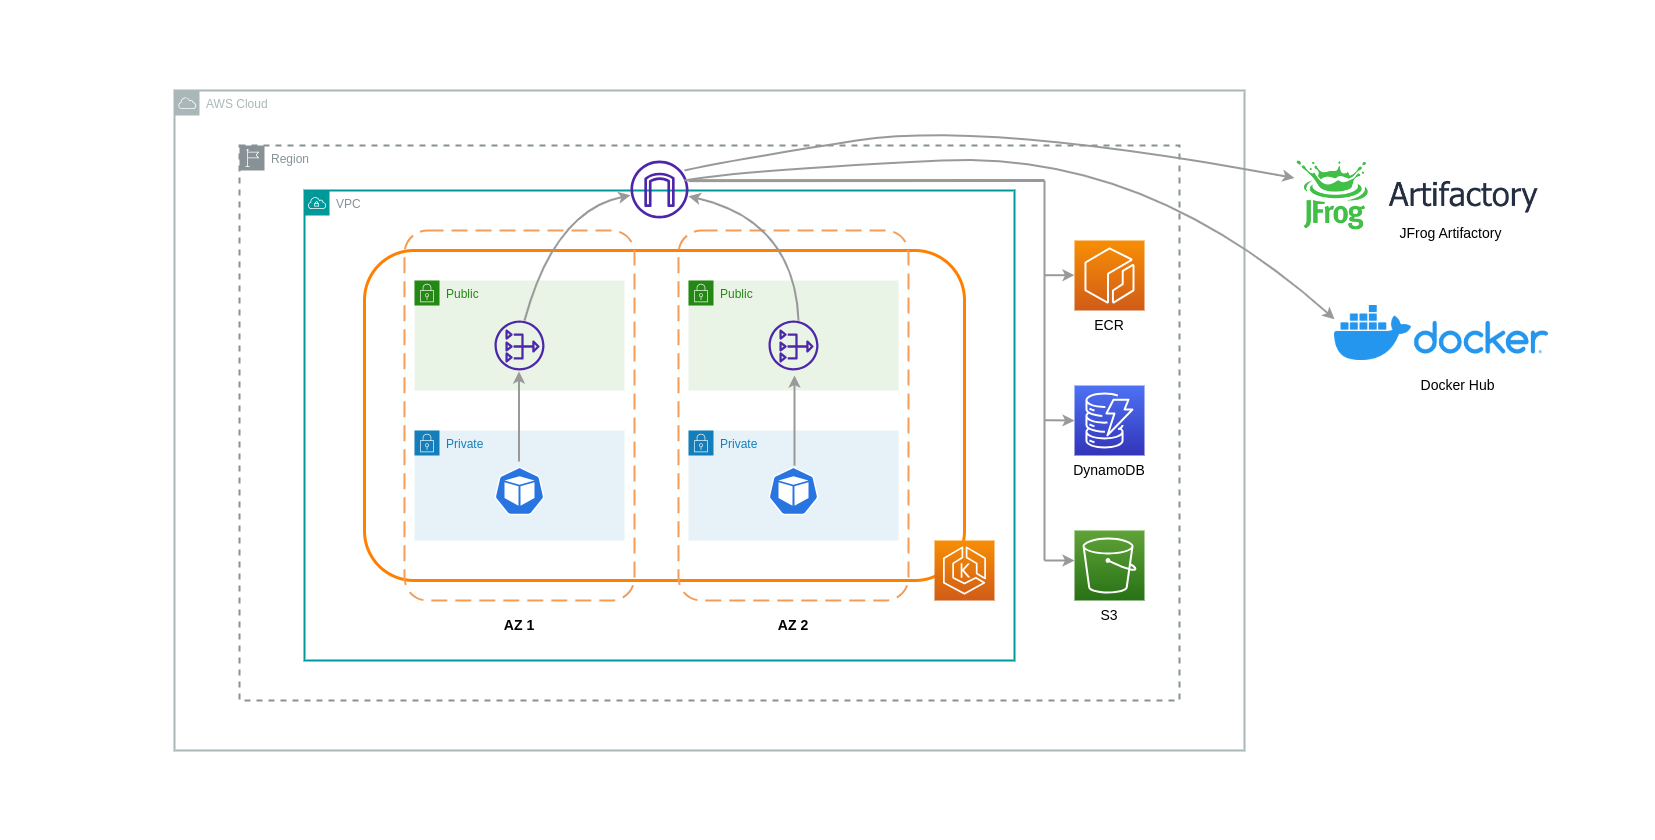
Las puertas de enlace NAT son componentes de red que realizan la traducción de direcciones de red (NAT). El siguiente diagrama muestra los pods de un clúster de EKS que se comunican con otros servicios de AWS (Amazon ECR, DynamoDB y S3) y con plataformas de terceros. En este ejemplo, los pods se ejecutan en subredes privadas en zonas de disponibilidad independientes. Para enviar y recibir tráfico desde Internet, se implementa una puerta de enlace NAT en la subred pública de una zona de disponibilidad, lo que permite que todos los recursos con direcciones IP privadas compartan una única dirección IP pública para acceder a Internet. Esta puerta de enlace NAT, a su vez, se comunica con el componente de puerta de enlace de Internet, lo que permite enviar los paquetes a su destino final.

Al utilizar puertas de enlace NAT para estos casos de uso, puede minimizar los costos de transferencia de datos mediante la implementación de una puerta de enlace NAT en cada zona de disponibilidad. De este modo, el tráfico que se dirija a Internet pasará por la puerta de enlace NAT de la misma zona de disponibilidad, lo que evitará la transferencia de datos entre zonas de disponibilidad. Sin embargo, aunque ahorrará en el costo de la transferencia de datos entre zonas de disponibilidad, esta configuración implica que incurrirá en el costo de una puerta de enlace NAT adicional en su arquitectura.
Este enfoque recomendado se muestra en el siguiente diagrama.
Usar un punto de enlace de la VPC
Para reducir aún más los costos en dichas arquitecturas, debe usar los puntos de enlace de la VPC para establecer la conectividad entre sus cargas de trabajo y los servicios de AWS. Los puntos de enlace de la VPC le permiten acceder a los servicios de AWS desde una VPC sin que los paquetes atraviesen Internet. data/network Todo el tráfico es interno y permanece dentro de la red de AWS. Hay dos tipos de puntos de enlace de VPC: los puntos de enlace de VPC de interfaz (compatibles con muchos servicios de AWS) y los puntos de enlace de VPC de puerta de enlace (solo compatibles con S3 y DynamoDB).
Puntos de enlace de VPC de Gateway
Los terminales de VPC de Gateway no implican costes por hora ni por transferencia de datos. Al usar los puntos de enlace de VPC de Gateway, es importante tener en cuenta que no se pueden extender más allá de los límites de la VPC. No se pueden usar en la interconexión de VPC, en redes de VPN ni mediante Direct Connect.
Puntos finales de interfaz de VPC
Los terminales de VPC se cobran por hora
El siguiente diagrama muestra los pods que se comunican con los servicios de AWS a través de puntos de enlace de la VPC.

Transferencia de datos entre VPC
En algunos casos, es posible que tenga cargas de trabajo en distintas VPC (dentro de la misma región de AWS) que necesiten comunicarse entre sí. Esto se puede lograr permitiendo que el tráfico atraviese la Internet pública a través de pasarelas de Internet conectadas a las VPC respectivas. Esta comunicación se puede habilitar mediante la implementación de componentes de infraestructura como instancias EC2, puertas de enlace NAT o instancias de NAT en subredes públicas. Sin embargo, una configuración que incluya estos componentes generará cargos por la entrada y salida de processing/transferring datos de las VPC. Si el tráfico hacia y desde las distintas VPC se mueve de una zona a otra, se aplicará un cargo adicional por la transferencia de datos. El siguiente diagrama muestra una configuración que usa puertas de enlace NAT y puertas de enlace de Internet para establecer la comunicación entre cargas de trabajo en diferentes VPC.

Interconexiones de VPC
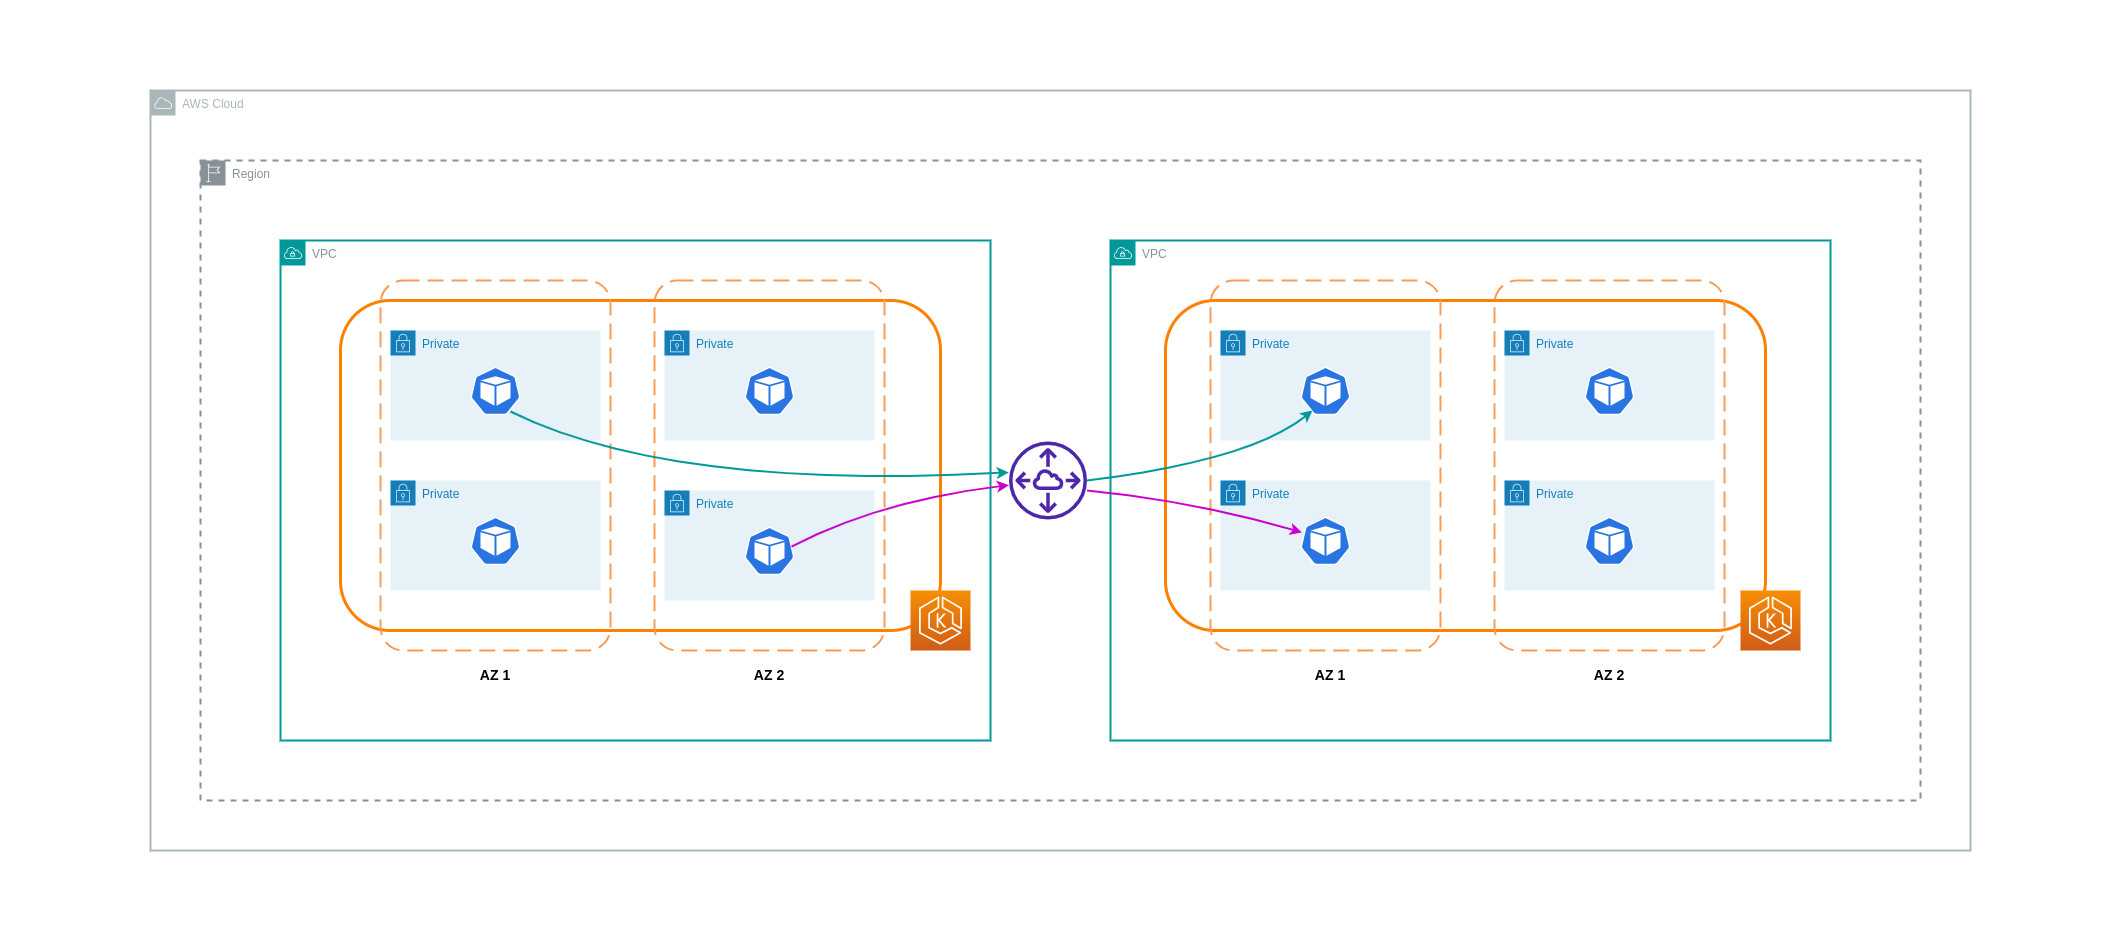
Para reducir los costos de estos casos de uso, puede utilizar la interconexión de VPC. Con una conexión de interconexión de VPC, no se cobran cargos por transferencia de datos para el tráfico de red que permanece dentro de la misma zona de disponibilidad. Si el tráfico cruza una zona de disponibilidad, se incurrirá en un coste. No obstante, se recomienda el enfoque de interconexión de VPC para una comunicación rentable entre cargas de trabajo en VPC distintas dentro de la misma región de AWS. Sin embargo, es importante tener en cuenta que la interconexión de VPC es principalmente eficaz para la conectividad 1:1 de las VPC, ya que no permite la creación de redes transitivas.
El siguiente diagrama es una representación de alto nivel de la comunicación de las cargas de trabajo a través de una conexión de interconexión de VPC.
Conexiones de red transitivas
Como se indicó en la sección anterior, las conexiones de interconexión de VPC no permiten la conectividad de red transitiva. Si desea conectar 3 o más VPC con requisitos de red transitivos, debe usar una Transit Gateway (TGW). Esto le permitirá superar los límites de la interconexión de VPC o cualquier sobrecarga operativa asociada a tener varias conexiones de interconexión de VPC entre varias VPC. Se le facturará por hora
El siguiente diagrama muestra el tráfico entre zonas de disponibilidad que fluye a través de una TGW entre cargas de trabajo en diferentes VPC pero dentro de la misma región de AWS.

Uso de una malla de servicios
Las mallas de servicios ofrecen potentes capacidades de red que se pueden utilizar para reducir los costos relacionados con la red en los entornos de clústeres de EKS. Sin embargo, debe considerar detenidamente las tareas operativas y la complejidad que una malla de servicios introducirá en su entorno si la adopta.
Restringir el tráfico a las zonas de disponibilidad
Uso de la distribución ponderada por localidad de Istio
Istio le permite aplicar políticas de red al tráfico una vez que se produce el enrutamiento. Esto se hace mediante reglas de destino
nota
Antes de implementar la distribución ponderada por localidad, debe empezar por comprender los patrones de tráfico de su red y las implicaciones que la política de reglas de destino puede tener en el comportamiento de su aplicación. Por ello, es importante contar con mecanismos de rastreo distribuidos con herramientas como AWS X-Ray
Las reglas de destino de Istio detalladas anteriormente también se pueden aplicar para administrar el tráfico desde un balanceador de cargas a los pods de tu clúster de EKS. Las reglas de distribución ponderadas por localidad se pueden aplicar a un servicio que reciba tráfico de un balanceador de cargas de alta disponibilidad (específicamente, el Ingress Gateway). Estas reglas te permiten controlar la cantidad de tráfico que va a cada lugar en función de su origen zonal (en este caso, el balanceador de cargas). Si se configura correctamente, se generará menos tráfico de salida entre zonas en comparación con un balanceador de cargas que distribuye el tráfico de manera uniforme o aleatoria a las réplicas de pods en diferentes zonas de disponibilidad.
A continuación, se muestra un ejemplo de bloque de código de un recurso de regla de destino en Istio. Como se puede ver a continuación, este recurso especifica las configuraciones ponderadas para el tráfico entrante de 3 zonas de disponibilidad diferentes de la eu-west-1 región. Estas configuraciones declaran que la mayoría del tráfico entrante (el 70% en este caso) de una zona de disponibilidad determinada debe enviarse mediante proxy a un destino en la misma zona de disponibilidad desde la que se origina.
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: express-test-dr
spec:
  host: express-test.default.svc.cluster.local
  trafficPolicy:
    loadBalancer:                      +
      localityLbSetting:
        distribute:
        - from: eu-west-1/eu-west-1a/  +
          to:
            "eu-west-1/eu-west-1a/_": 70
            "eu-west-1/eu-west-1b/_": 20
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1b/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 70
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1c/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 10
            "eu-west-1/eu-west-1c/*": 70**
    connectionPool:
      http:
        http2MaxRequests: 10
        maxRequestsPerConnection: 10
    outlierDetection:
      consecutiveGatewayErrors: 1
      interval: 1m
      baseEjectionTime: 30s
nota
El peso mínimo que se puede distribuir por destino es del 1%. El motivo es mantener las regiones y zonas de conmutación por error en caso de que los puntos finales del destino principal no funcionen correctamente o no estén disponibles.
El siguiente diagrama muestra un escenario en el que hay un balanceador de cargas de alta disponibilidad en la región eu-west-1 y se aplica una distribución ponderada por localidad. La política de reglas de destino de este diagrama está configurada para enviar el 60% del tráfico procedente de eu-west-1a a los pods de la misma zona residencial, mientras que el 40% del tráfico de eu-west-1a debería ir a los pods de eu-west-1b.

Restringir el tráfico a zonas y nodos de disponibilidad
Uso de la política de tráfico interno del servicio con Istio
Para reducir los costes de red asociados al tráfico entrante externo y al tráfico interno entre pods, puedes combinar las reglas de destino de Istio y la política de tráfico interno del servicio de Kubernetes. La forma de combinar las reglas de destino de Istio con la política de tráfico interna del servicio dependerá en gran medida de tres factores:
-
El papel de los microservicios
-
Patrones de tráfico de red en todos los microservicios
-
Cómo se deben implementar los microservicios en la topología de clústeres de Kubernetes
El siguiente diagrama muestra cómo sería el flujo de la red en el caso de una solicitud anidada y cómo las políticas antes mencionadas controlarían el tráfico.

-
El usuario final hace una solicitud a la APP A, que a su vez hace una solicitud anidada a la APP C. Esta solicitud se envía primero a un balanceador de cargas de alta disponibilidad, que tiene instancias en la AZ 1 y la AZ 2, como se muestra en el diagrama anterior.
-
A continuación, el servicio virtual de Istio dirige la solicitud entrante externa al destino correcto.
-
Una vez enrutada la solicitud, la regla de destino de Istio controla la cantidad de tráfico que va a las zonas de disponibilidad respectivas en función de su lugar de origen (AZ 1 o AZ 2).
-
A continuación, el tráfico va al servicio de la APP A y, a continuación, se redirige a los puntos finales del pod correspondientes. Como se muestra en el diagrama, el 80% del tráfico entrante se envía a los terminales del Pod en la AZ 1 y el 20% del tráfico entrante se envía a la AZ 2.
-
A continuación, la APP A hace una solicitud interna a la APP C. El servicio de la APP C tiene habilitada una política de tráfico interna (
internalTrafficPolicy`: Local`). -
La solicitud interna de la APP A (en el NODO 1) a la APP C se realizó correctamente debido a que el punto final local del nodo está disponible para la APP C.
-
La solicitud interna de la APP A (en el NODO 3) a la APP C falla porque no hay puntos de enlace locales de nodo disponibles para la APP C. Como se muestra en el diagrama, la APP C no tiene réplicas en el NODO 3. * *
Las siguientes capturas de pantalla están tomadas de un ejemplo real de este enfoque. La primera serie de capturas de pantalla muestra una solicitud externa correcta a un nodo graphql y una solicitud anidada correcta graphql a una orders réplica ubicada en el mismo nodo. ip-10-0-0-151.af-south-1.compute.internal

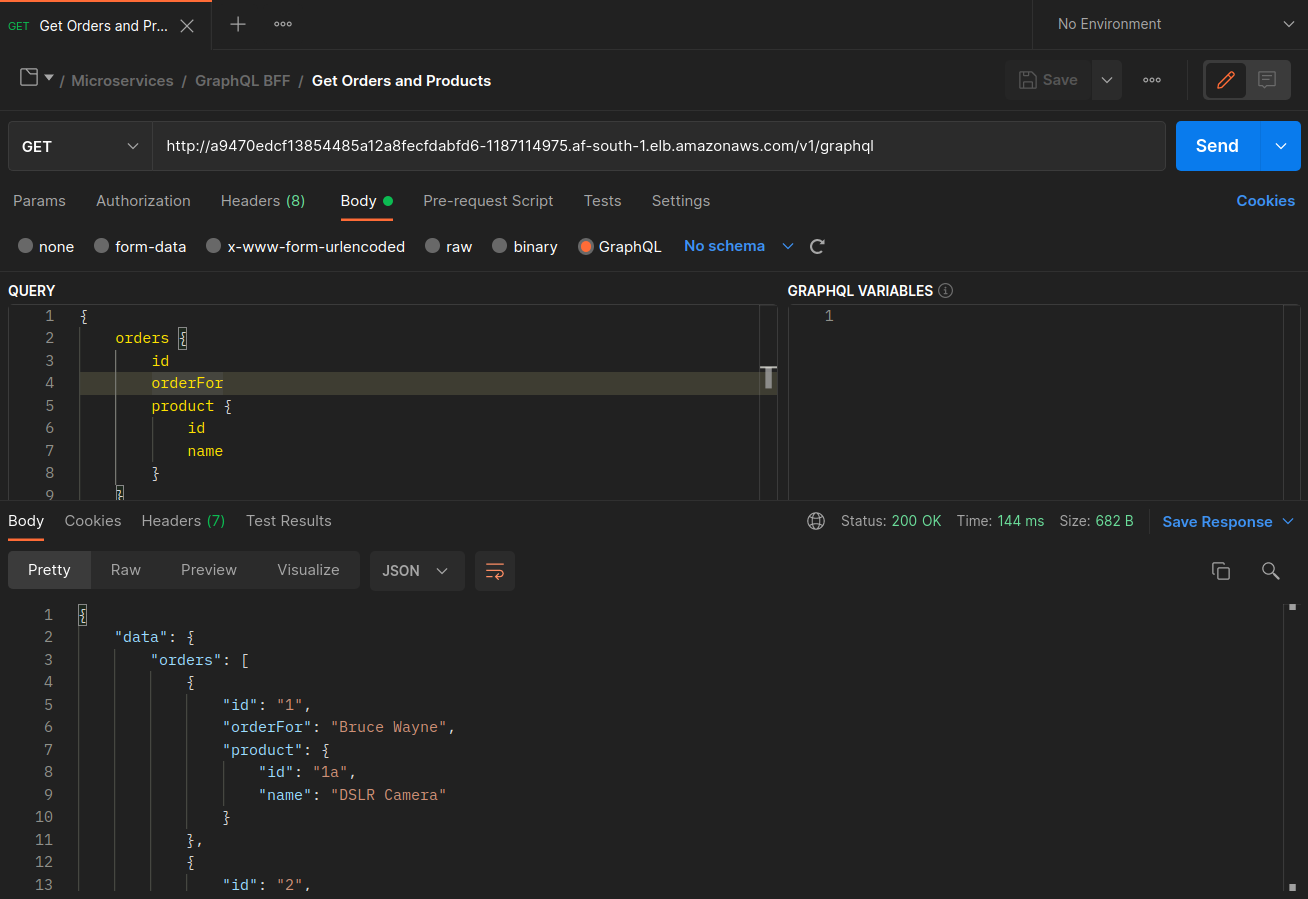
Con Istio, puede verificar y exportar las estadísticas de todos los clústeres y puntos finales orders puntos finales que conoce el graphql proxy se pueden obtener mediante el siguiente comando:
kubectl exec -it deploy/graphql -n ecommerce -c istio-proxy -- curl localhost:15000/clusters | grep orders
...
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_error::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_success::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_timeout::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_total::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**health_flags::healthy**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**region::af-south-1**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**zone::af-south-1b**
...
En este caso, el graphql proxy solo conoce el orders punto final de la réplica con la que comparte un nodo. Si eliminas la internalTrafficPolicy: Local configuración del servicio de pedidos y vuelves a ejecutar un comando como el anterior, los resultados mostrarán todos los puntos finales de las réplicas repartidos por los distintos nodos. Además, si examinas rq_total los puntos finales respectivos, observarás que la distribución de la red es relativamente uniforme. En consecuencia, si los terminales están asociados a servicios ascendentes que se ejecutan en diferentes zonas de disponibilidad, esta distribución de la red entre zonas generará costos más altos.
Como se mencionó en una sección anterior, puedes ubicar juntos los pods que se comuniquen con frecuencia haciendo uso de la afinidad entre los pods.
...
spec:
...
  template:
    metadata:
      labels:
        app: graphql
        role: api
        workload: ecommerce
    spec:
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
      nodeSelector:
        managedBy: karpenter
        billing-team: ecommerce
...
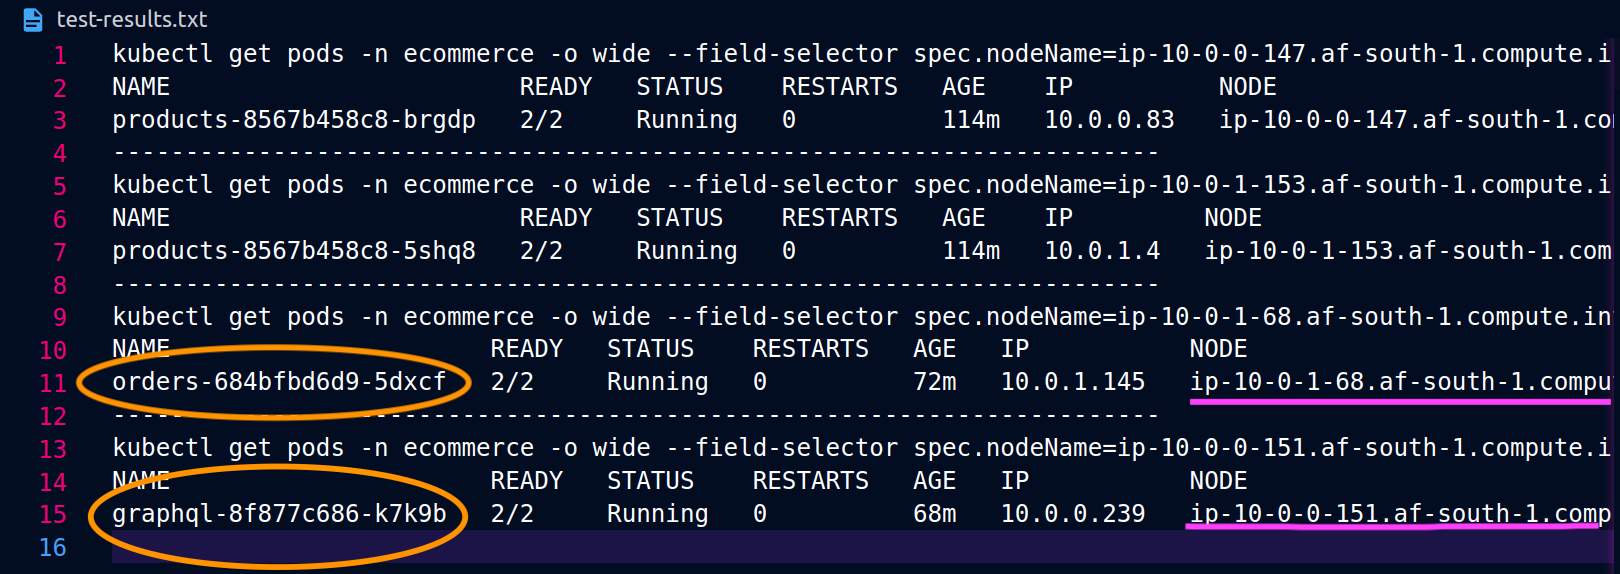
Cuando las orders réplicas graphql y las réplicas no coexisten en el mismo nodo (ip-10-0-0-151.af-south-1.compute.internal), la primera solicitud de se realiza correctamente, como graphql se indica 200 response code en la captura de pantalla de Postman que aparece a continuación, mientras que la segunda solicitud anidada de a falla con un. graphql orders 503 response code

Recursos adicionales
-
Abordar la latencia y los costos de transferencia de datos en EKS con Istio
-
Cómo obtener visibilidad de los bytes de red de un Cross-AZ pod a otro de Amazon EKS
-
Optimice el tráfico de Arizona con un enrutamiento que tenga en cuenta la topología
-
Optimice los costos y el rendimiento de Kubernetes con la política de tráfico interno del servicio
-
Comprenda los costos de transferencia de datos para los servicios de contenedores de AWS
