Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
Streaming-Tabellen und S3-Bereitstellung für Amazon Kinesis Data Streams
Mit Amazon Kinesis Data Streams können Sie Streaming-Daten aus Ihren Kinesis-Datenstreams an zwei Zieltypen übertragen: Streaming-Tabellen auf Apache Iceberg (Amazon S3-Tabellen) oder Amazon S3-Buckets für allgemeine Zwecke. Sie müssen keine Infrastruktur verwalten und können innerhalb weniger Minuten mit der Bereitstellung beginnen. Amazon Kinesis Data Streams liest aus Ihrem Stream, puffert und aggregiert Datensätze und liefert sie an Ihr konfiguriertes Ziel. Die Bereitstellung erfolgt vollständig — es müssen keine Konnektoren, Verbraucheranwendungen oder Rechenressourcen bereitgestellt werden.
Diese Funktionen werden für Streams unterstützt, die im On-Demand Advantage- oder On-Demand Standard-Kapazitätsmodus ausgeführt werden. Sie konfigurieren die Zustellung von Ihrem Stream aus und geben ein Ziel an. Amazon Kinesis Data Streams kümmert sich dann automatisch um Skalierung, Wiederholungsversuche und Lieferzuverlässigkeit. Die Bereitstellung verbraucht nicht den Lesedurchsatz Ihres Streams und hat keine Auswirkungen auf bestehende Verbraucher.
Themen
So funktioniert die Datenbereitstellung
Die Datenbereitstellung verbindet Ihren Kinesis-Datenstrom über eine verwaltete Pipeline mit einem Lieferziel:
Sie veröffentlichen Daten in einem Kinesis-Datenstream im On-Demand Modus.
Sie rufen den Stream
CreateChannelauf und geben ein Ziel an (Streaming-Tabellen auf Apache Iceberg oder einen Amazon S3-Bucket für allgemeine Zwecke).Die Übertragung liest aus dem Stream, puffert Datensätze und aggregiert sie in Dateien mit optimaler Größe.
Die Lieferung schreibt die Dateien innerhalb des von Ihnen angegebenen Datenaktualisierungsfensters an Ihr konfiguriertes Ziel.
Ziele der Lieferung
Die Datenübermittlung unterstützt zwei Zieltypen:
- Streaming-Tabellen auf Apache Iceberg
-
Streaming-Tabellen liefern Ihren Kinesis-Datenstream kontinuierlich in Apache Iceberg-Tabellen, die in Amazon S3-Tabellen gespeichert sind. Sobald Daten ankommen, werden sie automatisch in das optimierte Apache Parquet-Format mit intelligenter Inline-Komprimierung konvertiert, wodurch das Problem kleiner Dateien beseitigt und die Kosten für nachgelagerte Abfragen reduziert werden. Innerhalb weniger Minuten nach der Veröffentlichung in Ihrem Stream können Daten über Amazon Athena, Amazon EMR, Amazon Managed Service for Apache Flink oder eine andere Engine, die Apache Iceberg unterstützt, abgefragt werden.
- Amazon S3-Buckets für allgemeine Zwecke
-
Die Amazon S3-Bereitstellung schreibt Streaming-Daten aus Ihrem Kinesis-Datenstream direkt in einen S3-Bucket. Datensätze werden in ihrem ursprünglichen Quellformat geliefert, ohne dass eine Transformation angewendet wird. Mehrere Datensätze werden gepuffert und zu Objekten mit optimaler Größe zusammengefasst, wobei die Komprimierung und eine S3-Schlüsselstruktur, die Sie mithilfe der Ausgabeschlüsselvorlage definieren, konfigurierbar sind. Dies ist ideal für Anwendungsfälle wie die Archivierung von Rohprotokollen, die Wiedergabe von Ereignissen und die nachgelagerte Stapelverarbeitung, bei denen Sie eine dauerhafte, kostengünstige Speicherung Ihrer Streaming-Daten benötigen, ohne den Aufwand für die Verwaltung einer Bereitstellungspipeline übernehmen zu müssen.
Datenfluss
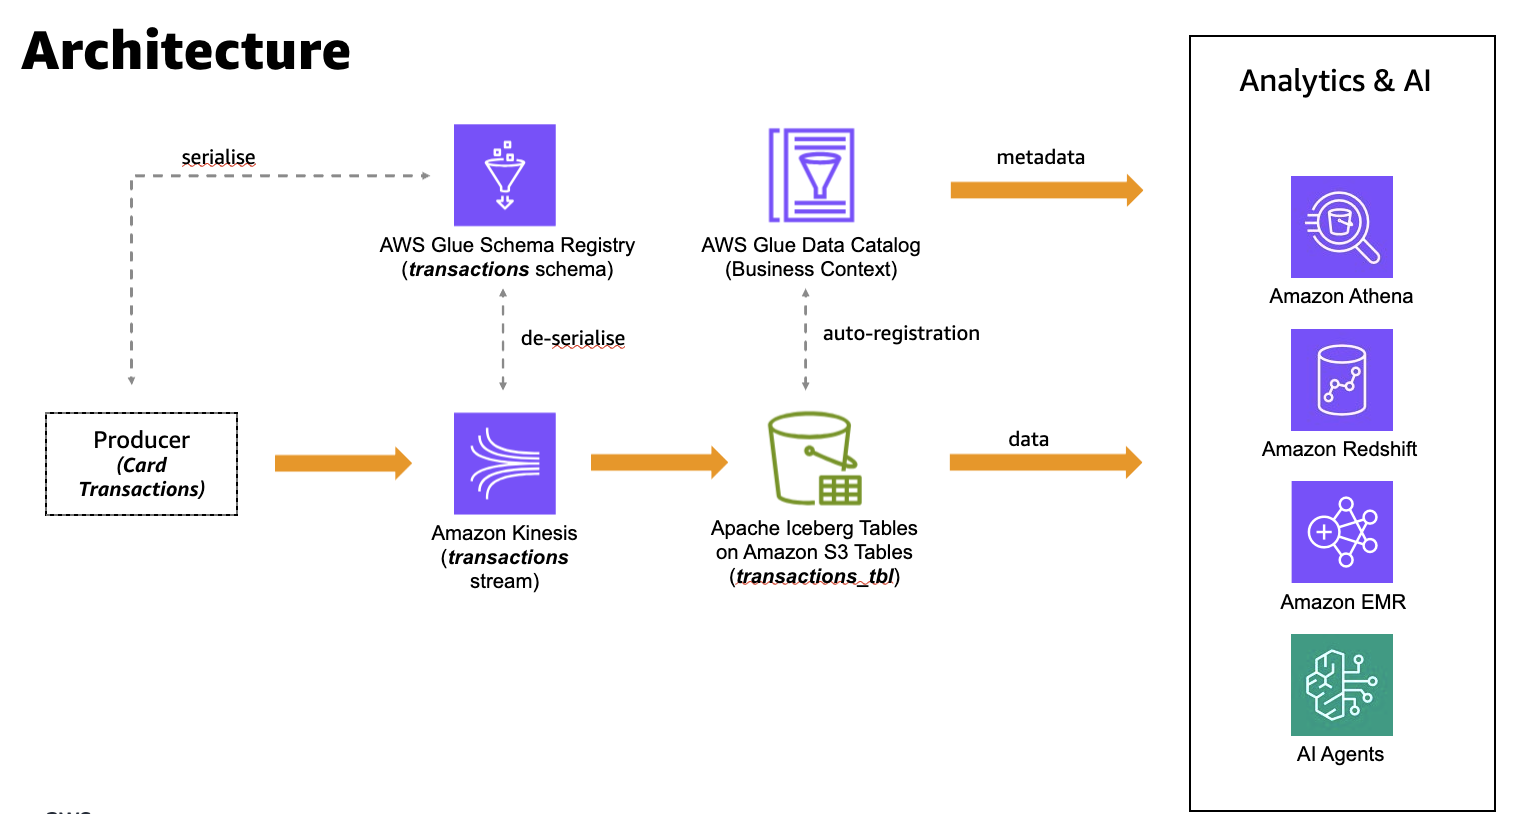
Das folgende Diagramm zeigt einen durchgängigen Datenfluss für die Bereitstellung an Streaming-Tabellen auf Apache Iceberg. Das Diagramm verwendet als Beispiel einen Anwendungsfall für Kartentransaktionen. Ein Producer serialisiert Datensätze anhand eines Schemas in AWS Glue Schema Registry und schreibt sie in einen Kinesis-Datenstrom. Amazon Kinesis Data Streams übermittelt die Datensätze an Apache Iceberg-Tabellen in Amazon S3-Tabellen. Wenn Sie die Analyseintegration in S3-Tabellen aktivieren, werden die Tabellenmetadaten auch im AWS Glue Datenkatalog registriert. Dies ist nicht standardmäßig der Fall. Die gelieferten Daten und ihre Metadaten sind dann für Analyse- und KI-Engines wie Amazon Athena, Amazon Redshift und Amazon EMR verfügbar.
Die Lieferung an Amazon S3-Buckets für allgemeine Zwecke erfolgt nach einem ähnlichen Ablauf, mit zwei Unterschieden. Ein Producer schreibt Datensätze in einen Kinesis-Datenstream, und Amazon Kinesis Data Streams liefert sie an Ihren S3-Bucket. Datensätze werden in ihrem ursprünglichen Quellformat ohne Konvertierung geliefert, sodass keine AWS Glue Schemaregistrierung erforderlich ist und keine Tabellenmetadaten im AWS Glue Datenkatalog registriert werden. Amazon Kinesis Data Streams puffert und stapelt Datensätze in Objekte mit optimaler Größe und schreibt sie mithilfe der S3-Schlüsselstruktur, die Sie in der Ausgabeschlüsselvorlage definieren. Die gelieferten Objekte stehen dann für die nachgelagerte Stapelverarbeitung und Analyse zur Verfügung.
Wichtigste Funktionen
Serverlose automatische Skalierung — Skaliert automatisch mit Ihrem Stream-Durchsatz bis zur Durchsatzkapazität des Streams. Es müssen keine Rechenressourcen bereitgestellt werden.
Exactly-once Bereitstellung pro Shard — Datensätze von einem Shard werden genau einmal an das Ziel übermittelt, ohne Duplikate oder Auslassungen innerhalb des Shards.
Bereitstellung nahezu in Echtzeit — Konfigurierbare Datenaktualität von 5 bis 15 Minuten (300 bis 900 Sekunden).
Automatische Parquet-Konvertierung — Konvertiert Streaming-Tabellen auf Apache Iceberg in das optimierte Apache Parquet-Format für effiziente Analyseabfragen.
Inline-Komprimierung — Aggregiert Datensätze in Dateien mit optimaler Größe, um die Leistung von Analyseabfragen zu gewährleisten.
Verschlüsselung — Unterstützt vom Kunden verwaltete AWS KMS Schlüssel für die serverseitige Verschlüsselung am Zielort. Der Von AWS verwalteter Schlüssel (der
aws/kinesisAlias) wird für die Zielverschlüsselung nicht unterstützt.Dead-letter Warteschlange — Fehlermetadaten für Datensätze, die nicht übermittelt werden können — einschließlich Stream-ARN, Shard-ID, Sequenznummer und Fehlerkontext — werden in eine Warteschlange mit unlesbaren S3-based Buchstaben geschrieben.
CloudWatch Metriken und Protokolle — Überwachen Sie die übermittelten Byte, die Anzahl der Datensätze und die Aktualität der Daten mithilfe von Amazon-Metriken. CloudWatch Aktivieren Sie die Versandprotokollierung in Amazon CloudWatch Logs, um Details zum Versandstapel, Fehler und den Fehlerkontext zur Problembehandlung zu erfassen.
Keine Auswirkungen auf andere Verbraucher — Nutzt keine erweiterten Fan-Out-Steckplätze oder gemeinsamen Durchsatz.
Voraussetzungen
Ihr Kinesis-Datenstream muss den Kapazitätsmodus On-Demand Standard oder On-Demand Advantage verwenden.
Sie müssen eine Rolle zur Ausführung des IAM-Service erstellen, die die Übermittlungsberechtigungen zum Schreiben an Ihr Ziel erteilt.
Ihr Ziel-Bucket oder Tabellen-Bucket muss sich in derselben Region wie Ihr Kinesis-Datenstream befinden. Die Datenübermittlung unterstützt für keinen der Zieltypen die regionsübergreifende Bereitstellung.
Für Streaming-Tabellen auf Apache Iceberg wird die kontoübergreifende Bereitstellung nicht unterstützt. Der Quellstream, der Ziel-S3-Tabellen-Bucket und die AWS Glue Schemaregistrierung müssen sich alle in derselben AWS-Konto Region befinden.
Bei Amazon S3-Buckets für allgemeine Zwecke wird die kontoübergreifende Zustellung nur für den Ziel-Bucket unterstützt. Der Kanal und sein Quell-Stream müssen sich im selben Konto befinden AWS-Konto; nur der Ziel-Bucket kann sich in einem anderen Konto befinden.
Für Streaming-Tabellen auf Apache Iceberg müssen Sie in Amazon S3 eine Warteschlange mit unleserlichen Buchstaben konfigurieren.
