Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
Cluster-Cache-Verwaltung
Caching ist eine der wichtigsten Funktionen jeder Datenbank (DB), da sie dazu beiträgt, den Speicherplatz zu reduzieren. I/O Die Daten, auf die am häufigsten zugegriffen wird, werden in einem Speicherbereich gespeichert, der als Puffercache bezeichnet wird. Wenn eine Abfrage häufig ausgeführt wird, ruft sie die Daten direkt aus dem Cache statt von der Festplatte ab. Dies ist schneller und bietet eine bessere Skalierbarkeit und Anwendungsleistung. Sie konfigurieren die PostgreSQL-Cachegröße mit dem Parameter shared_buffers. Weitere Informationen finden Sie in Arbeitsspeicher
Nach einem Failover ist das Cluster-Cache-Management (CCM) in Amazon Aurora PostgreSQL-Compatible Edition darauf ausgelegt, die Leistung der Anwendungs- und Datenbankwiederherstellung zu verbessern. In einer typischen Failover-Situation ohne CCM kann es zu einer vorübergehenden, aber erheblichen Leistungsverschlechterung kommen. Das ist darauf zurückzuführen, dass der Puffercache beim Start der Failover-DB-Instance leer ist. Ein leerer Cache wird auch als kalter Cache bezeichnet. Die DB-Instance muss von der Festplatte lesen, was langsamer ist als das Lesen aus dem Cache.
Wenn Sie CCM implementieren, wählen Sie eine bevorzugte Reader-DB-Instance, und CCM synchronisiert kontinuierlich seinen Cache-Speicher mit dem des Primärspeichers oder der Writer-DB-Instance. Wenn ein Failover auftritt, wird die bevorzugte Reader-DB-Instance zur neuen Writer-DB-Instance heraufgestuft. Weil sie bereits über einen Cache-Speicher verfügt, der als warmer Cache bekannt ist, werden die Auswirkungen des Failovers auf die Anwendungsleistung minimiert.
Wie funktioniert die Cluster-Cache-Verwaltung?
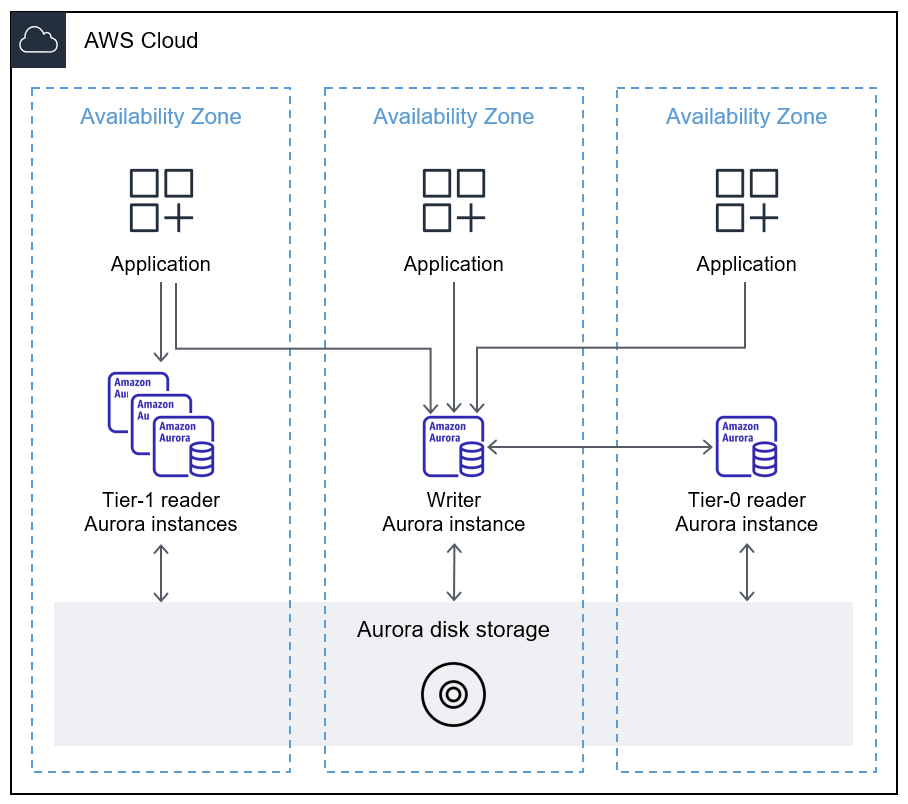
Failover-DB-Instances befinden sich in anderen Availability Zones als die primäre Writer-DB-Instance. Die bevorzugte Reader-DB-Instance ist das vorrangige Failover-Ziel, das durch Zuweisung der Prioritätsstufe Tier-0 festgelegt wird.
Anmerkung
Die Prioritätsstufe für das Hochstufen gibt die Reihenfolge an, in der ein Aurora-Reader nach einem Ausfall zur Writer-DB-Instance hochgestuft wird. Gültige Werte sind 0 – 15, wobei 0 die erste und 15 die letzte Prioritätsstufe darstellt. Weitere Informationen über die Beförderungsstufe finden Sie unter Fehlertoleranz für einen Aurora-DB-Cluster. Eine Änderung der Beförderungsstufe führt nicht zu einem Ausfall.
CCM synchronisiert den Cache von der Writer-DB-Instance zur bevorzugten Reader-DB-Instance. Die Reader-DB-Instance sendet den Satz von Pufferadressen, die derzeit zwischengespeichert sind, als Bloom-Filter an die Writer-DB-Instance. Ein Bloom-Filter ist eine probabilistische, speichereffiziente Datenstruktur, mit der getestet wird, ob ein Element Teil einer Menge ist. Die Verwendung eines Bloom-Filters verhindert, dass die Reader-DB-Instance wiederholt dieselben Pufferadressen an die Writer-DB-Instance sendet. Wenn die Writer-DB-Instance den Bloom-Filter empfängt, vergleicht sie die Blöcke in ihrem Puffercache und sendet häufig verwendete Puffer an die Reader-DB-Instance. Standardmäßig gilt ein Puffer als häufig verwendet, wenn er eine Nutzungszahl von mehr als drei hat.
Das folgende Diagramm zeigt, wie CCM den Puffercache der Writer-DB-Instance mit der bevorzugten Reader-DB-Instance synchronisiert.
Weitere Informationen zu CCM finden Sie unter Schnelle Wiederherstellung nach einem Failover mit Cluster-Cache-Management für Aurora PostgreSQL (Aurora-Dokumentation) und Einführung in die Aurora PostgreSQL-Cluster-Cache-Verwaltung
Einschränkungen
Das CCM-Feature hat die folgenden Einschränkungen:
-
Die Reader-DB-Instance muss denselben DB-Instanceklassentyp und dieselbe Größe haben wie die Writer-DB-Instance, z. B.
r5.2xlargeoderdb.r5.xlarge. -
CCM wird für Aurora-PostgreSQL-DB-Cluster, die Teil der globalen Aurora-Datenbanken sind, nicht unterstützt.
Anwendungsfälle für Cluster-Cache-Verwaltung
In einigen Branchen, wie dem Einzelhandel, dem Bankwesen und dem Finanzwesen, können Verzögerungen von nur wenigen Millisekunden zu Leistungseinbußen der Anwendungen und zu erheblichen Geschäftsverlusten führen. Da CCM zur Wiederherstellung der Anwendungs- und Datenbankleistung beiträgt, indem es den Puffercache der primären Datenbank-Instance kontinuierlich mit der bevorzugten Backup-Instance synchronisiert, kann es dazu beitragen, Geschäftsverluste im Zusammenhang mit Failovers zu verhindern.
