Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
Automatische semantische Anreicherung für Serverless
-Übersicht
Die automatische Funktion zur semantischen Anreicherung kann dazu beitragen, die Suchrelevanz gegenüber der lexikalischen Suche um bis zu 20% zu verbessern. Durch die automatische semantische Anreicherung entfällt der undifferenzierte Aufwand, der mit der Verwaltung Ihrer eigenen ML-Modellinfrastruktur (maschinelles Lernen) und der Integration in die Suchmaschine verbunden ist. Die Funktion ist für alle drei serverlosen Sammlungstypen verfügbar: Search, Time Series und Vector.
Konzepte der semantischen Suche
Herkömmliche Suchmaschinen verwenden Wort-to-Wort-Matches (die sogenannte lexikalische Suche), um Ergebnisse für Suchanfragen zu finden. Dies funktioniert zwar gut für bestimmte Abfragen wie Modellnummern von Fernsehgeräten, liefert aber bei abstrakteren Suchanfragen möglicherweise keine relevanten Ergebnisse. Wenn Sie beispielsweise nach „Schuhe für den Strand“ suchen, werden bei einer lexikalischen Suche lediglich einzelne Wörter wie „Schuhe“, „Strand“, „für“ und „der“ in den Katalogartikeln abgeglichen, sodass möglicherweise relevante Produkte wie „wasserfeste Sandalen“ oder „Surfschuhe“ fehlen, die nicht die exakten Suchbegriffe enthalten.
Die semantische Suche gibt Abfrageergebnisse zurück, die nicht nur die Suche nach Schlüsselwörtern, sondern auch die Absicht und die kontextuelle Bedeutung der Suche des Benutzers berücksichtigen. Wenn ein Benutzer beispielsweise nach „Wie behandelt man Kopfschmerzen“ sucht, liefert ein semantisches Suchsystem möglicherweise die folgenden Ergebnisse:
-
Heilmittel gegen Migräne
-
Techniken zur Schmerzbehandlung
-
Over-the-counter Schmerzmittel
Modelldetails und Leistungsbenchmark
Obwohl diese Funktion die technischen Probleme hinter den Kulissen bewältigt, ohne das zugrunde liegende Modell preiszugeben, helfen Ihnen die folgende Modellbeschreibung und die Benchmark-Ergebnisse dabei, fundierte Entscheidungen über die Einführung von Funktionen bei Ihren kritischen Workloads zu treffen.
Bei der automatischen semantischen Anreicherung wird ein vom Service verwaltetes, vorab trainiertes Sparse-Modell verwendet, das effektiv funktioniert, ohne dass eine individuelle Feinabstimmung erforderlich ist. Das Modell analysiert die von Ihnen angegebenen Felder und erweitert sie zu Vektoren mit geringer Dichte, die auf erlernten Assoziationen aus verschiedenen Trainingsdaten basieren. Die erweiterten Terme und ihre Signifikanzgewichte werden im systemeigenen Lucene-Indexformat gespeichert, sodass sie effizient abgerufen werden können. Wir haben diesen Prozess im Modus „Nur Dokumente“ optimiert
Bei der Leistungsvalidierung während der Feature-Entwicklung wurde der MS MARCO-Datensatz zum Abrufen von
-
Englische Sprache — Verbesserung der Relevanz um 20% gegenüber der lexikalischen Suche. Außerdem wurde die Latenz bei der P90-Suche im Vergleich zur lexikalischen Suche um 7,7% gesenkt (BM25 beträgt 26 ms und die automatische semantische Anreicherung 24 ms).
-
Multi-lingual - Im Vergleich zur lexikalischen Suche wurde die Relevanz um 105% verbessert, wohingegen die Latenz bei der P90-Suche im Vergleich zur lexikalischen Suche um 38,4% zunahm (BM25 beträgt 26 ms und die automatische semantische Anreicherung 36 ms).
Da jeder Workload einzigartig ist, können Sie diese Funktion in Ihrer Entwicklungsumgebung anhand Ihrer eigenen Benchmarking-Kriterien evaluieren, bevor Sie Implementierungsentscheidungen treffen.
Unterstützte Sprachen
Die Funktion unterstützt Englisch. Darüber hinaus unterstützt das Modell auch Arabisch, Bengali, Chinesisch, Finnisch, Französisch, Hindi, Indonesisch, Japanisch, Koreanisch, Persisch, Russisch, Spanisch, Suaheli und Telugu.
Richten Sie einen automatischen semantischen Anreicherungsindex für serverlose Sammlungen ein
Sie können bei der Erstellung eines neuen Indexes über die Konsole, APIs und CloudFormation Vorlagen einen Index einrichten, bei dem die automatische semantische Anreicherung für Ihre Textfelder aktiviert ist. Um ihn für einen vorhandenen Index zu aktivieren, müssen Sie den Index neu erstellen, wobei die automatische semantische Anreicherung für Textfelder aktiviert ist.
Mit der AWS Konsole können Sie einen Index mit Feldern für die automatische semantische Anreicherung erstellen. Nachdem Sie eine Sammlung ausgewählt haben, finden Sie oben in der Konsole die Schaltfläche Index erstellen. Nachdem Sie Index erstellen ausgewählt haben, bietet die Konsole Optionen zur Definition automatischer semantischer Anreicherungsfelder. In einem Index können Sie Kombinationen aus automatischer semantischer Anreicherung für englische und mehrsprachige Felder sowie lexikalische Felder verwenden.
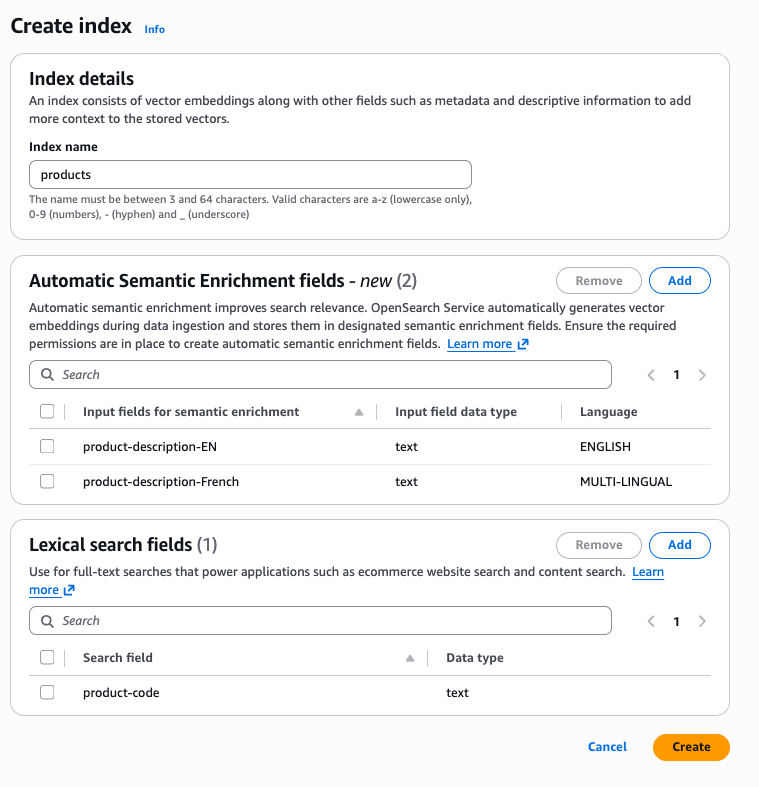
Verwenden Sie den Befehl create-index, um mithilfe der AWS Befehlszeilenschnittstelle (AWS CLI) einen automatischen Index für die semantische Anreicherung zu erstellen:
aws opensearchserverless create-index \
--id [collection_id] \
--index-name [index_name] \
--index-schema [index_body] \
Im folgenden Beispiel für ein Indexschema ist für das title_semantic Feld der Feldtyp auf festgelegt, text und der Parameter ist auf status gesetzt. semantic_enrichment ENABLED Durch das Setzen des semantic_enrichment Parameters wird die automatische semantische Anreicherung des Felds aktiviert. title_semantic Sie können das language_options Feld verwenden, um entweder oder english anzugeben. multi-lingual
    aws opensearchserverless create-index \
    --id XXXXXXXXX \
    --index-name 'product-catalog' \
    --index-schema '{
    "mappings": {
        "properties": {
            "product_id": {
                "type": "keyword"
            },
            "title_semantic": {
                "type": "text",
                "semantic_enrichment": {
                    "status": "ENABLED",
                    "language_options": "english"
                }
            },
            "title_non_semantic": {
                "type": "text"
            }
        }
    }
}'
Verwenden Sie den folgenden Befehl, um den erstellten Index zu beschreiben:
aws opensearchserverless get-index \
--id [collection_id] \
--index-name [index_name] \
Sie können auch CloudFormation Vorlagen (Type:AWS:::OpenSearchServerless:CollectionIndex) verwenden, um eine semantische Suche während der Sammlungsbereitstellung sowie nach der Erstellung der Sammlung zu erstellen.
Aktualisieren Sie einen vorhandenen Index
Sie können einen vorhandenen Index aktualisieren, um neue Felder für die semantische Anreicherung hinzuzufügen, die semantische Anreicherung vorhandener Felder zu aktivieren oder zu deaktivieren oder nicht-semantische Textfelder hinzuzufügen. Verwenden Sie den update-index Befehl und geben Sie nur die Felder an, die Sie in der ändern möchten. index-schema Felder, die nicht in der Anfrage enthalten sind, bleiben unverändert.
Anmerkung
Der Index settings kann nicht aktualisiert werden. Wenn Sie einen settings Block in die Anforderung aufnehmen, gibt der Vorgang einen Validierungsfehler zurück. Um die Indexeinstellungen zu ändern, müssen Sie den Index löschen und neu erstellen.
Um einen Index mithilfe von zu aktualisieren AWS CLI, verwenden Sie den update-index folgenden Befehl:
aws opensearchserverless update-index \
--id [collection_id] \
--index-name [index_name] \
--index-schema [index_body]
Fügen Sie ein neues Feld für semantische Anreicherung hinzu
Sie können einem vorhandenen Index ein neues text Feld hinzufügen, für das die semantische Anreicherung aktiviert ist. Der Service richtet automatisch das erforderliche ML-Modell, die Ingest-Pipeline und die Suchpipeline ein. Neue Dokumente, die nach dem Update indexiert werden, werden automatisch angereichert.
Wichtig
Bestehende Dokumente werden nicht nachgefüllt. Um das Feld für die semantische Anreicherung vorhandener Dokumente auszufüllen, müssen Sie diese nach der Aktualisierung erneut aufnehmen. Bestehende Dokumente profitieren nicht von der semantischen Suche im neuen Feld, bis sie erneut aufgenommen werden.
aws opensearchserverless update-index \
--id my-collection-id \
--index-name product-catalog \
--index-schema '{
    "mappings": {
        "properties": {
            "description": {
                "type": "text",
                "semantic_enrichment": {
                    "status": "ENABLED",
                    "language_options": "english"
                }
            }
        }
    }
}'
Deaktivieren Sie die semantische Anreicherung für ein Feld
Um die semantische Anreicherung für ein Feld zu deaktivieren, für das sie derzeit aktiviert ist, setzen Sie auf. status DISABLED Das Feld wird aus den Ingest- und Such-Pipelines entfernt. Das zugrunde liegende Textfeld und sein Einbettungsfeld verbleiben im Index, werden aber nicht mehr angereichert.
aws opensearchserverless update-index \
--id my-collection-id \
--index-name product-catalog \
--index-schema '{
    "mappings": {
        "properties": {
            "title_semantic": {
                "type": "text",
                "semantic_enrichment": {
                    "status": "DISABLED"
                }
            }
        }
    }
}'
Einschränkungen aktualisieren
Die folgenden Operationen werden von Ihnen nicht unterstützt update-index und erfordern, dass Sie den Index löschen und neu erstellen:
-
Änderung
language_optionsan einem Feld, für das derzeit die semantische Anreicherung aktiviert ist. Deaktivieren Sie das Feld zuerst und aktivieren Sie es dann erneut mit der neuen Sprachoption. -
Aktualisierung verschachtelter Felder. Semantische Anreicherung wird nur für Felder der obersten
textEbene unterstützt. -
Index wird aktualisiert.
settings
Anmerkung
Wenn der Index über eine benutzerdefinierte Ingest- oder Suchpipeline verfügt, die nicht durch automatische semantische Anreicherung erstellt wurde, wird der Aktualisierungsvorgang blockiert. Entfernen Sie die benutzerdefinierte Pipeline, bevor Sie Felder für die semantische Anreicherung hinzufügen.
Datenaufnahme und Suche
Nachdem Sie einen Index mit aktivierter automatischer semantischer Anreicherung erstellt haben, funktioniert die Funktion automatisch während des Datenaufnahmeprozesses, ohne dass eine zusätzliche Konfiguration erforderlich ist.
Datenaufnahme: Wenn Sie Dokumente zu Ihrem Index hinzufügen, geht das System automatisch wie folgt vor:
-
Analysiert die Textfelder, die Sie für die semantische Anreicherung vorgesehen haben
-
Generiert semantische Kodierungen mithilfe OpenSearch des vom Service verwalteten Sparse-Modells
-
Speichert diese angereicherten Darstellungen zusammen mit Ihren Originaldaten
Bei diesem Prozess werden OpenSearch die integrierten ML-Konnektoren und Ingest-Pipelines verwendet, die im Hintergrund automatisch erstellt und verwaltet werden.
Suche: Die Daten zur semantischen Anreicherung sind bereits indexiert, sodass Abfragen effizient ausgeführt werden, ohne das ML-Modell erneut aufrufen zu müssen. Das bedeutet, dass Sie eine verbesserte Suchrelevanz ohne zusätzlichen Aufwand für die Suchlatenz erhalten.
Konfiguration von Berechtigungen für die automatische semantische Anreicherung
Bevor Sie einen automatisierten Index für die semantische Anreicherung erstellen, müssen Sie die erforderlichen Berechtigungen konfigurieren. In diesem Abschnitt werden die erforderlichen Berechtigungen und deren Einrichtung erläutert.
Berechtigungen nach IAM-Richtlinien
Verwenden Sie die folgende AWS Identity and Access Management (IAM-) Richtlinie, um die erforderlichen Berechtigungen für die Arbeit mit der automatischen semantischen Anreicherung zu gewähren:
- Wichtige Berechtigungen
-
-
Die
aoss:*IndexBerechtigungen ermöglichen die Indexverwaltung -
Die
aoss:APIAccessAllErlaubnis ermöglicht OpenSearch API-Operationen -
Um die Berechtigungen auf eine bestimmte Sammlung einzuschränken,
"Resource": "*"ersetzen Sie sie durch den ARN der Sammlung
-
Konfigurieren Sie Datenzugriffsberechtigungen
Um einen Index für die automatische semantische Anreicherung einzurichten, müssen Sie über entsprechende Datenzugriffsrichtlinien verfügen, die die Berechtigung zum Zugriff auf Index-, Pipeline- und Modellsammlungsressourcen gewähren. Weitere Informationen zu Datenzugriffsrichtlinien finden Sie unter. Datenzugriffskontrolle für Amazon OpenSearch Serverless Das Verfahren zum Konfigurieren einer Datenzugriffsrichtlinie finden Sie unterErstellen von Datenzugriffsrichtlinien (Konsole).
Datenzugriffsberechtigungen
[
    {
        "Description": "Create index permission",
        "Rules": [
            {
                "ResourceType": "index",
                "Resource": ["index/collection_name/*"],
                "Permission": [
                  "aoss:CreateIndex",
                  "aoss:DescribeIndex",
                  "aoss:UpdateIndex",
                  "aoss:DeleteIndex"
                ]
            }
        ],
        "Principal": [
            "arn:aws:iam::account_id:role/role_name"
        ]
    },
    {
        "Description": "Create pipeline permission",
        "Rules": [
            {
                "ResourceType": "collection",
                "Resource": ["collection/collection_name"],
                "Permission": [
                  "aoss:CreateCollectionItems",
                  "aoss:DescribeCollectionItems"
                ]
            }
        ],
        "Principal": [
            "arn:aws:iam::account_id:role/role_name"
        ]
    },
    {
        "Description": "Create model permission",
        "Rules": [
            {
                "ResourceType": "model",
                "Resource": ["model/collection_name/*"],
                "Permission": ["aoss:CreateMLResource"]
            }
        ],
        "Principal": [
            "arn:aws:iam::account_id:role/role_name"
        ]
    },
]
Zugriffsberechtigungen für das Netzwerk
Damit Service-APIs auf private Sammlungen zugreifen können, müssen Sie Netzwerkrichtlinien konfigurieren, die den erforderlichen Zugriff zwischen der Service-API und der Sammlung zulassen. Weitere Informationen zu Netzwerkrichtlinien finden Sie unter Netzwerkzugriff für Amazon OpenSearch Serverless.
[
   {
      "Description":"Enable automatic semantic enrichment in a private collection",
      "Rules":[
         {
            "ResourceType":"collection",
            "Resource":[
               "collection/collection_name"
            ]
         }
      ],
      "AllowFromPublic":false,
      "SourceServices":[
         "aoss.amazonaws.com"
      ],
   }
]
Um Netzwerkzugriffsberechtigungen für eine private Sammlung zu konfigurieren
-
Melden Sie sich bei der OpenSearch Servicekonsole unter an https://console.aws.amazon.com/aos/home
. -
Wählen Sie im linken Navigationsbereich Netzwerkrichtlinien aus. Führen Sie dann einen der folgenden Schritte aus:
-
Wählen Sie einen vorhandenen Richtliniennamen und klicken Sie auf Bearbeiten
-
Wählen Sie Netzwerkrichtlinie erstellen und konfigurieren Sie die Richtliniendetails
-
-
Wählen Sie im Bereich Zugriffstyp die Option Privat (empfohlen) und anschließend AWS Dienstzugriff aus.
-
Wählen Sie im Suchfeld Service und dann aoss.amazonaws.com aus.
-
Wählen Sie im Bereich Ressourcentyp das Kontrollkästchen Zugriff auf Endpunkt aktivieren aus. OpenSearch
-
Wählen Sie unter Sammlung (en) durchsuchen oder bestimmte Präfixbegriffe eingeben in das Suchfeld die Option Sammlungsname aus. Geben Sie dann den Namen der Sammlungen ein, die der Netzwerkrichtlinie zugeordnet werden sollen, oder wählen Sie ihn aus.
-
Wählen Sie Erstellen für eine neue Netzwerkrichtlinie oder Aktualisieren für eine vorhandene Netzwerkrichtlinie.
Unterstützt AWS-Regionen
Die automatische semantische Anreicherung für OpenSearch Serverless ist in den folgenden Bereichen verfügbar: AWS-Regionen
USA Ost (Nord-Virginia)
USA Ost (Ohio)
USA West (Oregon)
Asien-Pazifik (Mumbai)
Asien-Pazifik (Singapur)
Asien-Pazifik (Sydney)
Asien-Pazifik (Tokio)
Europe (Frankfurt)
Europa (Irland)
Europa (Stockholm)
Europa (Spain)
Abfragen werden neu geschrieben
Die automatische semantische Anreicherung wandelt Ihre vorhandenen „Match“ -Abfragen automatisch in semantische Suchanfragen um, ohne dass Änderungen an der Abfrage erforderlich sind. Wenn eine Übereinstimmungsabfrage Teil einer zusammengesetzten Abfrage ist, durchläuft das System Ihre Abfragestruktur, findet Übereinstimmungsabfragen und ersetzt sie durch neuronale Abfragen mit geringer Dichte. Derzeit unterstützt die Funktion nur das Ersetzen von „Match“ -Abfragen, unabhängig davon, ob es sich um eine eigenständige Abfrage oder um einen Teil einer zusammengesetzten Abfrage handelt. „multi_match“ wird nicht unterstützt. Darüber hinaus unterstützt die Funktion alle zusammengesetzten Abfragen, um ihre verschachtelten Übereinstimmungsabfragen zu ersetzen. Zu den zusammengesetzten Abfragen gehören: bool, boost, constant_score, dis_max, function_score und hybrid.
Einschränkungen der automatischen semantischen Anreicherung
Die automatische semantische Suche ist am effektivsten, wenn sie auf kleine bis mittelgroße Felder angewendet wird, die Inhalte in natürlicher Sprache wie Filmtitel, Produktbeschreibungen, Rezensionen und Zusammenfassungen enthalten. Obwohl die semantische Suche in den meisten Anwendungsfällen die Relevanz erhöht, ist sie für bestimmte Szenarien möglicherweise nicht optimal. Beachten Sie die folgenden Einschränkungen, wenn Sie entscheiden, ob Sie die automatische semantische Anreicherung für Ihren speziellen Anwendungsfall implementieren möchten.
-
Sehr lange Dokumente — Das aktuelle Modell mit geringer Dichte verarbeitet nur die ersten 8.192 Zeichen jedes Dokuments für Englisch. Bei mehrsprachigen Dokumenten sind es 512 Token. Bei langen Artikeln sollten Sie erwägen, Document Chunking zu implementieren, um eine vollständige Inhaltsverarbeitung sicherzustellen.
-
Workloads für die Protokollanalyse — Durch die semantische Anreicherung wird die Indexgröße erheblich erhöht, was für Protokollanalysen, bei denen ein exakter Abgleich in der Regel ausreicht, möglicherweise nicht erforderlich ist. Der zusätzliche semantische Kontext verbessert selten die Effektivität der Protokollsuche genug, um die erhöhten Speicheranforderungen zu rechtfertigen.
-
Die automatische semantische Anreicherung ist mit der Funktion Abgeleitete Quellen nicht kompatibel.
Preisgestaltung
Amazon OpenSearch Service berechnet die automatische semantische Anreicherung auf der Grundlage von OpenSearch Recheneinheiten (OCUs), die bei der Generierung von Vektoren mit geringer Dichte zum Zeitpunkt der Indizierung verbraucht werden. Für die Textfelder, für die Sie die automatische semantische Anreicherung aktiviert haben, wird Ihnen während der Indizierung nur die tatsächliche Nutzung in Rechnung gestellt. Eine OCU für die semantische Suche kann 11,1 Millionen Token für englische Inhalte verarbeiten. Um 2,4 Milliarden Token zu verarbeiten, benötigen Sie etwa 216 Semantic Search OCU-hours (2,4 Milliarden/11,10 Millionen). Bei einem Preis von 0,24$ pro Semantic Search OCU-hour würden sich die Kosten für die Verarbeitung von 10 GB an Daten für die automatische semantische Suche auf 51$ (216 x 0$) belaufen. OCU-hours 24/OCU-Stunde). Bei Suchvorgängen oder für die Datenspeicherung fallen keine zusätzlichen OCU-Gebühren für die semantische Suche an.
Sie können diesen Verbrauch mithilfe der CloudWatch Amazon-Metrik überwachen. SemanticSearchOCU Genauere Informationen zu den Limits für Modell-Tokens, zum Volumendurchsatz pro OCU und ein Beispiel für eine Beispielberechnung finden Sie unter OpenSearch Servicepreise
