Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
Kostenoptimierung — Netzwerke
Die Architektur von Systemen für hohe Verfügbarkeit (HA) ist eine bewährte Methode, um Ausfallsicherheit und Fehlertoleranz zu gewährleisten. In der Praxis bedeutet dies, Ihre Workloads und die zugrunde liegende Infrastruktur auf mehrere Availability Zones (AZs) in einer bestimmten AWS-Region zu verteilen. Wenn Sie sicherstellen, dass diese Merkmale für Ihre Amazon EKS-Umgebung vorhanden sind, wird die allgemeine Zuverlässigkeit Ihres Systems verbessert. In Verbindung damit werden Ihre EKS-Umgebungen wahrscheinlich auch aus einer Vielzahl von Konstrukten (z. B. VPCs), Komponenten (z. B. ELBs) und Integrationen (z. B. ECR und andere Container-Registries) bestehen.
Die Kombination aus hochverfügbaren Systemen und anderen anwendungsfallspezifischen Komponenten kann eine wichtige Rolle bei der Übertragung und Verarbeitung von Daten spielen. Dies wird sich wiederum auf die Kosten auswirken, die durch die Datenübertragung und -verarbeitung entstehen.
Die unten aufgeführten Verfahren helfen Ihnen bei der Planung und Optimierung Ihrer EKS-Umgebungen, um die Wirtschaftlichkeit für verschiedene Bereiche und Anwendungsfälle zu erreichen.
Kommunikation von Pod zu Pod
Je nach Konfiguration können Netzwerkkommunikation und Datenübertragung zwischen Pods erhebliche Auswirkungen auf die Gesamtkosten für den Betrieb von Amazon EKS-Workloads haben. In diesem Abschnitt werden verschiedene Konzepte und Ansätze zur Minderung der Kosten im Zusammenhang mit der Kommunikation zwischen den Pods behandelt. Dabei werden Architekturen mit hoher Verfügbarkeit (HA), Anwendungsleistung und Ausfallsicherheit berücksichtigt.
Beschränkung des Datenverkehrs auf eine Availability Zone
Das Kubernetes-Projekt begann schon früh mit der Entwicklung topologieorientierter Konstrukte, einschließlich Bezeichnungen wie Kubernetes. io/hostname, topology.kubernetes. io/region, und topology.kubernetes. io/zone Knoten zugewiesen, um Funktionen wie die Verteilung der Arbeitslast auf mehrere Fehlerdomänen und topologieorientierte Volume Provisioner zu ermöglichen. Nach Abschluss des Studiums in Kubernetes 1.17 wurden die Labels auch genutzt, um topologieorientierte Routing-Funktionen für die Pod-to-Pod-Kommunikation zu ermöglichen.
Im Folgenden finden Sie einige Strategien zur Steuerung des Cross-AZ-Datenverkehrs zwischen Pods in Ihrem EKS-Cluster, um die Kosten zu senken und die Latenz zu minimieren.
Wenn Sie einen detaillierten Überblick über den Umfang des Cross-AZ-Datenverkehrs zwischen Pods in Ihrem Cluster wünschen (z. B. die Menge der übertragenen Daten in Byte), lesen Sie diesen Beitrag.
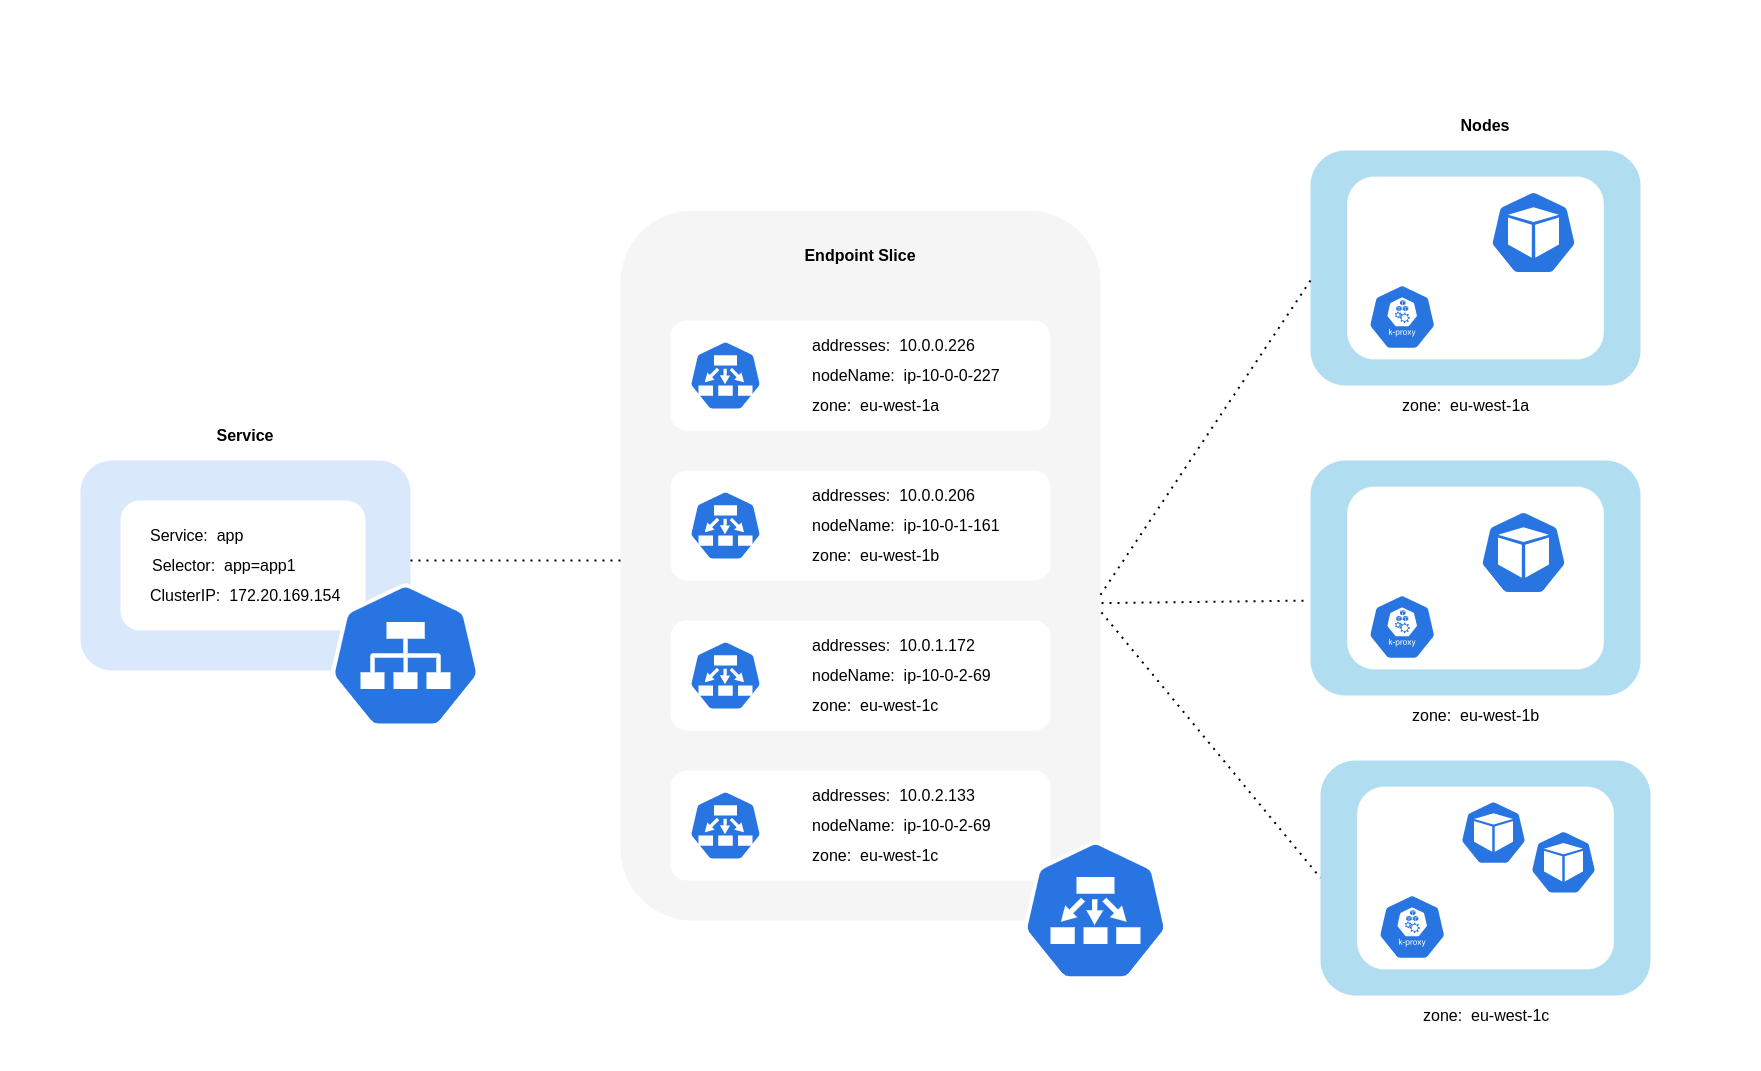
Wie das vorstehende Diagramm zeigt, sind Dienste die stabile Netzwerkabstraktionsebene, die den für Ihre Pods bestimmten Datenverkehr empfängt. Wenn ein Dienst erstellt wird, EndpointSlices werden mehrere erstellt. Jeder EndpointSlice hat eine Liste von Endpunkten, die eine Teilmenge von Pod-Adressen zusammen mit den Knoten, auf denen sie ausgeführt werden, und allen zusätzlichen Topologieinformationen enthält. Bei Verwendung des Amazon VPC CNI wird Kube-Proxy als Daemonset auf jedem Knoten ausgeführt. Es verwaltet Netzwerkregeln, um die Pod-Kommunikation und die Serviceerkennung zu ermöglichen. Alternative BPF-based E-CNIs verwenden möglicherweise keinen Kube-Proxy, bieten aber ein gleichwertiges Verhalten. Es erfüllt die Rolle des internen Routings, aber es tut dies auf der Grundlage dessen, was es von den erstellten Daten verbraucht. EndpointSlices
Auf Amazon EKS verwendet Kube-Proxy in erster Linie die NAT-Regeln von iptables (oder nftables, IPVS
Verwenden von topologieorientiertem Routing (früher bekannt als topologiebewusste Hinweise)
Wenn topologiebewusstes Routing aktiviert und in einem Kubernetes-Dienst implementiert kube-proxyleitet dann den Verkehr von einer Zone zu einem Endpunkt weiter, basierend auf den Hinweisen, die angewendet werden.
Das folgende Diagramm zeigt, wie EndpointSlices Hints so organisiert sind, dass anhand ihres zonalen Startpunkts ermittelt werden kube-proxy kann, zu welchem Ziel sie fahren sollten. Ohne Hinweise gibt es keine solche Zuordnung oder Organisation, und der Verkehr wird an verschiedene zonale Ziele weitergeleitet, unabhängig davon, woher er kommt.

In einigen Fällen wendet der EndpointSlice Controller möglicherweise einen Hinweis für eine andere Zone an, was bedeutet, dass der Endpunkt am Ende Datenverkehr aus einer anderen Zone verarbeiten könnte. Der Grund dafür ist der Versuch, eine gleichmäßige Verteilung des Datenverkehrs zwischen Endpunkten in verschiedenen Zonen aufrechtzuerhalten.
Im Folgenden finden Sie einen Codeausschnitt zur Aktivierung des topologiebewussten Routings für einen Service.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
  annotations:
    service.kubernetes.io/topology-mode: Auto
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
Der folgende Screenshot zeigt das Ergebnis, dass der EndpointSlice Controller erfolgreich einen Hinweis auf einen Endpunkt für ein Pod-Replikat angewendet hat, das in der AZ ausgeführt wird. eu-west-1a

Anmerkung
Es ist wichtig zu beachten, dass sich das topologiebewusste Routing noch in der Beta-Phase befindet. Diese Funktion funktioniert bei gleichmäßig verteilten Arbeitslasten in der Cluster-Topologie besser vorhersehbar, da der Controller die Endpunkte proportional zu den Zonen zuweist, Hinweiszuweisungen jedoch überspringt, wenn die Knotenressourcen in einer Zone zu unausgewogen sind, um eine übermäßige Überlastung zu vermeiden. Es wird daher dringend empfohlen, sie zusammen mit Zeitplanungseinschränkungen zu verwenden, die die Verfügbarkeit einer Anwendung erhöhen, wie z. B. Einschränkungen der Verteilung der Pod-Topologie. https://kubernetes.io/docs/concepts/scheduling-eviction/topology-spread-constraints/
Verwendung der Traffic-Verteilung
Traffic Distribution wurde in Kubernetes 1.30 eingeführt und in 1.33 allgemein verfügbar gemacht.
Im Folgenden finden Sie einen Codeausschnitt zur Aktivierung der Verkehrsverteilung für einen Dienst.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  trafficDistribution: PreferClose
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
Bei der Aktivierung der Verkehrsverteilung tritt eine häufig auftretende Herausforderung auf: Endpunkte innerhalb einer einzelnen AZ können überlastet werden, wenn der größte Teil des Datenverkehrs aus derselben Zone stammt. Diese Überlastung kann zu erheblichen Problemen führen:
-
Ein einzelner Horizontal Pod Autoscaler (HPA), der eine Multi-AZ-Bereitstellung verwaltet, kann darauf reagieren, indem Pods auf verschiedene AZs verteilt werden. Mit dieser Maßnahme wird der erhöhten Belastung in der betroffenen Zone jedoch nicht wirksam begegnet.
-
Diese Situation kann wiederum zu einer Ineffizienz der Ressourcen führen. Wenn Cluster-Autoscaler wie Karpenter das Pod-Scale-Out über verschiedene AZs hinweg erkennen, stellen sie möglicherweise zusätzliche Knoten in den nicht betroffenen AZs bereit, was zu unnötiger Ressourcenzuweisung führt.
Um diese Herausforderung zu bewältigen:
-
Erstellen Sie separate Bereitstellungen pro Zone, die über eigene HPAs verfügen, die unabhängig voneinander skaliert werden können.
-
Nutzen Sie Topology Spread Constraints, um die Verteilung der Arbeitslast auf den gesamten Cluster sicherzustellen und so eine Überlastung der Endpunkte in stark frequentierten Zonen zu verhindern.
Verwenden von Autoscalern: Stellen Sie Knoten für eine bestimmte AZ bereit
Wir empfehlen dringend, Ihre Workloads in hochverfügbaren Umgebungen über mehrere AZs hinweg auszuführen. Dies verbessert die Zuverlässigkeit Ihrer Anwendungen, insbesondere wenn es zu einem Problem mit einer AZ kommt. Falls Sie bereit sind, die Zuverlässigkeit zu opfern, um die Netzwerkkosten zu senken, können Sie Ihre Knoten auf eine einzige AZ beschränken.
Um alle Ihre Pods in derselben AZ auszuführen, stellen Sie entweder die Worker-Knoten in derselben AZ bereit oder planen Sie die Pods auf den Worker-Knoten ein, die in derselben AZ laufen. Um Knoten innerhalb einer einzelnen AZ bereitzustellen, definieren Sie mit Cluster Autoscaler (CA) eine Knotengruppe mit Subnetzen, die zu derselben AZ gehören. topology.kubernetes.io/zone und geben Sie sie an. Das unten stehende Provisioner-Snippet von Karpenter stellt beispielsweise die Knoten in der US-West-2A-AZ bereit.
Karpenter
apiVersion: karpenter.sh/v1
kind: Provisioner
metadata:
name: single-az
spec:
  requirements:

* key: "topology.kubernetes.io/zone"`
operator: In
values: ["us-west-2a"]
Cluster Autoscaler (CA)
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-ca-cluster
  region: us-east-1
  version: "1.21"
availabilityZones:

* us-east-1a
managedNodeGroups:
* name: managed-nodes
labels:
  role: managed-nodes
instanceType: t3.medium
minSize: 1
maxSize: 10
desiredCapacity: 1
...
Verwendung von Pod-Zuweisung und Node-Affinität
Wenn Sie Worker-Knoten haben, die in mehreren AZs ausgeführt werden, hätte alternativ jeder Knoten das Label topology.kubernetes. io/zonenodeAffinity für die Knoten in einer einzelnen AZ verwenden nodeSelector oder planen. Die folgende Manifestdatei plant beispielsweise den Pod in einem Knoten, der in AZ us-west-2a läuft.
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    env: test
spec:
  nodeSelector:
    topology.kubernetes.io/zone: us-west-2a
  containers:

* name: nginx
image: nginx
imagePullPolicy: IfNotPresent
Beschränkung des Datenverkehrs auf einen Knoten
Es gibt Fälle, in denen die Beschränkung des Datenverkehrs auf zonaler Ebene nicht ausreicht. Neben der Kostenreduzierung müssen Sie möglicherweise auch die Netzwerklatenz zwischen bestimmten Anwendungen reduzieren, die häufig miteinander kommunizieren. Um eine optimale Netzwerkleistung zu erzielen und die Kosten zu senken, benötigen Sie eine Möglichkeit, den Datenverkehr auf einen bestimmten Knoten zu beschränken. Beispielsweise sollte Microservice A immer mit Microservice B auf Knoten 1 kommunizieren, selbst in hochverfügbaren (HA) -Setups. Wenn Microservice A auf Knoten 1 mit Microservice B auf Knoten 2 kommuniziert, kann sich dies negativ auf die gewünschte Leistung für Anwendungen dieser Art auswirken, insbesondere wenn sich Knoten 2 in einer separaten AZ befindet.
Verwendung der internen Verkehrsrichtlinie des Dienstes
Um den Pod-Netzwerkverkehr auf einen Knoten zu beschränken, können Sie die interne Verkehrsrichtlinie des Dienstes verwenden Local, wird der Datenverkehr auf Endpunkte auf dem Knoten beschränkt, von dem der Datenverkehr stammt. Diese Richtlinie schreibt die ausschließliche Verwendung knotenlokaler Endpunkte vor. Das bedeutet, dass Ihre mit dem Netzwerkverkehr verbundenen Kosten für diesen Workload niedriger sein werden, als wenn die Verteilung clusterweit erfolgen würde. Außerdem wird die Latenz geringer sein, wodurch Ihre Anwendung leistungsfähiger wird.
Anmerkung
Es ist wichtig zu beachten, dass diese Funktion nicht mit topologiebewusstem Routing in Kubernetes kombiniert werden kann.

Im Folgenden finden Sie einen Codeausschnitt zur Festlegung der internen Verkehrsrichtlinie für einen Dienst.
apiVersion: v1
kind: Service
metadata:
  name: orders-service
  namespace: ecommerce
spec:
  selector:
    app: orders
  type: ClusterIP
  ports:

* protocol: TCP
port: 3003
targetPort: 3003
  internalTrafficPolicy: Local
Um ein unerwartetes Verhalten Ihrer Anwendung aufgrund von Datenverkehrseinbußen zu vermeiden, sollten Sie die folgenden Ansätze in Betracht ziehen:
-
Führen Sie genügend Replikate für jeden der kommunizierenden Pods aus
-
Sorgen Sie mithilfe von Einschränkungen der Topologieverteilung für eine relativ gleichmäßige Verteilung der Pods
-
Verwenden Sie Pod-Affinitätsregeln
für die gemeinsame Platzierung kommunizierender Pods
In diesem Beispiel haben Sie 2 Replikate von Microservice A und 3 Replikate von Microservice B. Wenn die Replikate von Microservice A auf Knoten 1 und 2 verteilt sind und Microservice B alle 3 Replikate auf Knoten 3 hat, können sie aufgrund der internen Datenverkehrsrichtlinie nicht kommunizieren. Local Wenn keine knotenlokalen Endpunkte verfügbar sind, wird der Datenverkehr unterbrochen.

Wenn Microservice B 2 seiner 3 Replikate auf den Knoten 1 und 2 hat, findet eine Kommunikation zwischen den Peer-Anwendungen statt. Sie hätten jedoch immer noch ein isoliertes Replikat von Microservice B ohne Peer-Replikat, mit dem Sie kommunizieren könnten.

Anmerkung
In einigen Szenarien ist ein isoliertes Replikat wie das im obigen Diagramm dargestellte möglicherweise kein Grund zur Besorgnis, wenn es dennoch einen Zweck erfüllt (z. B. die Bearbeitung von Anfragen von eingehendem externen Datenverkehr).
Verwendung der dienstinternen Verkehrsrichtlinie mit Einschränkungen der Topologieverteilung
Die Verwendung der internen Verkehrsrichtlinie in Verbindung mit Topologiestreuungsbeschränkungen kann hilfreich sein, um sicherzustellen, dass Sie über die richtige Anzahl von Replikaten für die Kommunikation zwischen Microservices auf verschiedenen Knoten verfügen.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: express-test
spec:
  replicas: 6
  selector:
    matchLabels:
      app: express-test
  template:
    metadata:
      labels:
        app: express-test
        tier: backend
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: "topology.kubernetes.io/zone"
        whenUnsatisfiable: ScheduleAnyway
        labelSelector:
          matchLabels:
            app: express-test
Verwendung der dienstinternen Verkehrsrichtlinie mit Pod-Affinitätsregeln
Ein anderer Ansatz besteht darin, bei der Verwendung der dienstinternen Verkehrsrichtlinie die Pod-Affinitätsregeln zu verwenden. Mit der Pod-Affinität können Sie den Scheduler so beeinflussen, dass er bestimmte Pods aufgrund ihrer häufigen Kommunikation am selben Standort aufteilt. Wenn Sie auf bestimmte Pods strenge Planungsbeschränkungen (requiredDuringSchedulingIgnoredDuringExecution) anwenden, erzielen Sie bessere Ergebnisse bei der Pod-Zusammenlegung, wenn der Scheduler Pods auf Knoten platziert.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: graphql
  namespace: ecommerce
  labels:
    app.kubernetes.io/version: "0.1.6"
    ...
    spec:
      serviceAccountName: graphql-service-account
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
Kommunikation zwischen Load Balancer und Pod
EKS-Workloads werden in der Regel von einem Load Balancer unterstützt, der den Datenverkehr an die entsprechenden Pods in Ihrem EKS-Cluster verteilt. Ihre Architektur kann interne, nach and/or außen gerichtete Load Balancer umfassen. Abhängig von Ihrer Architektur und den Konfigurationen des Netzwerkverkehrs kann die Kommunikation zwischen Load Balancern und Pods einen erheblichen Beitrag zu den Datenübertragungsgebühren leisten.
Sie können den AWS Load Balancer Controller verwenden,
Wenn Sie den Instanzmodus verwenden, NodePort wird auf jedem Knoten in Ihrem EKS-Cluster ein geöffnet. Der Load Balancer leitet dann den Datenverkehr gleichmäßig über die Knoten weiter. Wenn auf einem Knoten der Ziel-Pod läuft, fallen keine Datenübertragungskosten an. Befindet sich der Ziel-Pod jedoch auf einem anderen Knoten und in einer anderen AZ als der, der den Verkehr NodePort empfängt, erfolgt ein zusätzlicher Netzwerksprung vom Kube-Proxy zum Ziel-Pod. In einem solchen Szenario fallen Gebühren für die AZ-übergreifende Datenübertragung an. Aufgrund der gleichmäßigen Verteilung des Datenverkehrs auf die Knoten ist es sehr wahrscheinlich, dass im Zusammenhang mit zonenübergreifenden Netzwerk-Traffic-Hops von Kube-Proxys zu den entsprechenden Ziel-Pods zusätzliche Datenübertragungsgebühren anfallen.
Das folgende Diagramm zeigt einen Netzwerkpfad für den Datenverkehr, der vom Load Balancer zum und anschließend vom zum NodePort Ziel-Pod auf einem separaten kube-proxy Knoten in einem anderen AZ fließt. Dies ist ein Beispiel für die Einstellung des Instanzmodus.

Bei Verwendung des IP-Modus wird der Netzwerkverkehr vom Load Balancer direkt zum Ziel-Pod weitergeleitet. Daher fallen bei diesem Ansatz keine Gebühren für die Datenübertragung an.
Anmerkung
Es wird empfohlen, dass Sie Ihren Load Balancer auf den IP-Verkehrsmodus einstellen, um die Datenübertragungsgebühren zu senken. Für dieses Setup ist es auch wichtig, sicherzustellen, dass Ihr Load Balancer in allen Subnetzen Ihrer VPC bereitgestellt wird.
Das folgende Diagramm zeigt die Netzwerkpfade für den Datenverkehr, der vom Load Balancer zu den Pods im Netzwerk-IP-Modus fließt.

Datenübertragung aus Container Registry
Amazon ECR
Die Datenübertragung in das private Amazon ECR-Register ist kostenlos. In-region Für die Datenübertragung fallen keine Kosten an, aber für Datenübertragungen ins Internet und zwischen Regionen werden auf beiden Seiten der Übertragung die Tarife für Internet-Datenübertragungen berechnet.
Sie sollten die in ECRs integrierte Bildreplikationsfunktion verwenden, um die relevanten Container-Images in dieselbe Region wie Ihre Workloads zu replizieren. Auf diese Weise würde die Replikation einmal berechnet, und alle Image-Abrufe derselben Region (innerhalb einer Region) wären kostenlos.
Sie können die mit dem Abrufen von Bildern aus dem ECR (ausgehenden Datentransfer) verbundenen Datenübertragungskosten weiter reduzieren, indem Sie Schnittstellen-VPC-Endpunkte verwenden, um eine Verbindung zu den ECR-Repositorys in der Region herzustellen. Der alternative Ansatz, eine Verbindung zum öffentlichen AWS-Endpunkt von ECR herzustellen (über ein NAT-Gateway und ein Internet-Gateway), verursacht höhere Datenverarbeitungs- und Übertragungskosten. Im nächsten Abschnitt wird die Reduzierung der Datenübertragungskosten zwischen Ihren Workloads und den AWS-Services ausführlicher behandelt.
Wenn Sie Workloads mit besonders großen Images ausführen, können Sie Ihre eigenen benutzerdefinierten Amazon Machine Images (AMIs) mit vorab zwischengespeicherten Container-Images erstellen. Dadurch können die anfängliche Image-Abrufzeit und die potenziellen Kosten für die Datenübertragung von einer Container-Registry zu den EKS-Worker-Knoten reduziert werden.
Datenübertragung zu & AWS-Services im Internet
Es ist üblich, Kubernetes-Workloads über das Internet in andere AWS-Services oder Tools und Plattformen von Drittanbietern zu integrieren. Die zugrunde liegende Netzwerkinfrastruktur, die für die Weiterleitung des Datenverkehrs zum und vom jeweiligen Ziel verwendet wird, kann sich auf die Kosten auswirken, die beim Datenübertragungsprozess anfallen.
Verwendung von NAT-Gateways
NAT-Gateways sind Netzwerkkomponenten, die eine Netzwerkadressübersetzung (NAT) durchführen. Das folgende Diagramm zeigt Pods in einem EKS-Cluster, die mit anderen AWS-Services (Amazon ECR, DynamoDB und S3) und Plattformen von Drittanbietern kommunizieren. In diesem Beispiel werden die Pods in privaten Subnetzen in separaten AZs ausgeführt. Um Datenverkehr aus dem Internet zu senden und zu empfangen, wird ein NAT-Gateway im öffentlichen Subnetz einer AZ bereitgestellt, sodass alle Ressourcen mit privaten IP-Adressen eine einzige öffentliche IP-Adresse für den Zugriff auf das Internet gemeinsam nutzen können. Dieses NAT-Gateway wiederum kommuniziert mit der Internet-Gateway-Komponente, sodass Pakete an ihr endgültiges Ziel gesendet werden können.
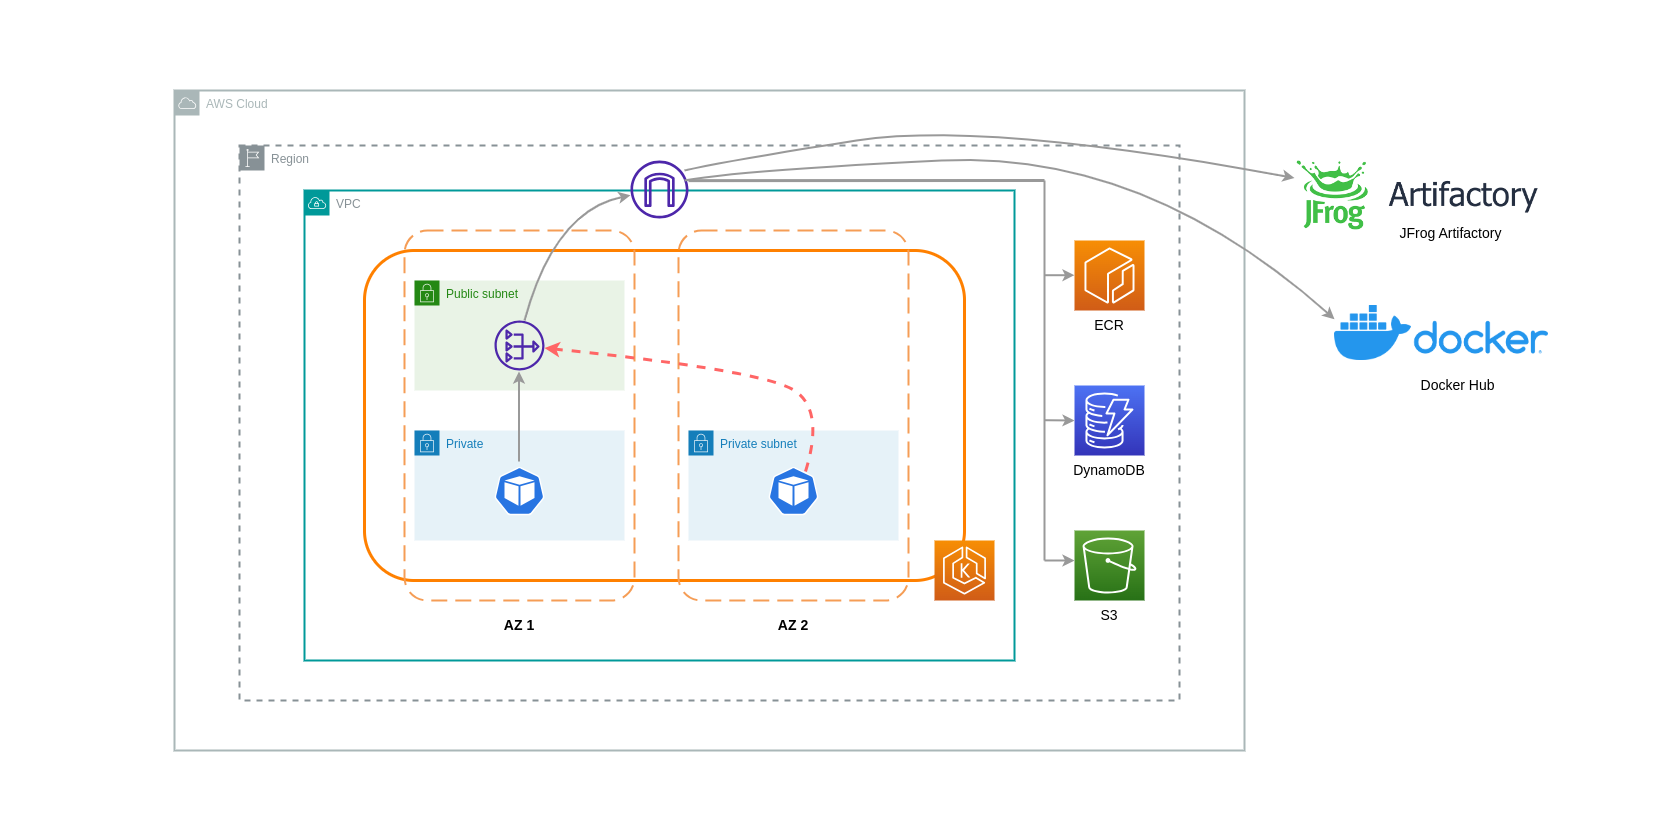
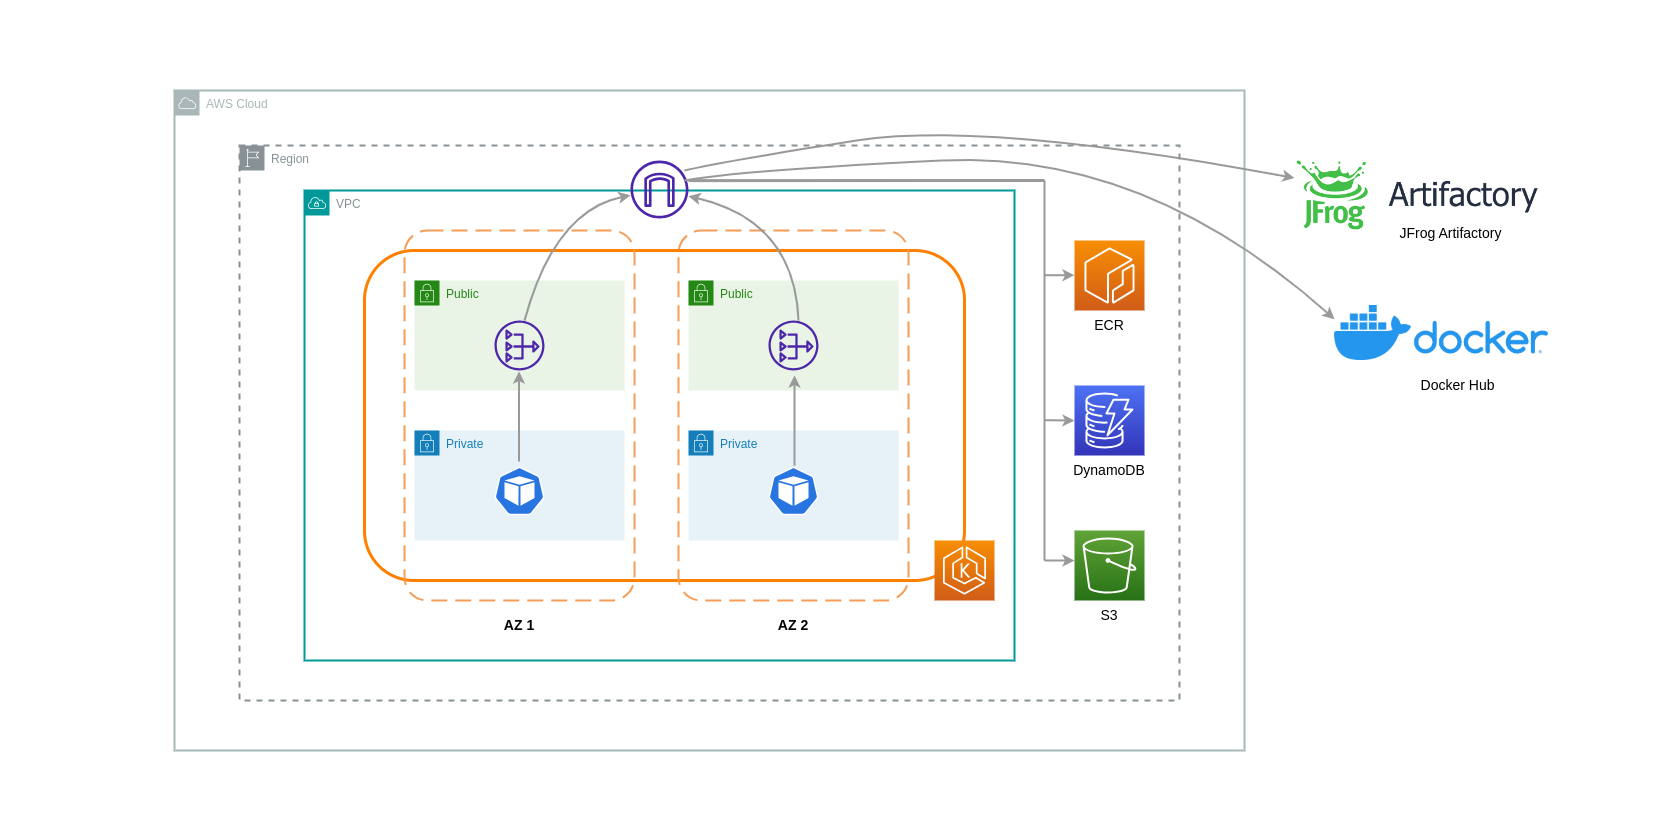
Wenn Sie NAT-Gateways für solche Anwendungsfälle verwenden, können Sie die Datenübertragungskosten minimieren, indem Sie in jeder AZ ein NAT-Gateway bereitstellen. Auf diese Weise wird der zum Internet geleitete Datenverkehr über das NAT-Gateway in derselben AZ geleitet, wodurch eine Datenübertragung zwischen den AZ vermieden wird. Obwohl Sie die Kosten für die Datenübertragung zwischen AZ sparen, hat diese Konfiguration zur Folge, dass Ihnen die Kosten für ein zusätzliches NAT-Gateway in Ihrer Architektur entstehen.
Dieser empfohlene Ansatz ist in der folgenden Abbildung dargestellt.
Verwenden eines VPC-Endpunkts
Um die Kosten in solchen Architekturen weiter zu senken, sollten Sie VPC-Endpunkte verwenden, um die Konnektivität zwischen Ihren Workloads und AWS-Services herzustellen. Mit VPC-Endpunkten können Sie von einer VPC aus auf AWS-Services zugreifen, ohne dass Pakete das Internet durchqueren. data/network Der gesamte Datenverkehr ist intern und verbleibt innerhalb des AWS-Netzwerks. Es gibt zwei Arten von VPC-Endpunkten: Schnittstellen-VPC-Endpunkte (von vielen AWS-Services unterstützt) und Gateway-VPC-Endpunkte (nur von S3 und DynamoDB unterstützt).
Gateway-VPC-Endpunkte
Mit Gateway-VPC-Endpunkten fallen keine Stunden- oder Datenübertragungskosten an. Bei der Verwendung von Gateway-VPC-Endpunkten ist zu beachten, dass sie nicht über VPC-Grenzen hinaus erweiterbar sind. Sie können nicht für VPC-Peering, VPN-Netzwerke oder über Direct Connect verwendet werden.
Schnittstelle: VPC-Endpunkte
Für VPC-Endpunkte fällt eine stündliche Gebühr
Das folgende Diagramm zeigt Pods, die über VPC-Endpunkte mit AWS-Services kommunizieren.

Datenübertragung zwischen VPCs
In einigen Fällen haben Sie möglicherweise Workloads in verschiedenen VPCs (innerhalb derselben AWS-Region), die miteinander kommunizieren müssen. Dies kann erreicht werden, indem der Datenverkehr über Internet-Gateways, die an die jeweiligen VPCs angeschlossen sind, das öffentliche Internet durchquert. Eine solche Kommunikation kann durch den Einsatz von Infrastrukturkomponenten wie EC2-Instances, NAT-Gateways oder NAT-Instances in öffentlichen Subnetzen ermöglicht werden. Bei einer Konfiguration, die diese Komponenten umfasst, fallen jedoch Gebühren für processing/transferring Daten an, die in die VPCs ein- und ausgehen. Wenn der Datenverkehr zu und von den einzelnen VPCs über AZs übertragen wird, fallen für die Datenübertragung zusätzliche Gebühren an. Das folgende Diagramm zeigt ein Setup, das NAT-Gateways und Internet-Gateways verwendet, um die Kommunikation zwischen Workloads in verschiedenen VPCs herzustellen.

VPC-Peering-Verbindungen
Um die Kosten für solche Anwendungsfälle zu senken, können Sie VPC-Peering verwenden. Bei einer VPC-Peering-Verbindung fallen keine Datenübertragungsgebühren für den Netzwerkverkehr an, der innerhalb derselben AZ bleibt. Wenn der Verkehr AZs überquert, fallen Kosten an. Nichtsdestotrotz wird der VPC-Peering-Ansatz für eine kostengünstige Kommunikation zwischen Workloads in separaten VPCs innerhalb derselben AWS-Region empfohlen. Es ist jedoch wichtig zu beachten, dass VPC-Peering in erster Linie für 1:1 -VPC-Konnektivität effektiv ist, da es keine transitiven Netzwerke ermöglicht.
Das folgende Diagramm ist eine allgemeine Darstellung der Workload-Kommunikation über eine VPC-Peering-Verbindung.

Transitive Netzwerkverbindungen
Wie im vorherigen Abschnitt erwähnt, ermöglichen VPC-Peering-Verbindungen keine transitive Netzwerkkonnektivität. Wenn Sie 3 oder mehr VPCs mit transitiven Netzwerkanforderungen verbinden möchten, sollten Sie ein Transit Gateway (TGW) verwenden. Auf diese Weise können Sie die Grenzen des VPC-Peering oder den Betriebsaufwand überwinden, der mit mehreren VPC-Peering-Verbindungen zwischen mehreren VPCs verbunden ist. Die Abrechnung erfolgt auf Stundenbasis
Das folgende Diagramm zeigt den Inter-AZ-Verkehr, der durch ein TGW zwischen Workloads in verschiedenen VPCs, aber innerhalb derselben AWS-Region fließt.

Verwenden eines Service Mesh
Service Meshes bieten leistungsstarke Netzwerkfunktionen, mit denen Sie die netzwerkbezogenen Kosten in Ihren EKS-Cluster-Umgebungen senken können. Sie sollten jedoch sorgfältig die betrieblichen Aufgaben und die Komplexität abwägen, die ein Service Mesh in Ihrer Umgebung mit sich bringt, wenn Sie eines einführen.
Beschränkung des Datenverkehrs auf Availability Zones
Verwendung der nach Orten gewichteten Verteilung von Istio
Mit Istio können Sie Netzwerkrichtlinien auf den Verkehr anwenden, nachdem das Routing erfolgt ist. Dies erfolgt mithilfe von Zielregeln
Anmerkung
Bevor Sie die örtlich gewichtete Verteilung implementieren, sollten Sie sich zunächst mit Ihren Netzwerkverkehrsmustern und den Auswirkungen vertraut machen, die die Zielregelrichtlinie auf das Verhalten Ihrer Anwendung haben kann. Daher ist es wichtig, über verteilte Verfolgungsmechanismen mit Tools wie AWS X-Ray
Die oben aufgeführten Istio-Zielregeln können auch angewendet werden, um den Datenverkehr von einem Load Balancer zu Pods in Ihrem EKS-Cluster zu verwalten. Lokalitätsgewichtete Verteilungsregeln können auf einen Dienst angewendet werden, der Datenverkehr von einem hochverfügbaren Load Balancer (insbesondere dem Ingress Gateway) empfängt. Mit diesen Regeln können Sie anhand seines zonalen Ursprungs — in diesem Fall des Load Balancers — steuern, wie viel Traffic wohin fließt. Bei richtiger Konfiguration fällt im Vergleich zu einem Load Balancer, der den Datenverkehr gleichmäßig oder zufällig auf Pod-Replikate in verschiedenen AZs verteilt, weniger zonenübergreifend an.
Unten finden Sie ein Codeblock-Beispiel für eine Zielregelressource in Istio. Wie unten zu sehen ist, spezifiziert diese Ressource gewichtete Konfigurationen für eingehenden Verkehr von 3 verschiedenen AZs in der eu-west-1 Region. Diese Konfigurationen legen fest, dass ein Großteil des eingehenden Datenverkehrs (in diesem Fall 70%) von einer bestimmten AZ an ein Ziel in derselben AZ weitergeleitet werden sollte, von der er stammt.
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: express-test-dr
spec:
  host: express-test.default.svc.cluster.local
  trafficPolicy:
    loadBalancer:                      +
      localityLbSetting:
        distribute:
        - from: eu-west-1/eu-west-1a/  +
          to:
            "eu-west-1/eu-west-1a/_": 70
            "eu-west-1/eu-west-1b/_": 20
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1b/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 70
            "eu-west-1/eu-west-1c/_": 10
        - from: eu-west-1/eu-west-1c/_  +
          to:
            "eu-west-1/eu-west-1a/_": 20
            "eu-west-1/eu-west-1b/_": 10
            "eu-west-1/eu-west-1c/*": 70**
    connectionPool:
      http:
        http2MaxRequests: 10
        maxRequestsPerConnection: 10
    outlierDetection:
      consecutiveGatewayErrors: 1
      interval: 1m
      baseEjectionTime: 30s
Anmerkung
Das Mindestgewicht, das an ein Ziel verteilt werden kann, beträgt 1%. Der Grund dafür ist die Beibehaltung der Failover-Regionen und -Zonen für den Fall, dass die Endpunkte im Hauptziel nicht mehr funktionieren oder nicht verfügbar sind.
Das folgende Diagramm zeigt ein Szenario, in dem in der Region EU-West-1 ein hochverfügbarer Load Balancer vorhanden ist und die örtlich gewichtete Verteilung angewendet wird. Die Zielregelrichtlinie für dieses Diagramm ist so konfiguriert, dass 60% des Datenverkehrs von eu-west-1a an Pods in derselben AZ weitergeleitet werden, wohingegen 40% des Datenverkehrs von eu-west-1a an Pods in eu-west-1b gehen sollten.

Beschränkung des Datenverkehrs auf Verfügbarkeitszonen und Knoten
Verwendung der dienstinternen Verkehrsrichtlinie mit Istio
Um die Netzwerkkosten im Zusammenhang mit externem eingehendem Datenverkehr und internem Verkehr zwischen Pods zu senken, können Sie die Zielregeln von Istio mit der internen Datenverkehrsrichtlinie von Kubernetes Service kombinieren. Die Art und Weise, wie die Istio-Zielregeln mit der internen Verkehrsrichtlinie des Dienstes kombiniert werden, hängt weitgehend von drei Dingen ab:
-
Die Rolle der Microservices
-
Muster des Netzwerkverkehrs in den Microservices
-
Wie sollten die Microservices in der Kubernetes-Clustertopologie bereitgestellt werden
Das folgende Diagramm zeigt, wie der Netzwerkfluss im Falle einer verschachtelten Anfrage aussehen würde und wie die oben genannten Richtlinien den Datenverkehr steuern würden.

-
Der Endbenutzer stellt eine Anfrage an APP A, die wiederum eine verschachtelte Anfrage an APP C sendet. Diese Anfrage wird zuerst an einen hochverfügbaren Load Balancer gesendet, der Instances in AZ 1 und AZ 2 hat, wie das obige Diagramm zeigt.
-
Die externe eingehende Anfrage wird dann vom Istio Virtual Service an das richtige Ziel weitergeleitet.
-
Nachdem die Anfrage weitergeleitet wurde, steuert die Istio-Zielregel, wie viel Verkehr an die jeweiligen AZs weitergeleitet wird, je nachdem, woher er stammt (AZ 1 oder AZ 2).
-
Der Datenverkehr geht dann an den Service für APP A und wird dann an die jeweiligen Pod-Endpunkte weitergeleitet. Wie im Diagramm dargestellt, werden 80% des eingehenden Datenverkehrs an Pod-Endpunkte in AZ 1 gesendet, und 20% des eingehenden Datenverkehrs werden an AZ 2 gesendet.
-
APP A stellt dann eine interne Anfrage an APP C. Für den Dienst von APP C ist eine interne Verkehrsrichtlinie aktiviert (
internalTrafficPolicy`: Lokal`). -
Die interne Anfrage von APP A (auf NODE 1) an APP C ist aufgrund des verfügbaren knotenlokalen Endpunkts für APP C erfolgreich.
-
Die interne Anfrage von APP A (auf KNOTEN 3) an APP C schlägt fehl, da keine knotenlokalen Endpunkte für APP C verfügbar sind. Wie das Diagramm zeigt, hat APP C keine Replikate auf NODE 3. * *
Die folgenden Screenshots stammen aus einem Live-Beispiel für diesen Ansatz. Die ersten Screenshots zeigen eine erfolgreiche externe Anforderung an eine graphql und eine erfolgreiche verschachtelte Anfrage von der graphql an ein gemeinsames orders Replikat auf dem Knoten. ip-10-0-0-151.af-south-1.compute.internal

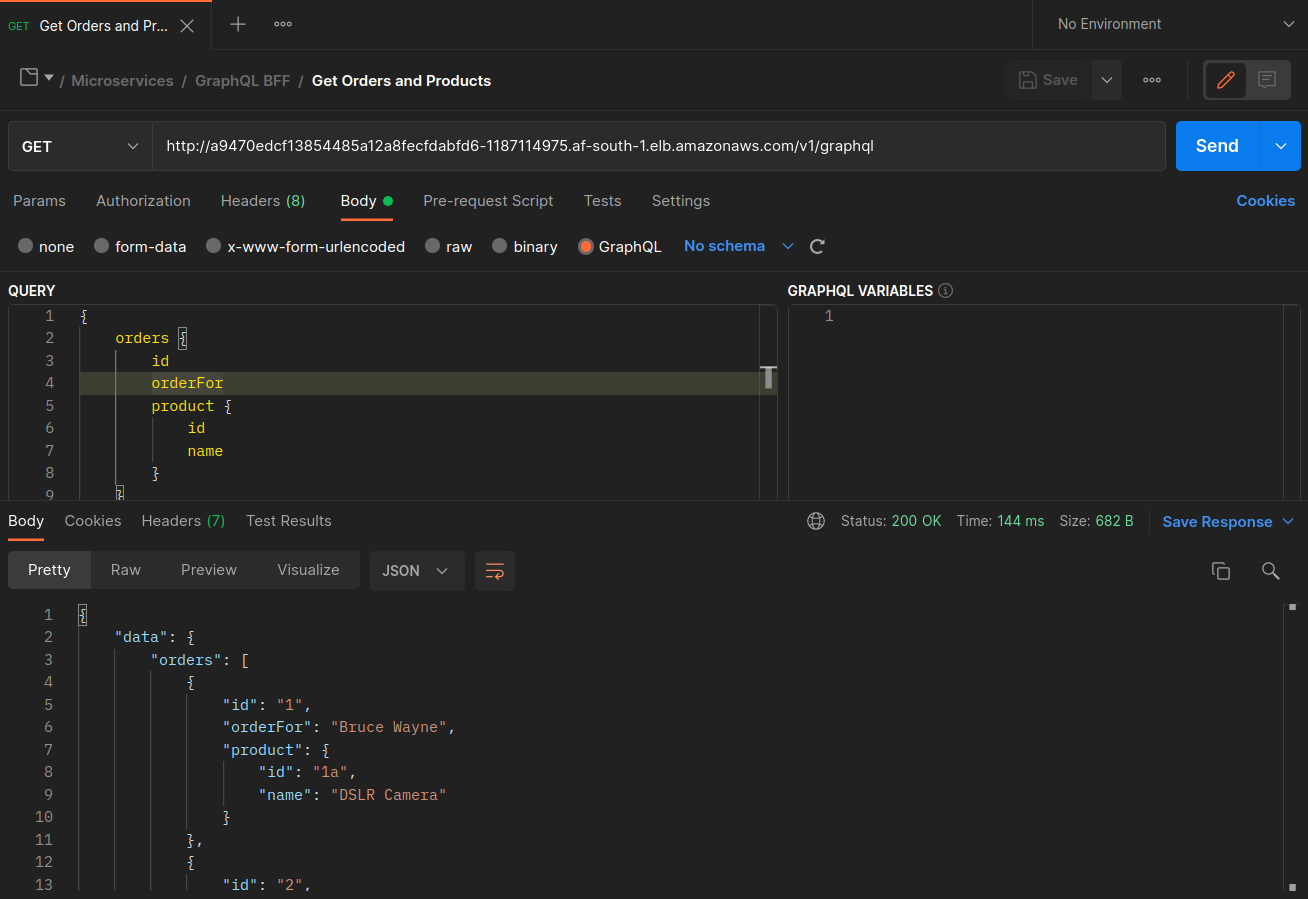
Mit Istio können Sie die Statistiken aller Upstream-Cluster und Endpunkte überprüfen orders Endpunkte, die dem graphql Proxy bekannt sind, mit dem folgenden Befehl abgerufen werden:
kubectl exec -it deploy/graphql -n ecommerce -c istio-proxy -- curl localhost:15000/clusters | grep orders
...
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_error::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_success::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_timeout::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_total::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**health_flags::healthy**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**region::af-south-1**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**zone::af-south-1b**
...
In diesem Fall kennt der graphql Proxy nur den orders Endpunkt für das Replikat, mit dem er sich einen Knoten teilt. Wenn Sie die internalTrafficPolicy: Local Einstellung aus dem Orders Service entfernen und einen Befehl wie den oben genannten erneut ausführen, geben die Ergebnisse alle Endpunkte der Replikate zurück, die auf die verschiedenen Knoten verteilt sind. Wenn Sie die rq_total nach den jeweiligen Endpunkten untersuchen, werden Sie außerdem feststellen, dass der Anteil an der Netzwerkverteilung relativ gleichmäßig ist. Wenn die Endpunkte also Upstream-Diensten zugeordnet sind, die in verschiedenen AZs ausgeführt werden, führt diese zonenübergreifende Netzwerkverteilung zu höheren Kosten.
Wie in einem früheren Abschnitt weiter oben erwähnt, können Sie häufig kommunizierende Pods zusammenstellen, indem Sie die Pod-Affinität nutzen.
...
spec:
...
  template:
    metadata:
      labels:
        app: graphql
        role: api
        workload: ecommerce
    spec:
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - orders
            topologyKey: "kubernetes.io/hostname"
      nodeSelector:
        managedBy: karpenter
        billing-team: ecommerce
...
Wenn die graphql und die orders Replikate nicht auf demselben Knoten (ip-10-0-0-151.af-south-1.compute.internal) koexistieren, graphql ist die erste Anfrage an erfolgreich, wie 200 response code im Postman-Screenshot unten vermerkt, wohingegen die zweite verschachtelte Anfrage von bis mit einem fehlschlägt. graphql orders 503 response code


Weitere Ressourcen
-
Behebung der Latenz- und Datenübertragungskosten auf EKS mithilfe von Istio
-
Verschaffen Sie sich einen Überblick über die Netzwerk-Bytes Ihres Amazon Cross-AZ EKS-Pods
-
Optimieren Sie den AZ-Verkehr mit topologieorientiertem Routing
-
Optimieren Sie die Kosten und Leistung von Kubernetes mit einer dienstinternen Verkehrsrichtlinie
-
Optimieren Sie die Kosten und Leistung von Kubernetes mit Istio und Service Internal Traffic Policy
-
Überblick über die Datenübertragungskosten für gängige Architekturen
-
Grundlegendes zu den Datenübertragungskosten für AWS-Containerdienste
